HTTP服务器处理拆包粘包,不是让一次recv刚好对应一个HTTP请求,而是把TCP字节流放进可累积缓冲区,按HTTP协议的消息边界循环解析;读到完整消息才交给业务层,剩余字节留到下一次读事件继续拼。 把TCP读事件当消息边界,是多数“粘包”故障的起点。
HTTP服务器拆包粘包怎么解决:先把字节流当字节流
TCP只保证字节有序到达,不保证一次读取等于一条消息,HTTP服务器要做的事很具体:在缓冲区里找消息边界,HTTP/1.1的边界来自Content-Length或Transfer-Encoding: chunked;HTTP/2来自帧头里的长度字段;HTTP/3跑在QUIC流上,但HTTP/3帧仍要按帧长解析(据IETF RFC 9112、RFC 9113规范)。
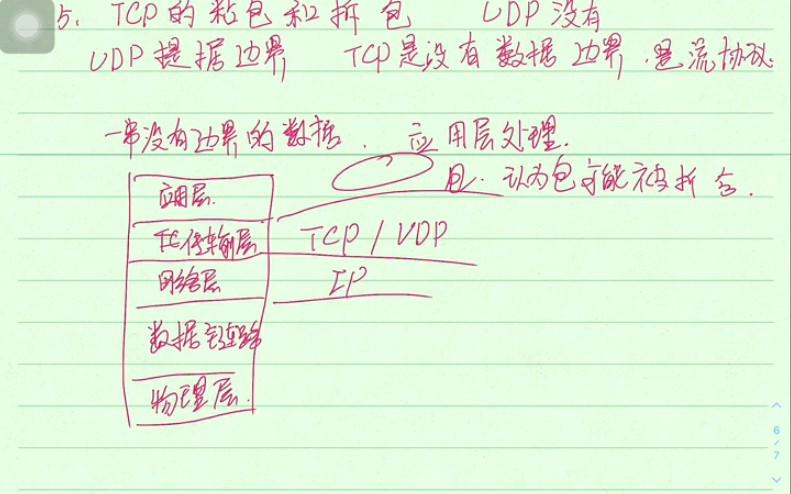
TCP粘包和HTTP拆包有什么区别
很多人把两个词混着用,区别在于:
- TCP粘包:发送方连续写多条消息,接收方一次读到多段数据,TCP本身没有消息概念,这是正常现象。
- HTTP拆包:一条HTTP请求或响应跨多个TCP段到达,服务端只读到前半截,HTTP有明确边界规则,拆包”不是协议缺陷,是读取时机问题。
- HTTP粘包:在keep-alive连接上,多个HTTP请求连续到达,服务端一次读到了请求A的尾部加请求B的头部,处理方式是循环解析,不是丢弃。
业内专家指出,不少线上“粘包”其实是业务代码把一次read当成了一个完整请求,后面再把缓冲区里的剩余字节当垃圾清掉,问题就出现了。
为什么HTTP/1.1的keep-alive更容易出现“粘包”现象
短连接下,连接关闭本身能辅助判断消息结束,开启keep-alive后,连接不复用关闭信号,服务端必须依赖HTTP自己的边界,常见场景:
- 客户端连续发两个GET请求,第二个请求的起始行紧跟在第一个请求头后面。
- POST请求体较大,TCP分成多个段到达,服务端头部已读完,消息体还没读够。
- 代理或中间设备把多个小请求合并发送,抓包看到一段数据里出现两个
GET。
这时服务端不能“读一次就处理一次”,正确动作是:把新读到的字节追加到连接缓冲区,然后循环调用解析器,直到缓冲区里没有完整消息为止。
高并发场景下HTTP拆包粘包处理方案
高并发下,拆包粘包处理的重点不是“缓冲区开多大”,而是解析状态是否可恢复、内存是否可控、超时是否明确,成熟HTTP服务器通常用状态机加连接级缓冲区,而不是睡眠等待或反复字符串查找。
状态机+缓冲区:HTTP/1.1解析的标准做法
一个可落地的解析流程如下:
- 连接建立后分配读缓冲区,初始容量不宜过大。
- 读事件到达时,把字节追加到缓冲区,记录当前解析位置。
- 解析请求行和头部,一直读到CRLFCRLF为止;头部不完整就返回“继续读”。
- 解析头部字段,判断消息体边界:有
Content-Length就按长度读够;有Transfer-Encoding: chunked就逐块解析。 - 消息完整后交给路由或业务层,同时从缓冲区移除已消费字节。
- 缓冲区里还有剩余字节,继续循环解析下一条消息。
- 没有完整消息就保留剩余字节,等待下一次读事件。
关键点是“解析位置可恢复”,不能每次读事件都从头扫描整个缓冲区,否则高并发下CPU会被无谓消耗。
请求行与头部:读到CRLFCRLF为止
HTTP/1.1头部结束标记是CRLFCRLF,服务端要做的是:
- 设置最大头部长度,例如Nginx的
large_client_header_buffers 4 8k;。 - 超过限制直接返回431或400,避免慢速攻击把内存拖满。
- 头部字段名大小写不敏感,
Content-Length和content-length要同等处理。 - 出现多个冲突的
Content-Length时拒绝请求,不要猜。
消息体:Content-Length与chunked两条路径
- Content-Length:头部给出字节数,服务端读够指定长度才算完整,读少了是拆包,读多了要把多余字节留给下一个请求。
- chunked:先读块大小行,再读块数据加CRLF,循环到0\r\n\r\n结束,块大小是十六进制,别按十进制解析。
- 两者同时出现或格式非法时,按协议拒绝,不要“尽量兼容”。
HTTP/2和HTTP/3的边界处理不同
HTTP/2不再靠Content-Length切请求,而是靠帧,帧头固定9字节,长度字段24位,服务端先读帧头,再按长度读帧负载,跨TCP段时累积到帧完整,HTTP/3基于QUIC,流提供可靠有序字节流,但HTTP/3消息仍由帧组成,解析器仍要按帧长处理。
| 协议场景 | 边界来源 | 服务端动作 | 常见坑 |
|---|---|---|---|
| HTTP/1.1短连接 | 连接关闭+头部/长度 | 读完整消息后处理 | 把关闭当唯一边界 |
| HTTP/1.1 keep-alive | Content-Length或chunked | 循环解析缓冲区 | 一次读取当一条请求 |
| HTTP/2 | 帧头长度字段 | 先读9字节帧头再读负载 | 跨帧累积错位 |
| HTTP/3 | QUIC流+HTTP/3帧 | 按帧长解析流数据 | 把流当消息边界 |
实操排查:从抓包到Nginx参数
在华东地区机房做HTTP服务器拆包粘包排查时,链路MTU和中间设备行为会让分段大小变化,不能只看单次抓包,排查步骤可以落地:
- 抓包:
tcpdump -i eth0 -nn -A -s 0 'tcp port 8080' -w http.pcap - 看流:用Wireshark的Follow TCP Stream观察是否一段数据里出现两个请求行。
- 复现:
curl --http1.1 -v --raw -H 'Connection: keep-alive' http://host:8080/a http://host:8080/b - 查Nginx:
client_header_buffer_size 1k; large_client_header_buffers 4 8k; client_max_body_size 10m; client_body_buffer_size 128k; keepalive_timeout 65;这些参数不负责切消息,但决定半包能等多久、头部能放多大。 - 查应用:Go的
net/http、Netty的HttpServerCodec加HttpObjectAggregator、Java Servlet容器都已处理边界;自定义TCP服务不要用conn.Read直接当请求。
HTTP拆包粘包处理方案价格差异在哪
价格差异通常不在“写一个解析函数”,而在边界覆盖和排障成本:
- 只支持
Content-Length,成本低,但chunked、HTTP/2、超时清理都要另补。 - 自研状态机要覆盖慢速攻击、头部超限、消息体超限、连接复用、错误响应。
- 用成熟框架省解析代码,但需要理解框架的聚合上限和内存策略。
- 压测和线上抓包排障的投入,往往比首版代码更高。
收束:边界规则比缓冲区大小更重要
HTTP服务器处理拆包粘包,靠的是协议边界加可恢复状态机,不是把缓冲区调大,把“读事件”和“消息”分开,循环解析、保留剩余、限制上限,故障就会少很多。
HTTP服务器拆包粘包Q&A
HTTP服务器拆包粘包一定要自己写解析器吗?
不一定,Go的net/http、Netty的HTTP编解码器、Nginx和主流Servlet容器都已实现消息边界解析,只有自定义TCP协议或改造底层接入层时,才需要自己维护状态机和缓冲区。
HTTP/1.1和HTTP/2的拆包处理能共用一套代码吗?
不能直接共用,HTTP/1.1按头部和消息体规则切分,HTTP/2先读9字节帧头再按24位长度读负载,两者可以共用连接缓冲区和读事件循环,但帧解析层要分开。
HTTP服务器拆包粘包处理成本高吗?
成本主要取决于边界覆盖范围、自研解析器的测试量、压测和线上排障投入;使用成熟框架时,多数常见边界场景已经由框架处理,成本集中在参数配置和异常流量防护上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/804641.html