智能推理服务器并非单一产品,而是按部署形态、计算架构和算力规模划分的完整家族,主要包含GPU通用推理服务器、专用ASIC推理服务器、CPU/NPU轻量推理服务器以及云原生推理实例四大类。选型时,你的业务场景、并发量、模型大小和预算决定该选哪一类,而不是盲目追新。
智能推理服务器的主流形态与核心分类
业内专家指出,当前推理市场正从“训练型通用硬件”向“推理专用算力”快速迁移,搞清楚有哪些智能推理服务器,本质是搞清楚算力怎么匹配业务。
GPU推理服务器:当前的主流选择
GPU依然是绝大多数企业部署推理的首选,因为生态成熟、兼容性最好。
- NVIDIA A100/A800系列:适合大模型的批量推理和高并发场景,常被用于部署70B以上参数模型,目前仍是中大型企业的“压舱石”。
- NVIDIA L40S/RTX 4090系列:L40S算作“性价比之王”,常见于中小企业的私有化部署;RTX 4090多用于开发测试环境或小微企业起步阶段。
- 华为昇腾Atlas系列:910B和310P推理卡在政企和国产化要求严格的行业应用广泛,近年来,随着国内大模型落地提速,昇腾推理生态已相当成熟。
专用ASIC推理服务器:为降本增效而生
当你的业务场景固定、模型结构不再频繁变动,专用ASIC芯片能带来显著的性价比提升。
- Google TPU(Cloud TPU v5e):在云端按需使用,适合那些任务类型单一、吞吐量极大的搜索或推荐类业务。
- Groq LPU推理服务器:以极低的延迟著称,特别适合需要实时响应的AI Agent应用,不过它在复杂模型支持上还有局限。
- 各家自研的NPU/ASIC:包括百度的昆仑芯、阿里的平头哥,这些服务器通常与自家云服务深度绑定,不单独面向外部销售硬件。
CPU与纯内存推理服务器:轻量级场景的补充
不是所有推理都需要GPU,行业共识认为,约有三成左右的推理任务用CPU就能搞定。
多路志强或EPYC处理器配上大容量DDR5内存,适合以下场景:自然语言处理的文本分类、小规模意图识别、传统机器学习模型,这类服务器价格低、运维简单,但处理长文本和多轮对话时延迟较高。
AI推理服务器和训练服务器区别在哪
有不少用户咨询时会把这两个概念混为一谈,其实从硬件设计到网络拓扑,两者差异巨大。
硬件侧重点不同
推理服务器更关注内存带宽和低精度算力(FP16/INT8),而训练服务器更依赖高精度浮点算力(FP32/BF16)和卡间通信速度。
训练场景用NVLink全互联,推理场景则多半走PCIe总线加普通万兆网络即可,成本差异明显。
并发处理逻辑不同
训练服务器追求“把一个批次的数据算完”,推理服务器追求“同时响应成百上千个请求且延迟稳定”,所以推理服务器的设计更看重CPU调度能力、内存通道数和PCIe通道数分配。
实际选型时的常见误区
推理必须用比训练更强的卡,事实恰好相反,两三张A100或L40S可能还不如一张训练卡的性能指标好看,但在实际推理中的并发吞吐表现更理想。
算力越高推理越快,推理是带宽密集型任务,A100的算力利用率在纯推理场景往往不足训练时的一半,选对架构比选高算力卡更重要。
按场景怎么选智能推理服务器的解决方案
不同业务的取舍完全不同,这里直接给实操思路。
私有化部署的硬件配置方案
如果合规要求严格,必须部署在内部机房,优先选两条路线。
单卡入门方案:一张RTX 4090或L20,配上64GB内存的服务器,适合部署7B左右的模型,智能客服、电话外呼、资料总结都能对付,如果想了解商用GPU推理服务器的价格,这类方案整体成本可控,适合千万级营收以下的企业。
走多卡高并发路线的话,四卡L40S加100GB以上内存是近期咨询较多的配置之一,这一套可以在不低于此前部署方案体验的前提下跑70B模型的量化版,对此,国内部署的团队一般倾向于选择浪潮NF5688、宁畅X640等整机产品。
私有化部署的软件与算力调优
硬件只是第一步,部署后的调优往往决定最终体验,下面是一个典型操作路径。
- 选择合适的推理框架。vLLM凭借PagedAttention高效管理KV Cache,是目前部署大模型的首选;TGI(HuggingFace出的)适合快速原型验证;TensorRT-LLM适合追求极致性能的生产环境。
- 统一走INT8量化,业内共识认为,INT8量化在大多数场景下能将推理吞吐提升一倍以上,而模型质量损失几乎可以忽略,使用
trtllm-build配合--quantize int8_weight_only即可完成。 - 一定要配置动态批处理,在vLLM中开启
--max-num-seqs参数后进行压测,你会发现吞吐量有明显提升。
云端租用与混合架构思路
预算有限或业务弹性大时,不必一步到位买硬件。按需租用云上推理实例是很多团队的过渡方案,按量付费模式的好处是被打爆流量时不会直接击穿服务,能起到一定的熔断作用。
混合架构思路值得参考:核心私密数据用本地CPU小模型过滤,大流量通用问答走云上GPU实例,这种方案既守住安全底线,又把成本控制在一个相对合理的水平。
智能推理服务器部署的软硬件协同清单
一套好的推理系统,光看GPU是不够的,以下是几个容易被忽视的关键点。
硬件层面的检查清单
- CPU选型:推理节点建议选择AMD EPYC或Intel Xeon Platinum级别,核心数在32核以上,主频不低于2.8GHz,避免因CPU调度瓶颈拖累GPU利用率。
- 内存容量:单机建议内存至少是显存总和的5倍,多路对话场景下,KV Cache会吃掉大量CPU内存,备少了进程直接报OOM。
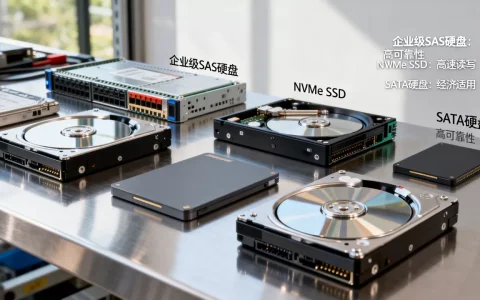
- 系统盘与数据盘分离:模型加载和推理缓存读写频繁,建议数据盘使用高吞吐的企业级SSD,避免与系统盘争抢IO。
推理性能基准测试
部署完成后,不要只看单次请求延迟,重点看以下指标:
- 吞吐量(Tokens/s):整个批处理过程中每秒产生的Token数
- 首个Token延迟(TTFT):用户发出请求到看到第一个字的时间,最好控制在300ms以内
- 端到端时延(TPOT):每个Token生成的间隔时间,决定流式输出是否“卡顿”
对于智能推理服务器技术选型,行业共识认为数据表格能直观反映规格差异,下表对比了三类常见场景的核心配置。
| 应用场景 | 常用GPU配置 | 参考CPU配置 | 参考内存容量 |
|---|---|---|---|
| 7B模型并发推理 | 1×L20或RTX 4090 | 16核以上 | 64GB及以上 |
| 70B模型私有化部署 | 4×L40S | 32核以上 | 256GB及以上 |
| 高并发Agent应用 | 8×A100或昇腾910B | 64核以上 | 512GB及以上 |
智能推理服务器的长期维护成本考量
购置成本只是开始,电费、维护和折旧才是大头,推理服务器的功耗通常比训练服务器低,但多卡机器的整机功耗依然惊人。
建议在硬件采购前先核算三年总拥有成本(TCO),例如一台四卡L40S服务器,整机功耗约2.5kW至3kW,在普通商业电价下,一年仅电费就可能超过2万元,如果业务并非全天候满载,那云上租用按量付费模式可能更具长期性价比,国内选择方案时,建议咨询本地服务商获取符合区域电价的具体测算数据。
智能推理服务器有哪些常见问题解答
智能推理服务器和普通服务器到底有什么本质差别?
主要区别在于计算架构和硬件形态,普通服务器以CPU算力为主,适合传统业务逻辑;推理服务器则搭载GPU、NPU或ASIC加速卡,专门为矩阵运算优化,面向大模型的神经网络推理场景,寿命周期上,普通服务器可用五到八年,推理服务器因为算力迭代快,通常三到四年就需要升级。
本地部署推理服务器和直接用云服务怎么选?
如果数据涉密且预算充足,建议本地部署,能满足合规要求,如果业务波动大或处于起步阶段,选择云GPU服务器更划算,云服务还提供自动扩缩容、监控告警等配套运维能力,省去自建机房的人力成本,等业务量稳定在较高水位时,再考虑自购硬件迁移,这样风险最小。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/805046.html