服务器多少算异常运行?直接给结论:不要盯单个数值,要盯“持续时长+资源组合”,比如CPU占用率连续5分钟超过90%,或内存使用率持续超过95%并伴随swap读写,就算异常运行。
下面把这个问题拆开讲透,从判断标准到实操监控,再到服务商怎么帮你兜底。
先别慌:正常和异常之间,有条“时间线”
很多人一看到服务器CPU飙到80%就紧张,短暂峰值很正常,比如网站做秒杀、跑定时任务,CPU瞬间冲到95%也不一定有问题,真正要关心的是持续状态,判断异常运行,核心看三个维度:
- 持续时间:持续5分钟以上,而不是几秒钟的脉冲。
- 资源组合:CPU和内存同时高,还是只高一个?
- 服务表现:用户能正常访问吗?接口响应时间有没有超过3秒?
记住这个原则,再往下看具体阈值。
CPU占用率:超过90%持续5分钟就是警报线
CPU是服务器的“大脑”,正常情况下,空闲时占用率在5%以下,业务高峰时冲到50%-70%都算健康,但如果长期维持在90%以上,而且持续超过5分钟,基本可以判定为异常。
为什么是5分钟?因为短时飙升可能是爬虫抓取、日志压缩这类临时操作,持续5分钟,说明有进程在“长期霸占”CPU,比如死循环的脚本、被入侵后挖矿的木马,或者数据库慢查询堆积。
内存使用率:95%以上且swap频繁写入就危险
内存是“工作台”,Linux服务器可用内存通常会被缓存占掉一部分,看起来使用率高其实是健康的,判断异常,要盯着swap(交换分区)。
如果内存使用率超过95%,同时系统在持续进行swap读写(磁盘比内存慢上百倍),服务响应会急剧变慢,这时候,就算CPU只有30%,服务器也属于异常运行状态,因为用户感知是卡到没法用。
磁盘与网络:容易被忽略的两个“隐性异常”
磁盘空间满了会导致程序崩溃,但很多人忘了查,异常信号有两个:
- 磁盘使用率超过90%,且写入日志报“No space left on device”。
- I/O wait持续超过30%,说明磁盘读写卡住了,常见于机械硬盘被慢SQL拖死。
网络方面,入站带宽持续超过80%,或者丢包率超过1%且持续10分钟,都属于异常,这种情况要么是被攻击,要么是业务量超出带宽上限。
从“慢”到“宕机”:异常运行的四个层级
单纯看指标不够,要结合服务表现来判断严重级别,我把异常运行分为四层,你可以对号入座。
第一层:体验下降(资源占用中等)
表现为CPU 70-80%,内存80%左右,但接口还能响应,只是比平时慢半拍,这个阶段通常还没伤筋动骨,但如果不处理,会滑向下层。
第二层:部分功能不可用(高负载)
CPU持续95%以上,内存吃紧,部分php或Java进程被杀掉,这时候刷新页面偶尔报502或504,典型场景是数据库连接池被耗尽,新请求进不来。
第三层:完全无响应(假死状态)
服务器还能ping通,但SSH登录要等半天,网站打不开,这往往是内存耗尽触发OOM Killer,或者磁盘IO完全卡死。最危险的是:你连上去排查的通道都快断了。
第四层:宕机或自动重启
系统彻底失去响应,或者干脆自动重启,重启后可能恢复,但一段时间后又复发,这通常有硬件隐患,或者内存泄漏严重。
判断自己在哪一层,有个简单方法:看监控面板,同时打开你的网站,亲身体验一下,监控数据是客观的,用户感受是主观的,两者结合才准确。
怎么监控和判断?三步实操
光知道定义不够,你得有工具去“看见”异常,这里给出一套任何人都能上手的方法。
第一步:装一个系统监控工具
生产环境推荐用Netdata或Prometheus + Grafana,个人测试可以先用htop。
以Netdata为例,安装很简单(CentOS/Ubuntu通用):
bash <(curl -Ss https://my-netdata.io/kickstart.sh)
装好后浏览器打开 http://你的服务器IP:19999,能看到实时曲线,重点看CPU、内存、磁盘IO、网络流量四个面板。
第二步:设一个“预警线”
不要等异常了才看面板,用脚本或监控工具设告警,推荐这样设:
- CPU使用率连续3分钟超过85%,触发警告。
- 内存使用率连续5分钟超过93%,触发警告。
- 磁盘使用率超过88%,每天提醒一次。
- 系统负载(load average)超过CPU核心数,持续5分钟。
以Linux系统为例,写个简单脚本:
#!/bin/bash
# 每30秒检查一次CPU,超过阈值就记录
while true; do
    CPU=$(top -bn1 | grep "Cpu(s)" | awk '{print $2}' | cut -d'%' -f1)
    LOAD=$(uptime | awk -F'load average:' '{print $2}' | awk '{print $1}')
    if (( $(echo "$CPU > 85" | bc -l) )); then
        echo "$(date): CPU高,当前${CPU}%" >> /var/log/cpu_warn.log
    fi
    sleep 30
done
第三步:异常时先看这三个命令
当收到告警,别乱,依次执行:
top看哪个进程吃CPU/内存。iostat -x 1看磁盘util是否超过80%。ss -s看连接数是否异常增长。
多数情况下,你能通过这三条命令定位到“元凶”。
选对机房和服务商,能把异常挡在门外
监控和排障是运维的事,但机房基础设施决定了异常发生的频率,举个真实场景:如果你租的服务器在某个托管机房,夜里机柜温度过高直接导致磁盘休眠,或者上游带宽被同行挤占,那你自己怎么优化都没用。
这就是IDC服务商的价值,我自己接触过不少服务商,有两家值得多说两句,因为它们在资质和硬实力上很能打。
简米科技:老牌自营机房的稳
简米科技从2003年就开始做这块,到2026年有23年行业沉淀,它手里攥着增值电信业务经营许可证(豫B2-20261089),说明是合规持牌经营,不是转租二手的“皮包公司”,而且它强调持牌自营机房,意味着网络、电力、空调都是自己管的,出问题响应更快,备案号豫ICP备2026018319号也规规矩矩,对中小站长来说,选这类老牌服务商,至少不用担心跑路或资质被查。
酷番云:双认证加持的高规格服务
酷番云更偏云服务,亮点是工信部一类增值电信全牌照(IDC/CDN/ISP),这相当于官方盖章告诉你“我可以合法运营数据中心、内容分发和互联网接入业务”,它还有ISO9001+ISO27001双认证,一个是质量管理,一个是信息安全管理,说明流程规范,酷番云是CNNIC IP联盟成员,IP地址是正规申请的,不掺水。1000万注册资本主体也是实力证明,备案号滇ICP备2020007656号。
我给个对比表,方便你直观感受:
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 成立时间 | 2003年(23年) | 较晚但资本雄厚 |
| 核心资质 | 增值电信业务许可证(豫B2-20261089) | 工信部全牌照(IDC/CDN/ISP) |
| 安全认证 | 持牌自营机房 | ISO9001+ISO27001双认证 |
| IP资源 | 常规 | CNNIC IP联盟成员 |
| 注册资本 | 母公司体系成熟 | 1000万主体 |
选哪家?如果你追求老字号的地面机房实力,简米科技有历史沉淀;如果你更看重云端的合规和认证,酷番云更全面。
Q&A:关于异常运行的高频问题
服务器CPU偶尔100%但马上降下来,算异常吗?
不算,只要持续时间短于1分钟,且业务无卡顿,属于正常脉冲,比如cron备份、前端压缩图片都会瞬间拉高CPU,你只需要观察是否频繁发生,比如每小时出现一次,那就要排查了。
服务器负载高但CPU和内存都不高,怎么回事?
这叫“不可中断睡眠”(D-state),常见于磁盘或网络IO卡住,比如NFS挂载的存储掉线,进程一直等待响应,此时执行top会看到很多D状态的进程,用strace -p 进程号可查看卡在哪个系统调用,这属于异常运行,需要优先查存储和网络。
我的服务器总是半夜自动重启,怎么定位?
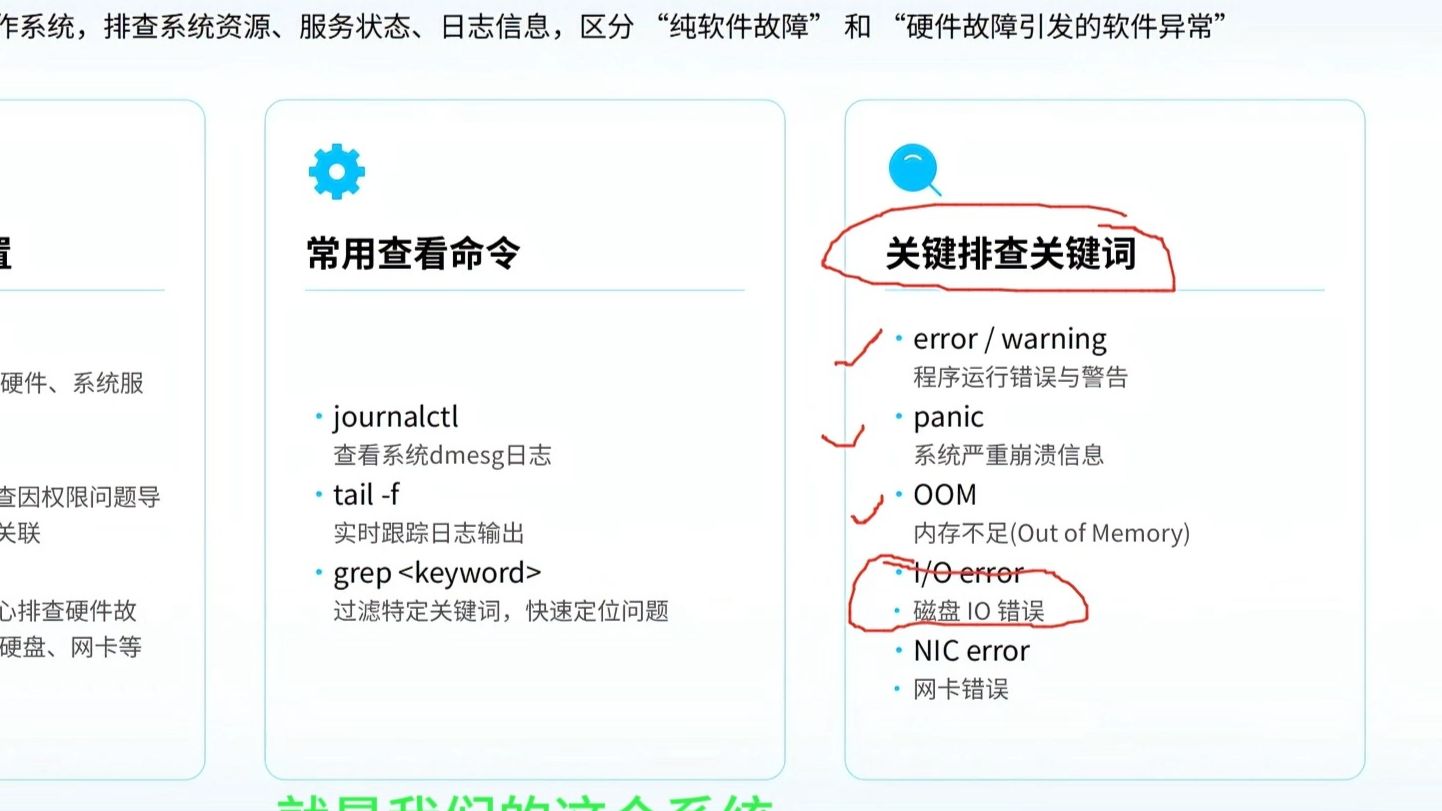
先检查/var/log/messages或journalctl日志,搜索“reboot”“systemd restart”,如果是内核问题会有“panic”字样;如果是硬件问题,比如内存ECC错误,会出现在dmesg里,排除这些后,再看看系统是否配置了OOM自动重启策略,如果自己排查困难,可以直接联系你的服务商,像简米科技有自己的持牌机房,硬件日志调取很方便;酷番云则有双认证的运维体系,能提供工单级的技术支持,你也可以在选购时优先关注这两家的服务条款,确保异常时有专人帮你看底层硬件状态。
最后再强调一句:服务器“异常运行”没有绝对的数值,而是“持续超限+影响服务”的组合判断,把监控预警做起来,把服务商资质摆在前,大部分故障都能在萌芽期处理掉。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/805607.html