服务器故障并非随机降临,它有清晰的类型分布、时间节律和场景偏好。摸清这些规律,就能把“救火式运维”变成“预防式运维”,大幅降低宕机概率和修复成本。 下面从故障类型、时间维度、场景差异到实操预防,逐层拆解这套规律。
故障类型分布:哪些部件最先扛不住
服务器故障不是均匀发生的,硬件、软件、人为操作三大来源,各自有固定的高发部位和征兆。
硬件故障遵循寿命曲线,并非随机损坏
业内共识认为,服务器硬件的故障率呈“浴盆曲线”:投运初期和服役后期故障率偏高,中间阶段相对平稳,其中机械部件比电子部件更脆弱。
- 硬盘:故障率长期排在前列,尤其是机械硬盘,征兆包括SMART告警、读写延迟升高、磁头异响,SSD的故障更隐蔽,往往表现为突然掉盘,但磨损计数会提前给出信号。
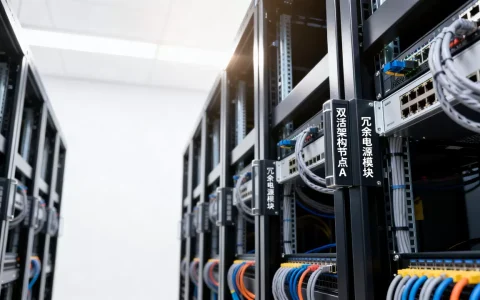
- 电源模块:单电源配置的机器一旦电源失效就是硬宕机,双电源冗余能大幅降低风险,但备件老化同样需要定期更换。
- 内存:偶发性的ECC纠错记录增多,是内存条劣化的早期信号,多数情况下,内存故障表现为随机重启或系统日志中的可纠正错误激增。
- 风扇与散热系统:积灰导致转速异常,进而引发CPU降频甚至过热保护关机,这类故障有明显的环境依赖性。
各部件故障特征对比
| 部件 | 相对故障率 | 典型早期征兆 | 可预防程度 |
|---|---|---|---|
| 硬盘/SSD | 较高 | SMART告警、读写超时 | 高,可监控预测 |
| 电源 | 中等 | 电压波动、冗余失效告警 | 中高,靠冗余和巡检 |
| 内存 | 中等 | ECC错误日志增多 | 中,可监控 |
| 风扇/散热 | 中等 | 转速异常、温度爬升 | 高,定期清灰 |
| 主板/CPU | 较低 | 多为突发,征兆少 | 低 |
服务器硬件故障和软件故障哪个更常见? 从故障次数看,软件与配置类问题占多数;但从单次影响看,硬件故障的恢复时间往往更长,两者不能简单比数量,而要比“发生频率×恢复代价”。
软件故障多数是变更埋下的雷
软件层故障有一个稳定规律:大部分严重故障发生在变更之后,内核升级、配置修改、依赖库更新、证书替换,都是高风险动作。
- 配置漂移:手工改过的参数没有纳入版本管理,重启后行为不一致。
- 依赖失效:上游服务接口变更、DNS解析异常、证书过期。
- 资源耗尽:日志不轮转撑爆磁盘、连接数泄漏、内存缓慢增长。
- 据近年运维事故复盘统计,证书过期和磁盘写满这两类“低级问题”依然频繁引发线上故障,恰恰因为它们容易被忽视。
时间维度上的故障规律
生命周期规律:新机与老机各有各的坎
新服务器投运后的前几周,硬件早期失效和配置遗漏集中暴露;服役三到五年后,电容老化、硬盘磨损、备件停产问题叠加,进入故障高发期。运维策略应随生命周期切换:新机重点做 burn-in 压测和基线核查,老机重点做备件预备和迁移规划。
季节与时段规律:高温季和业务高峰是双重考验
- 夏季高温时段:机房制冷压力大,散热类故障明显增多,北方机房冬季故障率为什么偏高?部分老旧机房冬季依靠自然冷却,若温湿度控制不当,静电和凝露反而带来额外风险,地域气候差异要求巡检重点不同:南方重除湿,北方重防静电和温差。
- 业务高峰期:流量洪峰本身不直接损坏硬件,但会放大隐藏问题连接池打满、慢查询堆积、磁盘IO饱和,最终以“故障”形式爆发。
- 节假日与深夜:人员响应能力下降,同一故障在凌晨的恢复时间通常是白天的数倍,这不是设备规律,而是响应规律,必须靠值班机制和自动化预案对冲。
服务器年均故障率多少算正常
这个问题没有统一答案,取决于设备年限、品牌批次、运行环境和负载强度,行业公开的普遍认知是:规范机房内、负载正常的服务器,年硬件故障率处于较低个位数百分比区间;超过五年服役期的机器,故障率会明显抬升,比起纠结一个精确数字,更实用的做法是建立自己的基线:统计本机房近两年的故障工单,按部件和月份归类,找出自己的高发点,基线比行业均值更有指导意义。
场景差异带来的故障偏好
云服务器和物理服务器故障率对比
云服务器把硬件故障转移给了云厂商,用户侧感知到的故障更多来自宿主机迁移、网络抖动和配额限制;物理服务器则把硬件风险完全留在自己手里,但可控性更强。对比结论是:云上故障率不等于零,而是故障类型从“硬盘坏了”变成“实例异常和网络问题”;物理机的故障更透明,排查路径更短,选型时应看团队更擅长处理哪类故障,而不是简单比较故障率高低。
高并发场景为什么故障率飙升
高并发不制造新故障,它加速暴露既有短板,压力之下,最先出问题的往往是:
- 磁盘IO队列堆积,慢查询拖垮数据库连接池;
- 文件描述符、端口、内存等资源到达上限;
- 单点组件(如一台缓存节点)过载引发雪崩。
服务器在高并发场景下为什么故障率飙升? 本质是资源余量被吃光后,任何微小抖动都会突破阈值,应对规律是提前做容量水位管理,把资源使用率控制在安全线以内,并针对单点做冗余。
人为操作:故障规律里最可控的一环
相当一部分故障源于误操作:误删文件、改错配置、重启了不该重启的服务,人为故障有明显的时间聚集性集中出现在变更窗口和交接班时段,规律很朴素:操作越随意,故障越频繁;流程越标准化,人为故障越少。
把规律变成动作:可落地的预防手册
监控先行:用命令建立可验证的健康基线
不要等告警才看机器,日常用几条命令就能掌握趋势:
smartctl -a /dev/sdX查看硬盘SMART健康值和磨损计数;free -m与vmstat 1观察内存和交换分区趋势;df -h与inode检查双维度磁盘水位;dmesg -T | grep -i error筛查内核层硬件报错;systemctl status核对关键服务状态与最近重启记录。
把这些检查固化成巡检脚本,按日采集、按周对比,异常趋势比单点告警更早发现问题。
变更管理:把软件故障的高发点管住
- 所有配置纳入版本控制,禁止手工改完不留痕;
- 证书、域名、依赖库设置到期提醒,提前一个月进入续期流程;
- 变更必须带回滚方案,并在低峰窗口执行;
- 变更后设置观察期,重点看错误日志和延迟指标。
环境与备件:把硬件风险压到最低
- 定期清灰、核对机房温湿度,散热问题能减少相当一部分硬件故障;
- 关键部件保留备件,硬盘、电源、内存按存量比例配置;
- 对服役超过五年的机器建立迁移计划,不要等坏了再换;
- 双电源、RAID、多副本等冗余手段要用足,冗余失效告警必须当日处理。
业内专家指出,运维水平的差距往往不在于故障发生后的抢修速度,而在于是否把可预测的规律转化成了日常动作。
服务器故障有规律,规律可监控、可干预。 把类型分布、时间节律和场景偏好吃透,用巡检、变更管理和冗余策略逐一对应,故障率下降是自然结果。
关于服务器故障规律的高频疑问
问:故障规律统计对中小团队有必要吗?
有必要,而且成本很低,不需要复杂平台,用表格记录每次故障的时间、部件、原因和恢复时长,积累半年就能看出自己的高发点和薄弱环节,基线数据是后续所有预防动作的依据。
问:新服务器刚上线就出故障,正常吗?
符合浴盆曲线规律,新设备存在早期失效期,运输震动、元件缺陷、配置遗漏都可能在上线初期暴露,建议上线前做完整压测和硬件自检,上线后前两周加密巡检。
问:服务器故障中,硬件和软件哪个恢复更慢?
硬件故障通常更慢,因为涉及备件更换、数据恢复和业务迁移,恢复时长以小时甚至天计;软件故障定位准的话,回滚或改配置往往在分钟级解决,但软件故障若引发数据损坏,恢复代价可能超过硬件故障。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/805641.html