控制分层防护误杀率的关键不是把每一层都调到最“钝”,而是让每一层只报它最擅长发现的可疑行为,再通过层间证据链把孤立误报消解掉。
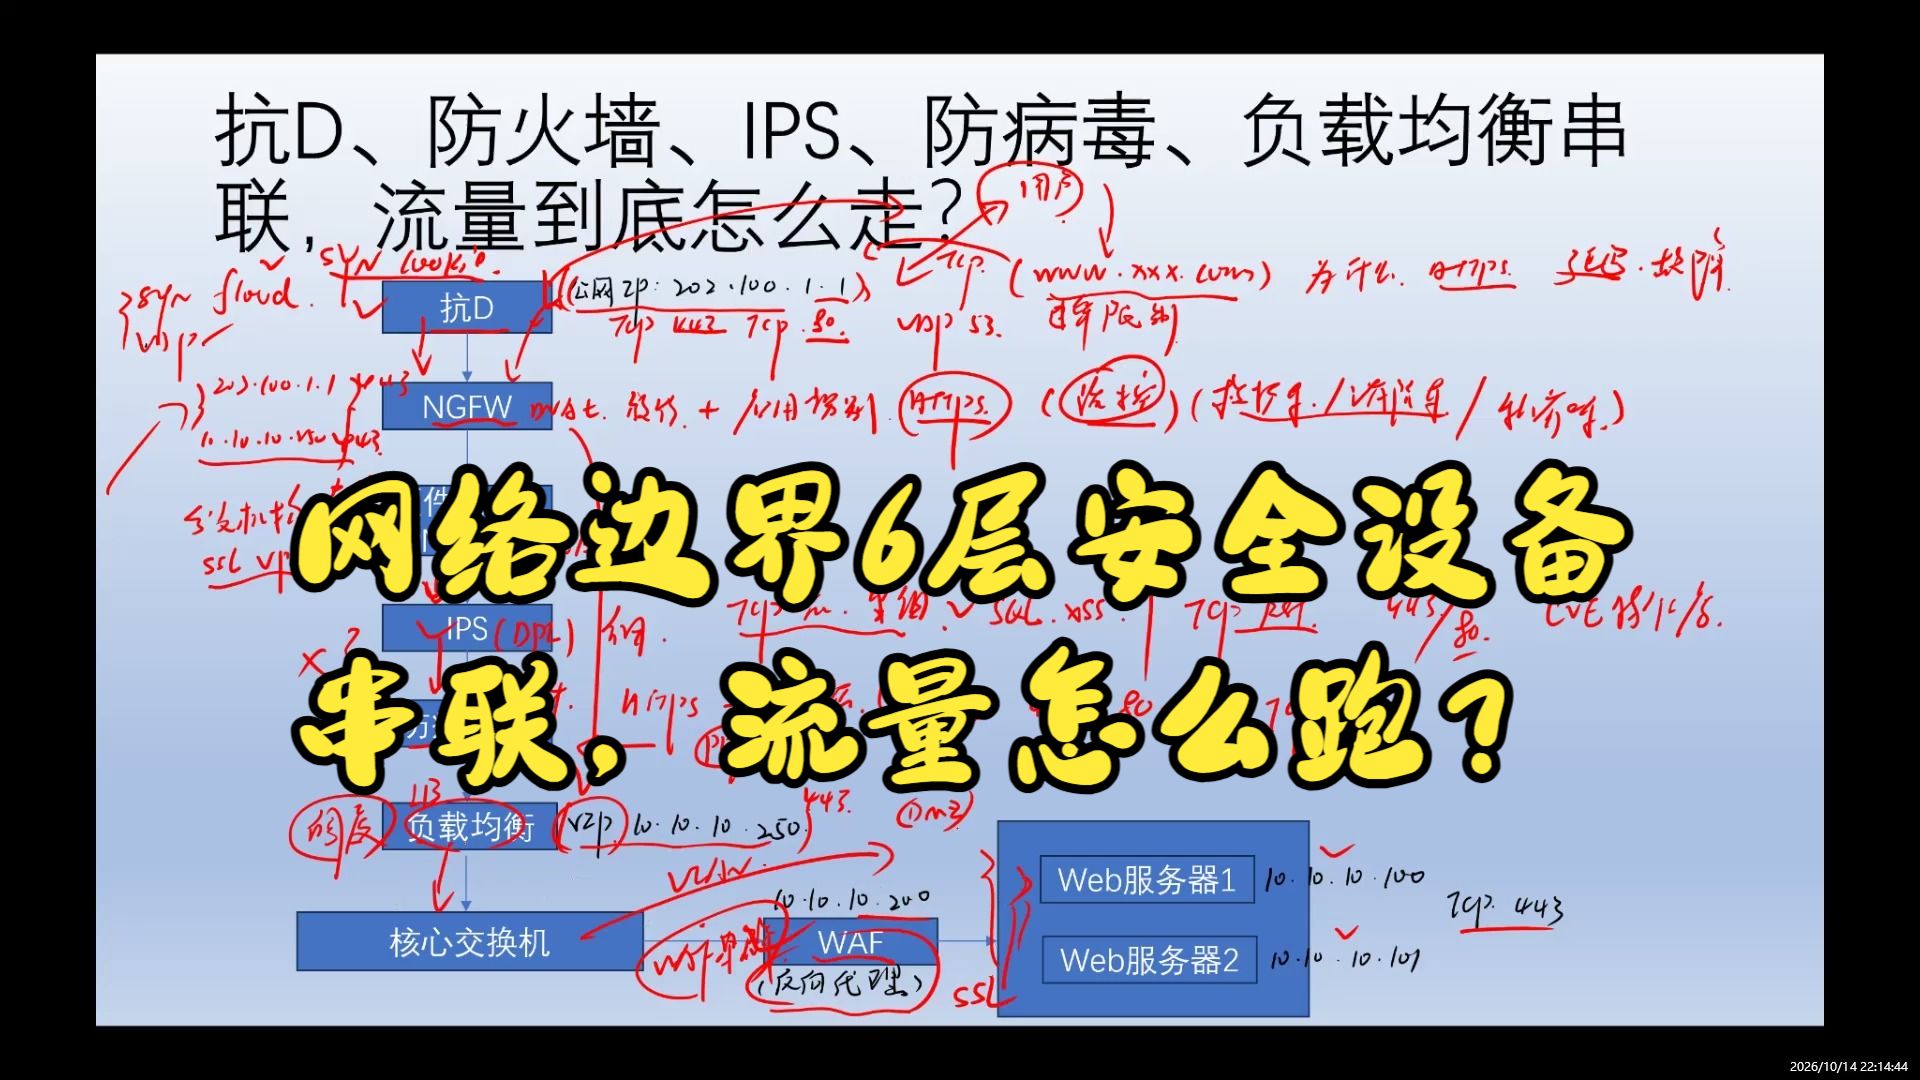
分层防护也叫纵深防御,通常覆盖网络层、主机层、应用层、数据层,每一层都有自己的检测脾气:网络层看流量,主机层看进程,应用层看请求,数据层看内容,同一个攻击动作,经常被好几层同时盯上,但真正命中的往往只有一层,其余都是在误报,所以讨论误杀率,不能脱离“层”单独谈。
分层防护里各层误杀率为什么难控制
网络层、主机层、应用层、数据层的检测机制完全不同,误报来源也完全不一样,把四层扯在一起说误报率,就像把篮球教练和游泳教练放在一起比执教水平,没有意义。
网络层与主机层的误报差异
网络层防火墙和IDS对端口扫描、暴力破解、批量外联这类行为最敏感,办公网里只要有人批量访问一个网段,告警就弹出来了,实际上这个人可能只是在跑自动化脚本,也可能是一台机器中了蠕虫,网络层误报的典型特点是数量大、单条信息量少,光靠一个IP和端口很难判断对错。
主机层EDR盯的是进程行为、注册表改动、计划任务变更,误报高发点往往是正常软件更新、驱动安装、系统补丁,比如某款资产管理软件每次启动都会改写自己的配置文件,EDR就可能把它当成可疑持久化,主机层误报的特点是上下文丰富但噪音集中,同一台机器上多个告警常常指向同一个正常软件。
应用层与数据层的特有干扰
WAF和RASP负责拦截SQL注入、XSS这类攻击,误报重灾区是业务系统自己生成的特殊字符、富文本编辑器里的HTML标签、搜索引擎爬虫的抓取动作,应用层误报最让人头疼的地方是规则越严格,正常业务被拦得越多,业内专家指出,应用层这套东西必须靠业务白名单辅助,不然根本跑不起来。
数据层DLP检查敏感信息外发,误报常出现在正常协作场景,销售把客户名单发到个人邮箱会被拦,但客户本人要求传输文件时又得放行,数据层误报本质上是在“猜你的业务到底合不合规”,光靠关键词匹配必然误伤。
分层防护误杀率怎么降低:三个关键动作
用基线学习代替固定规则
固定规则匹配是误报的最大源头,每个企业的业务环境不同,拿一套公共服务器的规则去套所有生产环境,必然误伤,比较靠谱的做法是给每一层建立“正常行为基线”,网络层统计每台主机的常用外联IP,主机层记录每个员工的常用软件列表,应用层学习URL参数的合法格式,基线建好之后,告警的含义从“命中规则”变成“偏离基线”,误报率会明显下降。
用上下文关联代替孤立告警
单层误报很难根除,但跨层能自愈,网络层报告“主机A访问了恶意IP”,主机层同时报告“主机A的进程B正在外联”,这两条告警互相印证,可信度就很高,反过来,网络层报“扫描行为”,但主机层什么异常都没有,大概率是误报,实操中,可以按“短时间内同一IP触发了多个不同层的告警”这个条件来升级处置,单层告警全部进入低优先级队列。
用反馈闭环持续调优
误杀率控制不是一次调参就能完事的,它是个持续运营过程,每次确认一条告警是误报,就把处置结果反馈回对应层,比如某条WAF规则频繁拦截业务接口的正常参数,就给这个接口加白名单,并记录加白原因,每周复盘各层误报率最高的规则,按误报次数排序,对排名靠前的规则做降级或关闭处理,每一层都应该有独立的误报统计指标,不能混在一起算总账。
防火墙和EDR误报率对比:谁更容易“看走眼”
很多企业在选型时纠结防火墙还是EDR,其实它们在分层防护里承担的角色不同,误报逻辑也完全不同,直接看表格:
| 维度 | 防火墙/IPS | EDR |
|---|---|---|
| 检测对象 | 网络流量特征 | 主机行为与文件 |
| 误报常见来源 | 扫描行为、协议异常、正常爬虫 | 软件更新、系统服务、办公宏 |
| 单条告警信息量 | 少,多为IP+端口 | 多,包含进程树、文件路径 |
| 误报影响范围 | 拦截流量可能影响业务 | 隔离进程可能导致软件崩溃 |
| 调优方式 | 依赖地址库和签名更新 | 依赖基线学习和排除规则 |
对比下来,防火墙误报影响范围更大但规则相对简单,EDR误报信息丰富但排查耗时更长。防火墙和EDR误报率对比的结论是:没有绝对谁更低,只有谁和你的业务环境更匹配,如果网络里跑着大量老旧协议,防火墙误报会明显偏高;如果终端软件生态杂乱,EDR误报就压不住。
安全告警误报原因分析:典型场景背后的真相
凌晨三点的批量登录失败告警
安全平台凌晨弹出一大片SSH登录失败,看起来像暴力破解,翻查日志发现是运维在跑批量配置同步脚本,密码凭据正常,只是并发太高,这种误报的降法很简单:把运维堡垒机IP加入网络层白名单,并给脚本运行时间窗口设置例外规则。
办公终端突然访问陌生域名
EDR报告某台终端访问可疑域名,核查下来,是该员工安装了一个网上下载的浏览器插件,插件带远程更新行为,实际无害但存在风险,这种情况不建议直接加白名单,更好的做法是给这个插件单独设置“仅允许访问指定域名”的限制规则,既不给正常更新添堵,也能压住后续误报。
财务发送大量含“账号”关键词的邮件
DLP触发敏感信息外发告警,实际是财务在给员工发工资条,可以在DLP规则里排除“工资条”相关文件名的扫描,同时保留对压缩包和图片的检测,防止真正的泄露绕过规则。
企业安全运营中心误报处理流程的建议
- 第一优先级:能直接确认是误报的告警,立即加临时白名单,标注原因。
- 第二优先级:需要进一步查证的告警,转威胁情报平台做文件信誉查询,一般在十分钟内能出结果。
- 第三优先级:暂时无法判断的告警,降级为低风险事件,不阻断,持续观察二十四小时。
- 每周从三个优先级里各抽一部分做回看,验证白名单是否误放行,以及降级事件是否复现。
误杀率控制的核心,是让每一层都保留一点怀疑,但只相信跨层证据,用行业里的话讲,这就是从“防御优先”走向“检测与响应优先”,回到最初的问题:分层防护各层误杀率如何控制?分层独立调参、层间关联验证、闭环复盘迭代,三者缺一不可。
关于分层防护误杀率控制的常见疑问
为什么减少了规则数量之后,误报率下降,漏报率却上升了?
规则少了,误报自然减少,但攻击样本也更容易被放过,误报与漏报之间存在权衡是公认的,不能单纯追求低误报,正确做法是保留核心高危规则,把容易被误伤的规则改成“仅记录不阻断”,再依靠行为分析补漏报缺口。
开源安全工具和商业安全产品在误杀率控制上差别大吗?
开源工具普遍需要更细致的调优,商业产品预置场景化策略和基线模型,通常开箱即用的误报率更低,但价格也更高,预算有限时,可以在网络层用开源工具,在主机层用商业EDR,并把调优精力放在主机层,因为主机层告警上下文更丰富,运营人员更好判断,预算充足时,选择统一SOC平台做分层关联分析更省力。
误报率控制在什么水平才算健康?
没有统一标准,但可以按相对值衡量:每月人工处置的告警里,确认误报的数量不应该盖过真实告警,如果运营团队大量时间都在排除误报,导致紧急事件没人看,说明检测策略过宽,各层的高危事件中,确认真实的占比应当保持稳定,具体阈值因行业而异,原则是误报率不能拖垮响应速度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/806379.html