tcp服务器连接数看似受端口和内存限制,真正的天花板在于内核参数与架构设计,多数服务器通过优化文件描述符、调整TCP协议栈参数并改造事件驱动模型,就能在单机上将连接数从千级提升到百万级。
先搞懂瓶颈在哪,才能对症下药
很多朋友遇到tcp服务器连接数上不去,第一反应就是加内存、换CPU,结果钱花了不少,问题依旧。连接数瓶颈通常不是硬件不够,而是系统默认参数和软件架构没跟上。
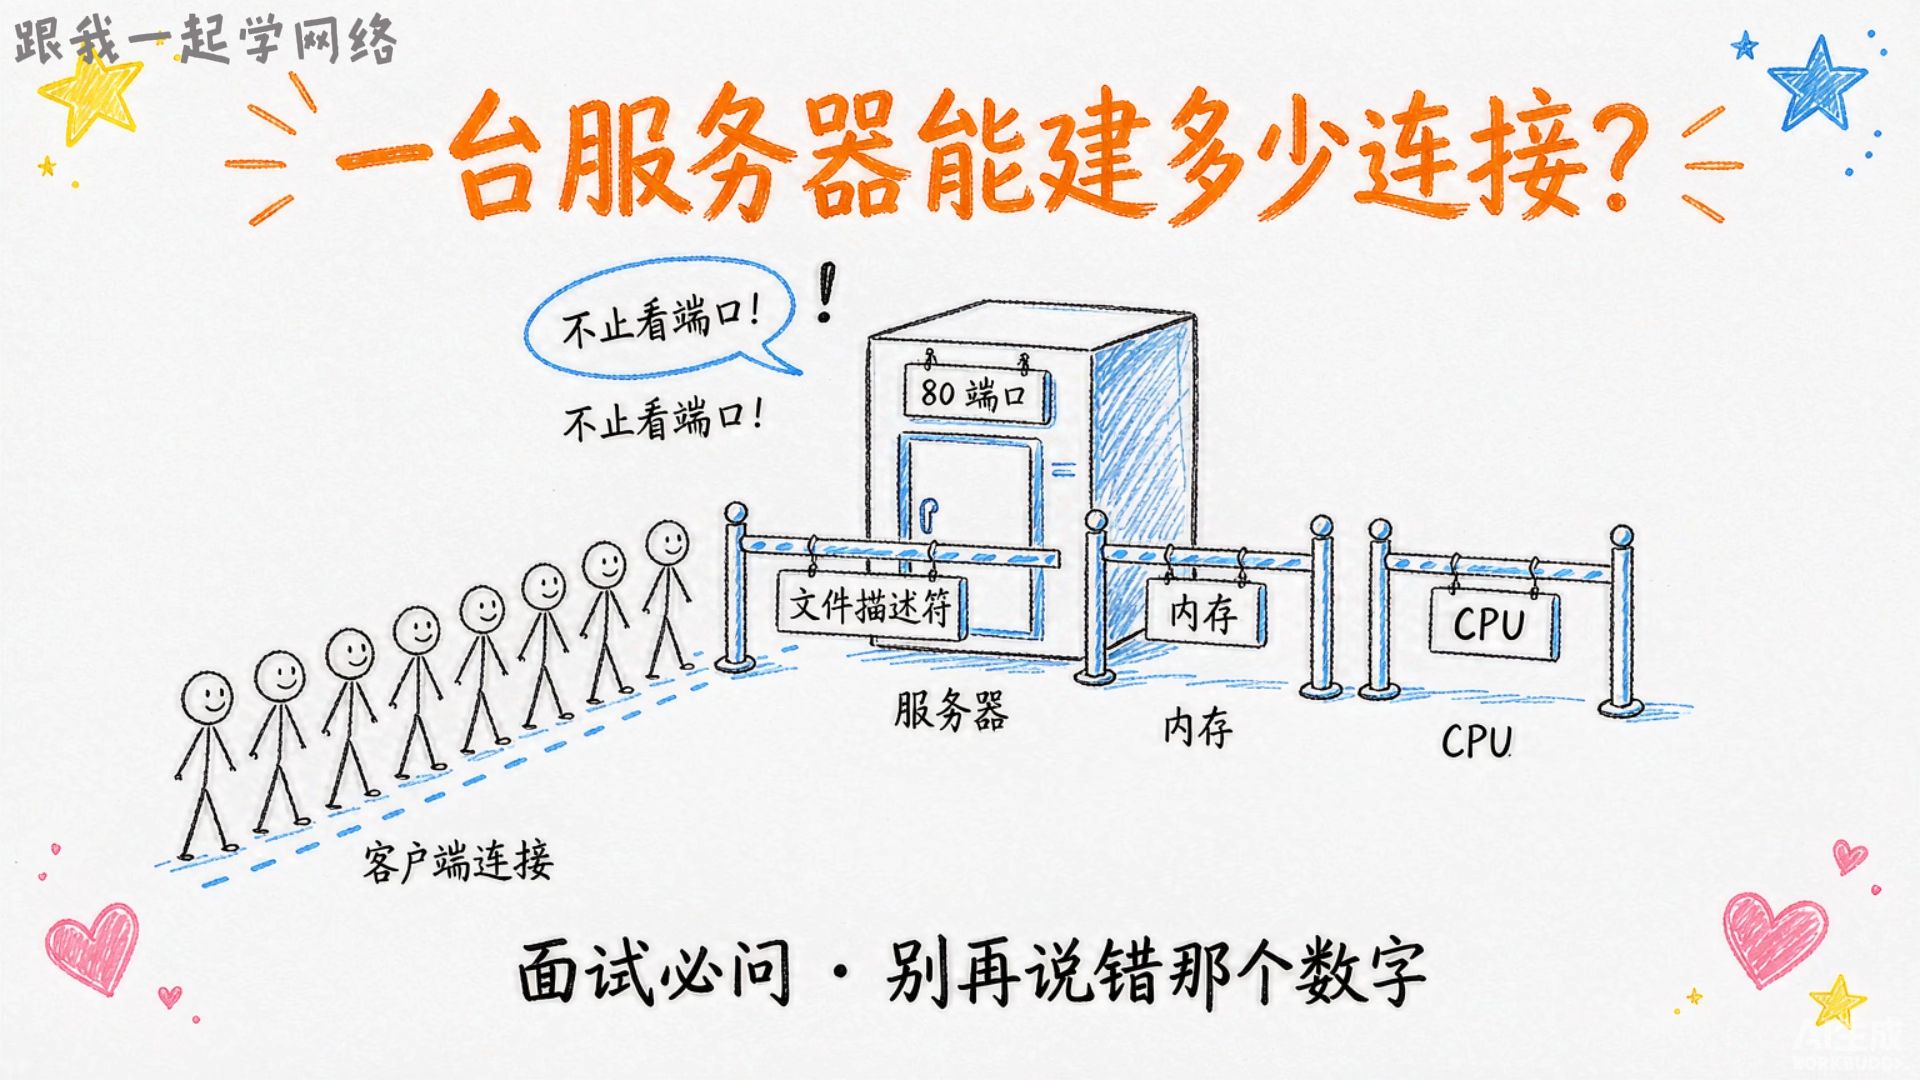
一个TCP连接从客户端发起,到服务端accept,再到数据传输,中间涉及文件描述符、内核内存、协议栈状态表等多个环节,任何一个环节卡住,后面的连接就只能排队等待。
默认配置下的“隐形天花板”
Linux系统默认对进程能打开的文件描述符数量限制在1024,这是很早以前的设计标准,也就是说,一个进程最多只能同时处理1024个连接,再多就报“Too many open files”,这个数字对现代互联网应用来说完全不够用。
TCP连接的端口范围默认设置在32768到60999之间,大约3万个可用端口,对于服务端来说,如果采用“一个连接一个线程”的传统模型,这个端口范围确实会成为瓶颈之一。
但更隐蔽的限制是内核的TCP内存管理,每个TCP连接在发送和接收方向都有自己的缓冲区,内核对总缓冲区占用有硬性限制,当大量连接同时活跃时,总内存占用会迅速攀升,触发内核的TCP内存保护机制,进而拒绝新连接。
文件描述符与端口范围的系统级调优
不同于应用层代码,系统参数的调整是全局生效的,直接影响所有进程,这部分是最基础的加固动作,操作简单但效果显著。
提高单进程文件描述符上限
直接在shell中临时修改。
ulimit -n 1048576
这个命令只对当前终端会话有效,退出后失效,适合快速验证。
永久修改,写入系统配置文件。
 soft nofile 1048576
 hard nofile 1048576
写入/etc/security/limits.conf,保存后重新登录即可生效,代表所有用户,也可以指定特定用户名。
针对systemd管理的服务,需要额外修改服务配置文件。
LimitNOFILE=1048576
在/etc/systemd/system/服务名.service.d/override.conf中加入上述内容,然后执行systemctl daemon-reload重启服务。
扩充可用的临时端口范围
服务端主动向外发起连接或者处于TIME_WAIT状态的连接会占用端口,如果端口范围太窄,也会间接影响新连接的建立。
sysctl -w net.ipv4.ip_local_port_range="1024 65535"
把端口范围从默认的3万个扩大到6万多个,永久生效需要写入/etc/sysctl.conf,同时建议开启端口重用:
sysctl -w net.ipv4.tcp_tw_reuse=1
这个参数允许内核将处于TIME_WAIT状态的连接端口重新分配给新连接,对高并发短连接场景尤其有效,业内专家指出,这组参数组合在多数Linux发行版中都能安全生效。
内核协议栈的深度调优
文件描述符只是入场券,内核协议栈的参数才是决定连接上限的关键,很多管理员修好了文件描述符,连接数依然上不去,原因就在这里。
TCP连接的内存账本
每个TCP连接至少占两个方向的内核缓冲区:接收缓冲区和发送缓冲区,当缓冲区设置的默认值过大,同时建立的连接数量就会受限。默认的tcp_rmem和tcp_wmem最大值可达数MB级别,但实际上大部分业务场景用不了这么大的缓冲。
调用以下命令查看当前值:
sysctl net.ipv4.tcp_rmem
sysctl net.ipv4.tcp_wmem
合理的做法是调整为较小的动态范围:
net.ipv4.tcp_rmem = 4096 87380 6291456
net.ipv4.tcp_wmem = 4096 65536 6291456
最小值保留4KB,默认值适中,最大值限制在6MB,既保证常规小包转发的效率,又不至于让单连接占用过多内存。
accept队列与SYN队列的关系
当请求到达服务端,首先进入SYN队列(半连接队列),完成三次握手后转入accept队列(全连接队列),最后由应用层调用accept()取走,两个队列都有长度上限。
如果队列长度设得太小,高并发下握手成功率会明显下降,客户端表现为连接超时或reset。
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 65535
同时需要在应用代码中将listen()函数的backlog参数设为一致的值,否则内核参数设置了,socket层仍旧用默认的128,等于白改。
连接保活与超时参数的取舍
默认的TCP超时检测动辄需要数小时才能发现死连接,这会让服务器背着大量僵尸连接消耗内存。
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 3
组合含义是:连接空闲600秒后开始探测,每次间隔30秒,连续3次无响应则判定连接失效,这样僵尸连接最多在几分钟内就会被回收。
行业共识认为,对于维持百万级长连接的网关服务,恰当的keepalive参数能有效压缩无效连接对内存的长期占用。
应用架构层面的改造
系统参数调优的上限受制于物理内存,单机再优化也有尽头,要真正支撑更大规模的连接,应用层架构必须同步调整。
从多线程到epoll事件驱动
传统的BIO模型每个连接分配一个线程,假设每个线程占用1MB栈空间,2GB内存的服务器最多只能撑几千个连接,改用epoll事件驱动模型后,单线程可以同时管理数万个socket连接,不需要为每个连接分配独立线程。
主流的方案有:
- libevent:老牌事件库,跨平台,适合中小型项目
- libev:比libevent更轻量,Linux平台性能更优
- Redis自带的事件模型:适合阅读源码学习epoll使用方式
- Netty(Java生态):国内大部分高并发tcp服务器连接数优化的企业级实践范本
C10K问题的现代解法:多进程+SO_REUSEPORT
单个进程的事件循环仍然受CPU核心数限制,更可扩展的方式是启动多个工作进程,每个进程独立调用epoll_wait,通过SO_REUSEPORT选项让内核将新连接均匀分发到不同进程的监听socket上。
int opt = 1;
setsockopt(listen_fd, SOL_SOCKET, SO_REUSEPORT, &opt, sizeof(opt));
这样在多核服务器上,每个核心跑一个工作进程,所有进程共享同一个监听端口,Nginx正是使用这种方式实现了高性能的反向代理。
减少连接占用的单位内存
一个空闲的TCP连接在内核中大约占3KB到5KB的内存,想支撑100万连接,仅连接状态表就需要约5GB内存,一些极端场景下,可以通过调整socket缓冲区到最小可行值来压缩内存占用,但前提是应用的收发模式匹配。
场景化方案对比与选择
不同业务形态对连接数的需求差异巨大,选择优化路径前先对照自身场景。
| 业务形态 | 典型连接特征 | 首要瓶颈 | 推荐方案 |
|---|---|---|---|
| 传统Web服务 | 短连接,请求完即断开 | 端口与TIME_WAIT | 开启tcp_tw_reuse,调小keepalive超时 |
| 即时通讯/推送 | 海量长连接,低活跃度 | 内存与fd数量 | epoll模型,压缩空闲连接内存 |
| IoT设备接入 | 海量连接,周期上报 | 文件描述符与SYN队列 | 调大somaxconn,用多进程分发 |
| 游戏服务器 | 长连接,实时交互 | CPU与事件处理能力 | 多核绑定,SO_REUSEPORT分流 |
针对物联网设备接入这类典型场景,国内云厂商提供的标准Linux镜像默认参数往往只够支撑几千个连接,如果购买的云服务器套餐是2核4G或4核8G,不调整任何参数就想同时接入十万设备,是不现实的,多数情况下,按上述方案逐一调整后,4G内存的机器即可稳定支撑20万到30万左右的轻量长连接。
常见问题快问快答
tcp服务器怎么扩大连接数量?我已经改过ulimit了为什么还上不去?
ulimit只解决文件描述符上限这一个环节,要同时检查三个层面的状态:文件描述符是否够用、内核TCP内存是否触发保护阈值、accept队列是否溢出,用如下命令快速定位:
ss -lnt
观察Send-Q列与Recv-Q列的大小,如果Recv-Q持续接近队列上限,说明应用层处理速度跟不上,需要调整应用逻辑或增加工作进程,单纯调系统参数无法根治。
连接数上去了,但吞吐量很低是怎么回事?
逻辑连接数和活跃吞吐量是两个维度,大量空闲连接会占满CPU调度和内存带宽,到真正传输数据时系统反而无法分配足够资源,建议结合连接活跃度做分级策略,常用手段包括:空闲连接转移、不活跃连接定期探测回收、根据IP段配置不同优先级,核心思路是让资源向活跃连接倾斜。
云服务器需要额外购买什么配置才能支撑百万连接?
百万连接的关键不在CPU核数,而在内存带宽,按每个连接4KB内核内存估算,百万连接至少需要4GB内存仅供连接状态使用,加上业务逻辑开销,建议使用8GB内存起步的实例规格,同时注意云安全组和系统防火墙的最大连接跟踪数限制,未修改前通常默认是65536,需确认服务商允许调高该值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/806923.html