ai大模型需要什么硬件配置没有标准答案,它取决于你的实际使用场景是本地推理、微调训练,还是跑商用级服务,三者的硬件需求差异极大。
硬件配置直接决定你能跑多大的模型、跑多快、以及花多少钱,本文按使用场景拆解,帮你避开“盲目堆显卡”的常见误区。
个人电脑运行大模型需要什么配置
本地部署大模型这两年热度很高,主要原因在于数据隐私和自定义能力,但很多人误以为“越大越好”,结果买回来才发现配置根本带不动,或者性能严重过剩。
显卡显存是核心天花板,没有之一
运行AI大模型时,模型权重必须整体加载进显存,一旦显存不足,系统会调用内存交换数据,速度会慢到不可用。
- 7B参数模型(INT4量化) :最低需要6GB显存,体验流畅建议8GB以上
- 13B参数模型(INT4量化) :需要10GB显存起步,建议12GB-16GB
- 70B参数模型(INT4量化) :需要40GB显存起步,基本只有双卡或专业卡能覆盖
INT4量化是普通用户最常用的压缩方案,它能在损失极小精度的情况下,把显存需求压缩到原来的四分之一左右,如果你用FP16半精度运行,显存需求直接翻倍,7B模型就要至少14GB。
内存和电源容易被忽略,但这决定了稳定性
很多人只看显卡,却忽略了内存和电源的配套。
内存容量建议至少是显存的两倍,32GB是本地跑AI的“及格线”,电源功率则需要根据显卡型号预留,RTX 4090整机建议1000W以上,RTX 4060 Ti整机650W就够。
处理器和主板不用过度投资
老实说,AI推理的负载主要在GPU上,CPU只需要保证数据能及时喂给显卡就行,中端六核或八核处理器完全够用,主板只需要确认PCIe通道数满足你的显卡需求,单卡用户不需要纠结这个问题。
训练大模型需要什么样的硬件环境
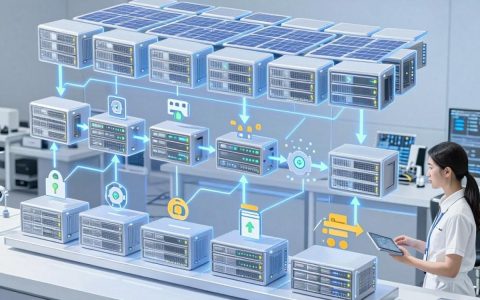
训练和推理是两个完全不同的赛道,训练需要的是大规模并行计算能力和更高的显存带宽,个人玩家的单卡方案根本不适用。
训练场景的硬件栈配置逻辑
训练大模型的核心硬件公式很简单:显存容量决定批量大小,算力决定训练速度,带宽决定扩展效率。
行业共识认为,训练一个百亿参数级别的模型,至少需要四卡A100(80GB) 级别的集群起步,这还只是“能跑”的水平,想训练千亿参数模型,没有几十甚至上百张H800/A800,基本无法在合理时间内完成。
这部分需求通常和普通用户无关,如果你想学习大模型训练原理,用消费级显卡(如RTX 4090)跑微调实验是可以的,但需要明白这只是入门级别,与真正的“训练大模型”有本质差异。
微调场景是训练和推理的中间地带
微调(Fine-tuning)是多数企业实际会碰到的场景,它比训练完整模型门槛低得多。
用LoRA(低秩适配) 这类参数高效微调技术,训练13B模型只需要12GB-16GB显存的显卡就能跑起来,这意味着普通工作站也能胜任微调任务,不需要动用专业服务器。
家庭用大模型工作站配置推荐对比
针对准备搭建个人AI工作站的用户,直接对比不同预算下的选配方案,帮你按需选择。
低预算方案:RTX 4060 Ti 16GB(约6000-7000元显卡预算)
- 可运行模型:7B-13B INT4量化模型
- 适用场景:本地文档问答、代码辅助、日常实验
- 显存带宽:288GB/s,生成速度大约每秒20-30个token
- 这套方案是“能玩”的门槛,跑轻量任务完全够用,价格又是正经大显存显卡里比较友好的。
中高预算方案:RTX 4090 24GB(约1.5万-2万元显卡预算)
- 可运行模型:13B-33B INT4量化模型,或7B FP16模型
- 适用场景:本地跑DeepSeek-R1-Distill-Qwen-14B这类中等规模的模型,或者做LoRA微调
- 显存带宽达到1008GB/s,生成速度翻倍
- 这是目前个人玩家的“甜点级”选择,价格贵但确实能覆盖大多数场景。
高预算方案:双RTX 4090或多卡拼接
- 可运行模型:70B级别的大模型(INT4量化下可能需要两张24GB卡)
- 注意:多卡搭建需要主板支持PCIe拆分,还要处理模型并行分配问题,组装难度比单卡高不少
预算优先情况下的配置参考
如果你预算有限,又必须跑AI模型,建议优先保证显存,不要为了省几百块钱选择8GB版本的卡。显存不够,显卡再好也跑不了大模型。
以下是一个参考配置单(中高预算方案):
- 显卡:RTX 4090 24GB(或等性能的二手专业卡)
- 处理器:Ryzen 7或酷睿i7级别
- 内存:64GB DDR5
- 固态硬盘:1TB NVMe(预留模型存储空间)
- 电源:1000W金牌
操作系统Windows 11也可以跑,但Linux(Ubuntu)环境下的兼容性和性能释放会更理想,推荐有一定基础的用户选择Linux。
本地部署大模型硬件怎么省钱
买新卡是显性成本,但有些思路能帮你把硬件预算压缩不少。
量化技术是不花钱的“显存放大器”
模型量化是降低硬件门槛最有效的方法,同一个模型,FP16精度下可能需要24GB显存,用INT4量化后只需要6GB-8GB,目前主流方案(如Ollama、llama.cpp)都能直接加载量化模型,不需要额外配置。
实际操作中,建议先确认你要用的模型是否支持GGUF格式的量化版本,支持的话优先选量化版本,质量差别对于一般对话和代码生成的场景,普通人基本感知不到。
二手专业卡是另一种选择
英伟达的Tesla系列专业卡(如P40、V100)在二手市场上价格远低于同显存容量的消费级新卡,例如P40有24GB显存,二手价仅2000-3000元,是低成本Run 13B-33B模型的可行方案。
但需要注意,专业卡通常没有主动散热风扇,需要自行改装散热器,如果是涡轮版还要解决噪音问题,动手能力弱的用户不建议尝试。
云服务器按需租赁更灵活
如果你只是偶尔用一下,或者需要跑大模型但不想一次性投入好几万,租云服务器会更划算,按小时计费的GPU云主机,适合模型验证和短周期实验,国内主流云厂商都有GPU实例,价格从几元到几十元每小时不等,长期使用也远低于一次性购卡成本。
大模型硬件配置常见问题解答
16GB显存能跑多大参数的大模型?
16GB显存在INT4量化下,可以流畅运行13B参数级别的模型,极限情况下可以尝试33B模型的轻度量化版本,但速度会明显下降,如果你是刚入门的用户,16GB显存是一个比较均衡的起点,基本能覆盖大多数本地AI应用需求。
苹果M系列芯片能运行AI大模型吗?
能运行,且内存统一架构让它在加载大模型时有天然优势,M系列芯片可以把GPU显存和系统内存共享,所以统一内存达到32GB或64GB的MacBook也能跑70B级别的量化模型,但它的计算速度相比NVIDIA显卡仍有差距,主要体现在token生成速度上,如果你是Mac用户,用Ollama或LM Studio就能快速搭建本地模型环境。
本地部署和调用API到底哪个更划算?
这取决于使用频率和数据敏感度,本地部署的前期硬件投入是一次性的,但后续没有调用费用,适合高频使用或数据敏感的场景,调用API没有前期成本,按量计费,适合低频使用或需要最新大模型的场景,算一笔账:以每月Token消耗量划分,中等用量下使用一两年,基本就能把本地硬件的成本分摊回来。
说到底,AI大模型的硬件配置没有“一步到位”的方案,只有“适合自己”的方案,先明确你的目标模型规模和使用频率,再倒推显卡和内存需求,最后结合预算做决策,显卡决定了你跑多快的下限,显存决定了你跑多大的上限,两者兼顾才算是配了一台真正好用的AI设备。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/807103.html