行云科技有没有AI大模型,不能一概而论:多数以“行云科技”冠名的企业并不是基础大模型研发厂商,而是把开源模型或第三方大模型API封装成行业方案的集成服务商;要确认某一家具体主体,最直接的办法是查其官网产品页、国家网信办算法备案信息和合同里的模型授权条款。
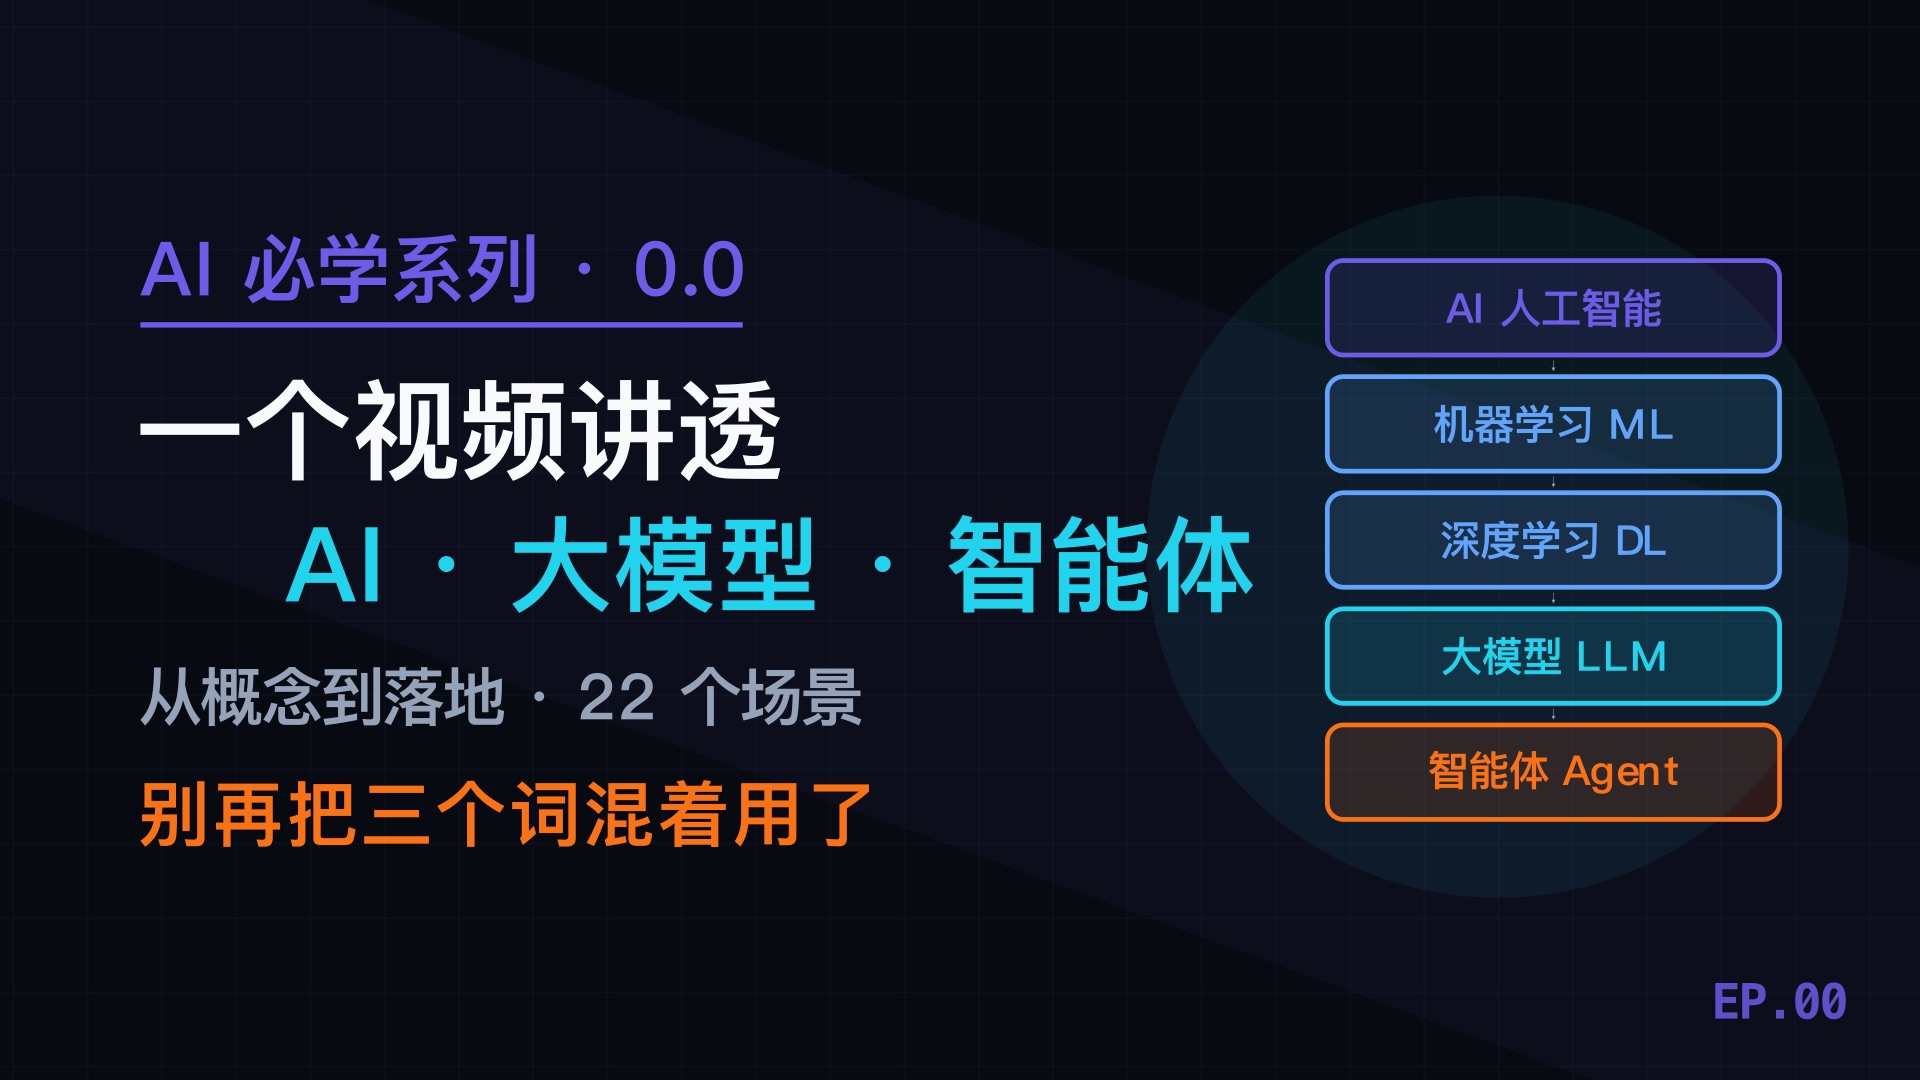
行云科技有ai大模型吗?先把“有”拆成三层看
很多人问这个问题,其实把三件事混在了一起:自己训练的基础大模型、基于开源模型微调的行业模型、调用别人API做出来的AI应用,三者都叫“有AI大模型”,但含金量完全不同。
第一层:基础大模型,自研门槛很高
训练一个可用的基础大模型,需要千卡级GPU集群、高质量语料和稳定的算法团队,业内专家指出,国内真正具备从零训练千亿参数模型能力的企业数量有限,主要集中在头部互联网公司和AI创业公司,以“行云科技”命名的企业,公开信息中较少看到基础模型训练相关的算力采购、论文或模型开源记录,所以如果你问的是“它有没有自己从零训练的大模型”,答案大概率是没有。
第二层:行业模型,常见的“有”
更多行云科技类企业做的是这一层:拿Qwen、Llama、DeepSeek等开源权重,用客户所在行业的语料做微调,再配上检索增强生成(RAG)和知识库,对外宣传时可能叫“行云行业大模型”,合同里写的却是“基于开源模型提供定制化AI服务”,这不算虚假宣传,但你要分清你买的是模型能力,还是集成服务。
第三层:AI应用,最普遍的存在形式
还有一类行云科技主体,本身不碰模型权重,只做上层应用:智能客服、文档问答、工单分类、营销文案生成,后端调用的是百度文心、阿里通义或智谱的API,这类公司说自己“有AI大模型能力”没毛病,但它的核心竞争力在场景理解和交付,不在模型本身。
判断方法不复杂,按下面几步走:
- 打开官网,找“产品中心”或“解决方案”,看有没有明确写模型参数规模、训练数据来源、是否开源。
- 查国家网信办生成式人工智能服务备案清单,看备案主体名称是否与你接触的公司一致。
- 问销售三个问题:模型权重归谁、能不能私有化部署、微调数据会不会出你的机房。
- 看合同技术附件,重点找“模型许可”“开源协议”“第三方API”这几个词。
行云科技ai大模型怎么收费?三种计费方式对照
价格是第二高频问题,行云科技这类服务商的报价通常不是一口价,而是跟着交付方式走,下面这张表可以作为询价前的参照。
| 计费方式 | 常见形态 | 适合谁 | 价格感受 |
|---|---|---|---|
| 按调用量 | 按token或千次请求计费 | 先做POC、流量波动大 | 轻量试用每月几百到几千元 |
| 项目制 | 需求调研+微调+部署+验收 | 有明确业务场景 | 数万到数十万元不等 |
| 年订阅+私有化 | 软件授权+GPU服务器+运维 | 数据敏感、要长期用 | 一次性投入较大,后续按年付服务费 |
需要提醒的是,私有化部署的真实成本不只在软件授权,GPU服务器、机房电费、运维人力往往占大头,近年来不少企业做预算时只算了模型费用,上线后发现推理卡不够,又追加采购,询价时让对方把“并发用户数、平均响应时间、知识库更新频率”写进报价单,比只问“多少钱一套”有用得多。
行云科技ai大模型和百度文心一言有什么区别?
这两个名字经常被放在一起比较,但定位不同,文心一言是通用基础大模型,提供标准API和公有云服务;行云科技更常见的角色是集成商,把模型能力嵌进客户的业务系统里。
- 模型来源:文心一言是自研底座;行云科技多数情况接入开源模型或第三方API。
- 数据边界:文心一言公有云调用数据出企业机房;行云科技可做私有化,数据留在内网。
- :前者卖模型能力;后者卖“模型+场景+实施”。
- 适用场景:要快速验证通用能力,选标准化API;要把AI塞进已有ERP、CRM、工单系统,选集成商更省事。
行业共识认为,企业选型时不必纠结“谁家模型更强”,先看数据能不能出域、业务系统谁来对接、出问题谁负责,这三个问题回答清楚,选型方向基本就定了。
行云科技ai大模型适合哪些企业用?三类团队匹配度更高
不是所有企业都适合找行云科技这类服务商,下面三类匹配度较高。
有行业数据、但没有算法团队
制造业、医疗、律所、财税公司往往积累了大量文档和工单,却养不起一个算法团队,行云科技这类服务商可以提供数据清洗、标注、微调、部署一条龙,企业侧只需要派业务专家参与验收。
要求数据不出内网
金融、政务、大型国企对数据出境极其敏感,公有云API再便宜也不能用,私有化部署成为刚需,行云科技如果能提供开源模型权重和本地推理方案,正好补上这个缺口。
预算有限、想先小规模试点
直接自建大模型团队,一年人力成本就不低,先花几万到十几万做一个部门级试点,跑通再复制,是更稳妥的路径,试点阶段建议把范围压到一个场景,合同审查问答”或“设备维修知识库”,不要一上来就做全公司AI中台。
如果你的需求是极致通用能力、超大并发、或者需要模型厂商级别的持续迭代,直接找基础模型厂商更合适,集成商的优势在落地,不在模型军备竞赛。
行云科技ai大模型本地部署方案怎么落地?五步操作路径
如果你已经确认对方能提供私有化部署,下面这套流程可以直接拿去用。
第一步:盘清场景和数据
列出三个要解决的问题,每个问题配上现有数据量,售后工单自动分类,历史工单8万条”“产品手册问答,PDF约300页”,数据量太小的场景先放一放,微调效果有限。
第二步:选模型规格
7B到14B参数模型适合单卡或双卡推理,72B级别需要多卡,常见开源选择包括Qwen系列、Llama系列、DeepSeek系列,让对方明确告诉你选的是哪个模型、哪个版本、许可证是否允许商用。
第三步:估算硬件
用nvidia-smi查看现有显卡显存,7B模型FP16推理大约需要14GB以上显存,量化后可降低;14B建议24GB以上;72B通常需要多卡,实际采购前让服务商提供压测报告,别只看理论值。
第四步:搭环境跑通推理
最小验证可以用Ollama:
ollama pull qwen2.5:7b
ollama run qwen2.5:7b
生产环境一般用vLLM或TGI部署,配合Docker Compose管理,验收时重点看首token延迟和并发下的稳定性,而不是只看单条回答漂不漂亮。
第五步:接知识库和业务系统
RAG链路包括文档解析、切分、向量化、召回、重排,切分粒度建议从500字左右开始调,太大召回不准,太小丢上下文,上线前准备100条真实问题做人工评分,准确率达不到业务底线就继续调,不要急着全员推广。
深圳行云科技ai大模型相关主体怎么核验?地域搜索要多留一步
搜索“深圳行云科技ai大模型”或“杭州行云科技ai大模型”时,你会发现同名或近名主体不止一家,这不是搜索引擎的问题,而是“行云科技”本身是常见字号,核验时按下面顺序走:
- 在国家企业信用信息公示系统查营业执照,确认统一社会信用代码与你签约主体一致。
- 在网信办算法备案系统查生成式AI服务备案,看备案主体和模型名称。
- 看官网底部的ICP备案号和公司全称,别只看品牌名。
- 要求对方提供软件著作权登记证书或模型服务协议样本。
- 如果是政府采购或国企项目,查中标公告里的供应商全称。
这几步做完,基本能排除“李逵还是李鬼”的问题,地域词搜索容易带出代理商和贴牌商,签约前多问一句“你是原厂还是渠道”,能省掉很多后续扯皮。
关于行云科技ai大模型的常见问题
行云科技ai大模型是自主研发的吗?
多数情况下不是从零训练的基础模型,而是基于开源模型做微调或直接调用第三方API,判断依据看三点:是否公开模型参数规模、是否提供模型权重下载、合同里是否出现开源许可证名称,如果对方只提供API、不提供权重,那本质上是应用服务,不是模型厂商。
行云科技ai大模型能私有化部署吗?
能不能私有化,取决于对方是否拿到开源模型的商用授权以及是否具备交付能力,询价时直接问“权重能不能落到我们机房”“断网能不能推理”“微调数据会不会回传”,三个问题都是“能”,才算是真私有化,只能提供公有云API的,不属于私有化部署。
行云科技ai大模型和直接使用开源模型有什么区别?
直接拿开源模型自己搭,成本低、可控性强,但需要自己解决微调、RAG、运维和业务系统对接,行云科技这类服务商卖的是“省事”:帮你选模型、清洗数据、部署上线、做验收,区别不在模型本身,而在交付责任边界,预算够、团队缺人,买服务合理;团队有算法能力,自己搭更划算。
回到最初的问题:行云科技有没有AI大模型,答案取决于你问的是哪一家主体、哪一层能力,把“自研底座”“行业微调”“API应用”分开看,再按文中的核验步骤走一遍,基本不会被宣传话术带偏,选型时先定数据边界和交付责任,再谈模型参数,顺序反了容易花冤枉钱。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/807361.html