判断Redis服务器是否挂掉,最快的方法是执行redis-cli ping,返回PONG就是活着,报错或超时就是出了问题。这条命令是Redis自带的心跳检测,能穿透网络直达服务端,比看进程列表更可靠。
redis服务器挂了怎么查:三个常用命令快速定位
当你的应用开始报错,或者数据读取突然变慢,别急着怀疑代码,先把矛头对准Redis,用下面三个命令层层排查,基本能在两分钟内得出结论。
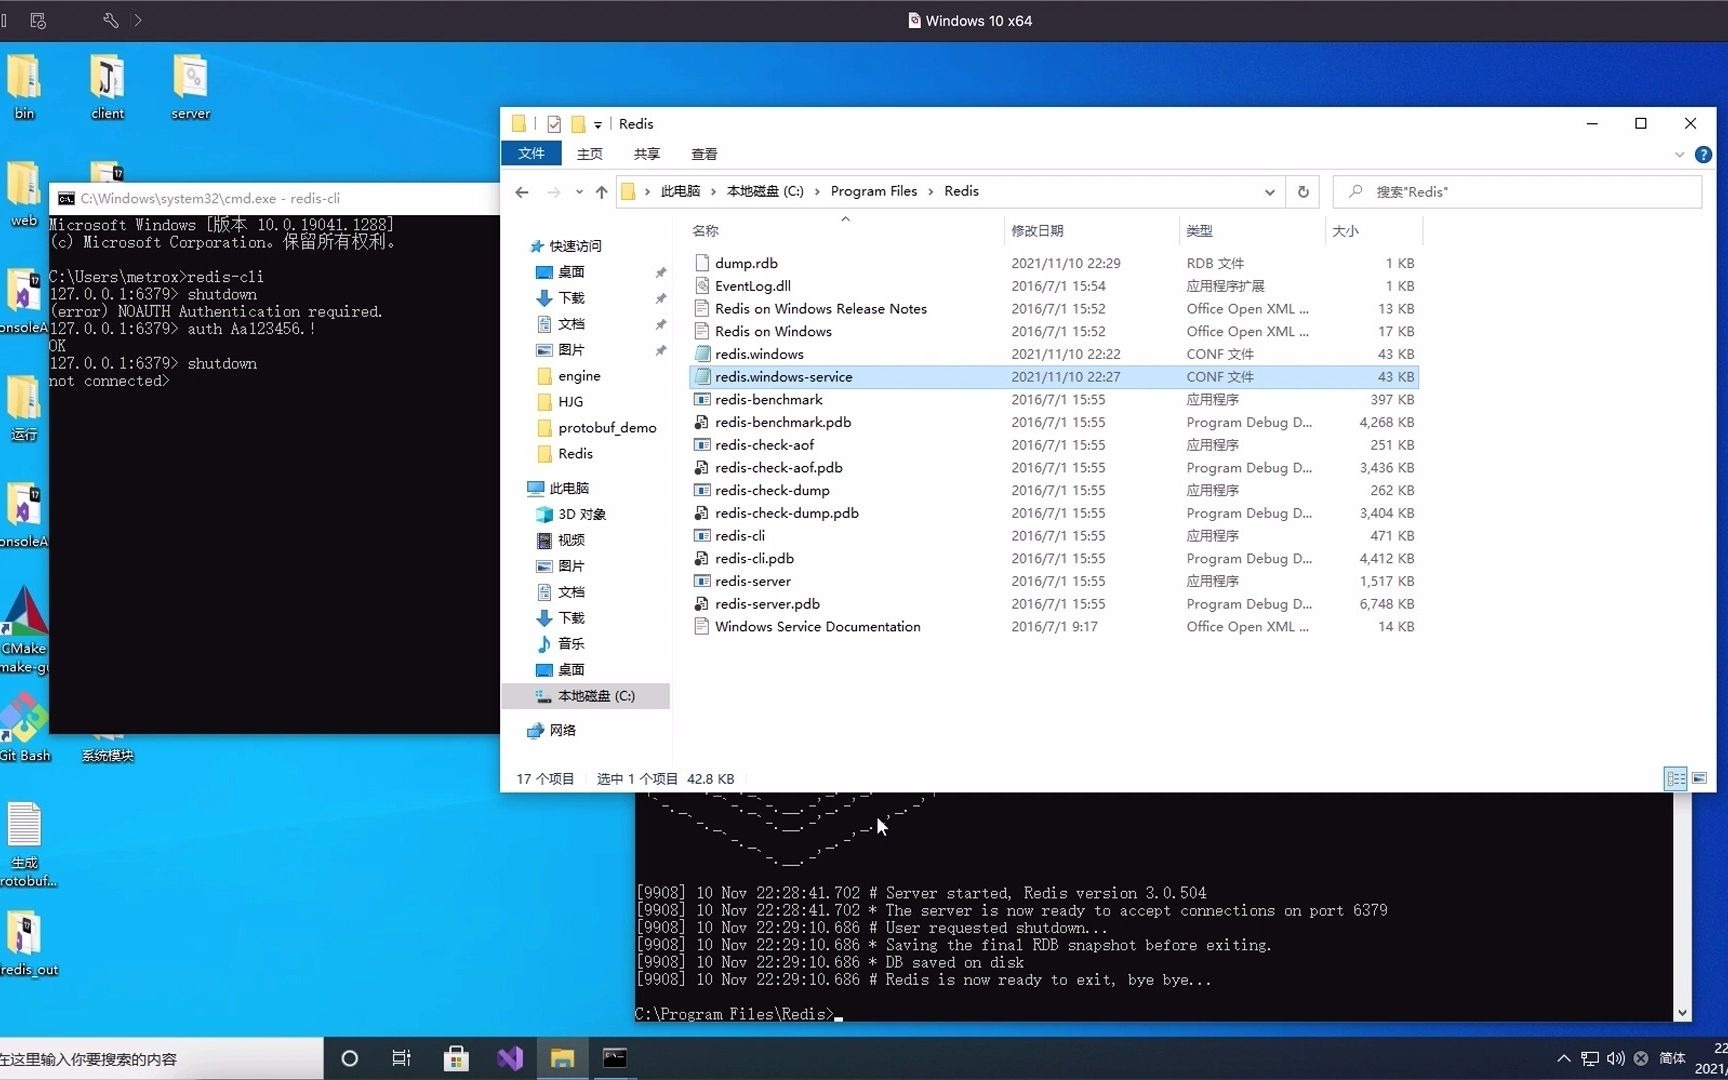
cmd查看redis是否启动:ping命令就是体检报告
PING命令是Redis提供的最轻量级健康检查接口,在终端里输入:
redis-cli ping
如果结果是PONG,说明Redis进程活着,而且网络通畅,如果报了Could not connect to Redis at 127.0.0.1:6379: Connection refused,那就说明Redis根本没在监听,进程可能已经死了,或者启动参数有误。
这里有一个常见误区:ping通了不代表Redis很健康,它只代表服务进程还在,就像一个人有心跳但可能发着高烧,如果Redis内存暴增、阻塞在慢命令上,ping照样返回PONG,但业务已经卡成幻灯片了。
别只用一个ping就下结论,配合下面两个命令一起看,才能还原真相。
redis连接失败如何排查:先分清是网络问题还是进程问题
连接失败的原因多种多样,别一头扎进服务器里翻日志,我推荐你用这样一个顺序来排查:
- 先ping网络:
ping redis服务器IP,看看基础网络通不通,不通就去查防火墙和安全组,尤其是云服务器,容易在安全组规则里把6379端口漏掉。 - 再查端口:
telnet redis服务器IP 6379,如果通,说明Redis在监听,如果网络通但telnet不通,多半是Redis绑定了0.0.1,只允许本机访问,远程连不进来。 - 最后看进程:
ps -ef | grep redis-server,如果进程存在但端口不监听,大概率是启动时崩溃了,或者配置文件的port项被改掉了。 - 试试密码:如果Redis设置了
requirepass,直接ping会报NOAUTH Authentication required,这不代表挂了,只是需要带上密码:redis-cli -a 你的密码 ping。
这个排查链路,是我在日常运维中总结出的最省时间的路径,多数情况下,不是Redis真的死了,而是访问路径上哪个环节堵了。
redis-server进程状态与端口信息,比命令更直接
命令只是表象,进程才是本质,如果Redis进程真的挂了,ping自然会失败,但我们要做的是在它挂之前就发现问题,或者在第一时间确认它确实挂了。
info命令:让Redis自己汇报身体状况
INFO命令能返回Redis当前的全部运行状态,包括内存使用率、连接数、命中率、复制状态等关键指标,这个命令是排查问题的利器,建议将以下几个指标作为重点关注对象:
connected_clients:当前连接数,如果这个数字异常低,说明业务侧可能已经没法建立新连接了。used_memory_rss:Redis从操作系统那里拿到的物理内存,这个值如果接近服务器物理内存上限,就危险了,随时可能被OOM Killer干掉。rdb_last_bgsave_status:最近一次持久化是否成功。ok代表正常,如果显示err,那Redis虽然活着,但数据安全已经出了问题。
日志文件:它从不撒谎
Redis的日志通常位于/var/log/redis/redis-server.log,可以通过配置文件中的logfile参数查看,当Redis挂掉之前,日志里往往会有蛛丝马迹,
OOM command not allowed when used memory > maxmemory:内存超限,写入被拒绝。MISCONF Redis is configured to save RDB snapshots:持久化失败,Redis为了保护自身会拒绝写入。User requested shutdown...:有人执行了SHUTDOWN命令,把所有数据落盘并正常退出。
查看日志的命令很简单:tail -100 /var/log/redis/redis-server.log,如果日志最后几行出现了上述报错,说明Redis正在用最后一丝力气向你求救,你得赶紧处理,否则它真的要罢工了。
系统层面:别忽略操作系统的干预
Linux的OOM Killer是Redis的“隐形杀手”,当服务器内存不足时,内核会挑选一个进程杀掉,Redis往往因为占用内存大而被选中,出现这种情况,dmesg | grep -i oom会显示相关记录,排查的时候顺手看一眼准没错。
怎么从业务侧感知Redis挂掉的信号
Redis还没彻底挂掉,但已经处于“半死不活”的状态,这时候业务侧的表现会先于监控告警暴露问题。
缓存雪崩和缓存穿透的区别
- 缓存雪崩:大量缓存同时过期,请求直接打到数据库,数据库压力飙升,这容易被误判为“Redis挂了”,因为业务表现都是“查不到数据”。
- 缓存穿透:查询一个不存在的key,缓存和数据库里都没有,每次请求都绕过缓存直击数据库。
如果你发现某段时间内,Redis的keyspace_hits(命中次数)直线下降,而keyspace_misses(未命中次数)飙升,那Redis本身大概率还活着,但是缓存策略出了问题,反过来,如果Redis彻底失联,业务侧会直接报连接超时,错误日志里全是RedisTimeoutException或RedisConnectionFailureException。
从客户端视角看问题
如果你是Java程序员,用的Jedis或Lettuce客户端,连接池的状态能提供不少线索:
- 连接池活跃连接数爆满,但请求还是超时,说明服务端卡住了,可能在处理大key的删除或持久化。
- 获取连接等待时间过长,说明连接池满了,可能是某个业务把连接占着不放,Redis本身倒是没挂。
行业共识认为,Redis本身的QPS可以轻松破十万,大多数性能瓶颈都出在使用方式和客户端配置上。
实操:一步一步确认Redis是否存活
以下是一套完整的检查流程,无论你是开发还是运维,按这个顺序来,能保证不遗漏任何环节。
- 执行
redis-cli -h 127.0.0.1 -p 6379 ping,确认本机能否连通Redis。- 返回
PONG,继续下一步。 - 报错,跳到步骤4。
- 返回
- 执行
redis-cli info server,查看uptime_in_seconds,这个值代表Redis已经运行了多少秒,如果这个值很小,说明Redis刚重启过,之前挂了。 - 执行
redis-cli info memory,检查used_memory_rss与maxmemory的关系,如果前者接近或超过后者,说明内存吃紧,Redis可能在苟延残喘。- 用
redis-cli info stats查看total_commands_processed,对比前后两次的差值,如果几乎没变化,说明Redis卡住了。
- 用
- 查看进程是否存在:
ps -ef | grep redis-server,如果进程不存在,确认挂掉,启动它:systemctl start redis或/etc/init.d/redis-server start。 - 检查系统日志:
journalctl -u redis-server --since "5 minutes ago",看看Redis为什么退出。 - 如果以上步骤还没找到原因,检查磁盘:Redis在进行RDB持久化时,如果磁盘满了,写入会失败,导致服务异常,用
df -h看看磁盘空间是否充足。
这套流程,多练习几次就能形成肌肉记忆,熟练之后,从发现问题到定位根因,也就十几秒的事。
Q&A:redis服务器挂了怎么查常见问题解答
问:redis-cli ping返回PONG,但业务连接还是超时,这是为什么?
答:ping只验证了Redis主线程能响应命令,但没验证其他维度,可能是客户端连接数已达上限,比如maxclients配置设的过低,新连接被拒绝;也可能是Redis正在执行KEYS 这类耗时的命令,阻塞了主线程,导致ping虽然能通,但业务命令排队处理不过来,用redis-cli info commandstats看看哪个命令耗时最长。
问:在Windows环境下没法用redis-cli怎么办?
答:Windows环境下,官方原生的Redis在2026年已经由微软维护并支持,但排查思路完全一样,你可以使用redis-cli检查(如果已加入系统变量),或者netstat -ano | findstr 6379查看端口监听情况,配合任务管理器确认redis-server.exe进程是否存在,工具不同,但命令和排查逻辑与Linux完全一致。
问:Redis挂掉之后,重启服务但数据全丢了,怎么避免?
答:数据丢失是因为持久化配置不完善,检查配置文件中的save参数,默认配置save 900 1代表15分钟内至少有1个key发生变更才做一次快照,如果掉电或强制杀进程,最后一次快照之后的数据就会丢失,为了避免这种情况,开启appendonly yes,以AOF模式追加写入日志,最多丢失1秒的数据,重启后,Redis会自动从AOF文件恢复数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/807971.html