爬虫日志和监控用虚拟专用服务器,选4核8G内存、NVMe固态硬盘、自带弹性带宽的独立VPS最稳当,日志写入和监控告警是核心刚需,硬件冗余比省钱更实际。
跑爬虫的日志与监控,VPS配置怎么选才不浪费钱
很多朋友一开始用最低配VPS跑爬虫,结果日志量一大,磁盘写满,监控脚本直接卡死,爬虫这东西不像网站,访问峰值不稳定,日志是持续写入的,进程一多,IO压力就上来了。
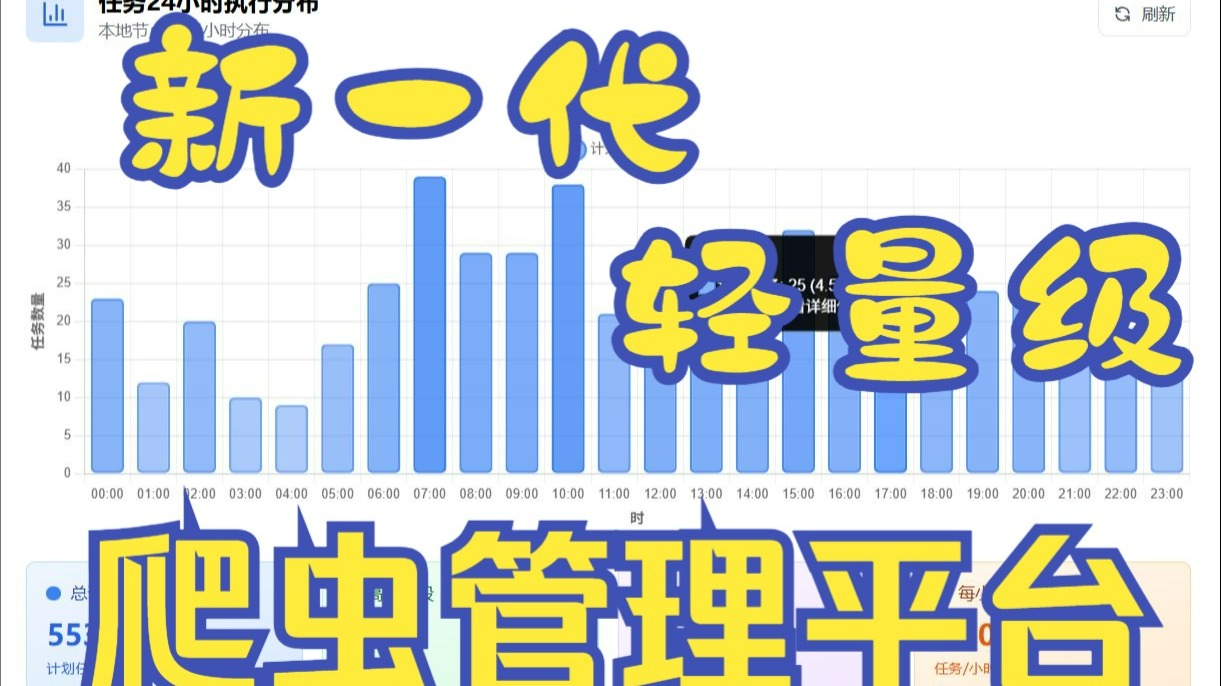
处理器核心数建议直接看4核起步,爬虫日志解析、grok过滤、实时统计,这些操作全是CPU密集型的,2核的机器跑三五个爬虫实例还行,一旦加上日志采集代理和数据清洗任务,CPU直接打满,监控数据延迟那是一定的。
内存8G是收益递减的临界点,日志采集组件比如Filebeat或Vector占内存不多,真正吃内存的是日志索引缓冲区和监控指标的时序聚合,8G内存留给系统缓存的空间够大,读写日志文件时page cache命中率高,磁盘磨损也小。
存储必须上NVMe固态,这是很多人的盲区,国内有些便宜VPS用的是SATA固态甚至机械盘,日志是大量小文件随机写入,机械盘寻道时间会让日志采集器的吞吐量掉好几个量级。NVMe的随机读写IOPS是SATA固态的5倍以上,日志轮转和压缩时的性能差距非常明显,这是业内专家指出的普遍结论。
存储容量看日志留存周期。日均日志量不超过2GB的爬虫项目,60GB NVMe空间足够轮转7天,如果日志量大,干脆上对象存储归档,VPS本地盘只做热数据缓存。
日志管理方案:从采集到轮转的完整路径
VPS拿到手之后,第一件事不是装爬虫环境,而是先把日志管道搭好,日志管道的设计决定了你后续排查问题的效率。
日志采集和传输怎么做
多数爬虫框架自带日志文件输出,但直接往磁盘写文件有两个问题:一是没有结构化字段,检索疼;二是多实例写同一个文件容易撕裂。
推荐方案是让爬虫输出JSON格式日志到stdout,由systemd-journald或Docker json-file收集,再转发给日志采集器,这样做的好处是进程崩溃之前最后几条日志不会丢,journald会缓存到持久存储。
常见的采集器选型:
- Filebeat:轻量,资源占用小,适合单机日志收集
- Vector:内存占用极低,处理吞吐高,转储S3或OSS很顺手
- Promtail:生态成熟,和Loki天然集成,日志查询切换成本低
采集器配置好之后,建议在本地起一个轻量日志查询服务,比如Loki+Grafana,或者直接用MeiliSearch做全文索引。千万不要把原始日志一股脑推给Elasticsearch,单机ES内存要求至少4G起步,日志量一大就会把VPS拖垮。
日志轮转和压缩策略
日志文件必须轮转,这是不可妥协的底线,logrotate是系统自带的工具,配置起来很快:
/var/log/crawler/.log {
    daily
    rotate 7
    compress
    delaycompress
    missingok
    notifempty
    copytruncate
}间隔选daily还是hourly,取决于日志量级,日志量超过500MB/天,建议用hourly轮转,压缩前文件控制在100MB左右。delaycompress参数很关键,让上一次轮转的文件先不压缩,等下一次再压,避免日志采集器还在读文件就被gzip,出现写入报错。
轮转后的压缩文件建议保留7-30天,存到单独的归档目录。本地只留最近几天的热数据,历史日志定期上传到云存储,这样VPS磁盘永远有足够余量,监控告警不会因为磁盘满而失灵。
监控体系搭建:从服务器指标到业务日志告警
监控分两层:基础设施监控和应用日志监控,很多爬虫团队只做了第一层,第二层日志告警完全没做,导致进程报错几天了才发现。
服务器指标监控
VPS自带的控制面板一般有基础监控面板,比如CPU、带宽、磁盘IO,但刷新粒度不够细,更好的方案是装一个轻量节点采集器:
Netdata是首选,安装简单,自带几十种指标的可视化看板,实时性极强,资源开销控制在单核5%以下,装完开启告警通道通知,磁盘空间、内存水位、CPU使用率、网络丢包、TCP重传数都能实时上报。
选配Prometheus + node_exporter的话,适合想统一管理监控指标、做后续容量规划的场景,node_exporter暴露的指标非常全,磁盘读写延迟、inode使用率、进程上下文切换数都有,配合Alertmanager做告警路由能覆盖很细的故障场景。
行业共识认为,爬虫VPS的关键监控指标是TCP连接数、磁盘IO等待时间、系统负载均值,TCP连接数异常飙升多半是网络层被限流或者DNS解析卡住;IO等待时间超过阈值基本预告磁盘快撑不住了;系统负载均值持续大于核心数说明扩容时机已到。
的智能告警
日志监控的核心目标就一个:在业务故障影响结果前发现苗头。
做法是在日志采集器上加过滤规则,匹配特定关键词后触发webhook。
Traceback|ERROR|Exception:程序异常<Response [5xx]>:目标网站服务端报错TimeoutError|ConnectionResetError:网络异常retry count exceeded:重试彻底失败
告警渠道用钉钉机器人或企业微信webhook,消息里带上时间、日志内容、进程名、服务器IP,这里要注意告警模板必须精简,一条告警一个关键信息,多层级缩进的日志堆叠在手机上根本没法看。
爬虫任务级别的监控
VPS上跑着多个爬虫项目时,每个项目的调度健康度需要单独观测。定时任务实际执行时长和计划执行时长的偏差是一个非常灵敏的信号,用cron跑爬虫,每次执行完成后写入一条执行记录,用脚本比对最近一天的耗时均值,超过三倍就自动告警。
国内与海外VPS在爬虫日志场景的体验差异
跑爬虫采集国内站点,国内VPS延迟低,但日志里大量写入时容易触发一些服务商的磁盘IO限制。海外VPS的磁盘配额相对宽松,但日志回传和告警推送可能延迟几秒,影响不大,核心是网络链路稳定性。
选国内厂商的话,北京、上海地区的VPS对爬虫流量敏感度比其他地区更高,一旦日志监控产生的高频请求被风控识别,IP容易被临时封禁,多数情况下工单申诉能解决,但影响这个窗口期的监控连续性,香港、新加坡节点反而是很多爬虫团队的热门选择,带宽大且对自动化采集的容忍度更高。
这里给一个选型判断标准不是技术指标,而是业务场景:如果爬虫目标都在国内且对时效性要求极高,选国内BGP机房;如果业务需要全球节点轮换,海外VPS配合多区域日志聚合更合理;如果只跑日志解析和监控任务,不直接涉及采集目标,那选任何区域的VPS差异不大。
常见问题
爬虫日志和监控任务对VPS配置的最低要求是什么?
2核4G内存、40GB SSD起步,能勉强跑轻量采集器加单实例爬虫,但实际运行中,日志聚合查询和监控渲染带来的内存开销很大,4G内存很容易吃紧,预算允许建议直接上4核8G,省去频繁运维调整的精力。
单台VPS同时跑爬虫和日志监控,需要做哪些隔离措施?
至少要分三个独立目录存放爬虫代码、日志数据和监控数据,使用独立系统用户运行各组件,限制权限,爬虫进程意外出现内存泄漏时,不会直接拖垮日志采集器的写盘操作,启用systemd资源限制,MemoryMax、CPUQuota这些参数很有用,防止某个进程把整个系统的资源吃光。
日志量增长特别快,磁盘总是不够用怎么办?
优先调整轮转策略,把日志按小时切割,压缩归档到对象存储,本地不留超过24小时的历史日志,排查代码里有没有循环打印堆栈或重复写日志的问题,这类情况日志量会指数级膨胀。这是最容易被忽视的隐藏陷阱,不解决的话多少磁盘都不够用。
爬虫日志和监控这件事,本质上是用系统化的管道替代人肉排查,VPS选型只是第一步,日志怎么流转、告警怎么触发、归档怎么落地,每个环节都有明确的配置路径,把日志管道和监控体系搭建扎实,爬虫跑得再野也翻不了车。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/809270.html