服务器没有所谓的“标准并发数”,正常与否取决于你的业务场景、硬件配置和代码质量,一台2核4G的机器在优化到位的情况下扛住5000并发并非天方夜谭,而一个糟糕的SQL查询能让32核的高配服务器在100并发下直接宕机。
并发数到底由谁说了算
很多人喜欢直接问“服务器能扛多少并发”,这个问题本身就问错了方向,并发数不是服务器的固有属性,而是业务逻辑、系统资源、网络带宽三方博弈后的结果。
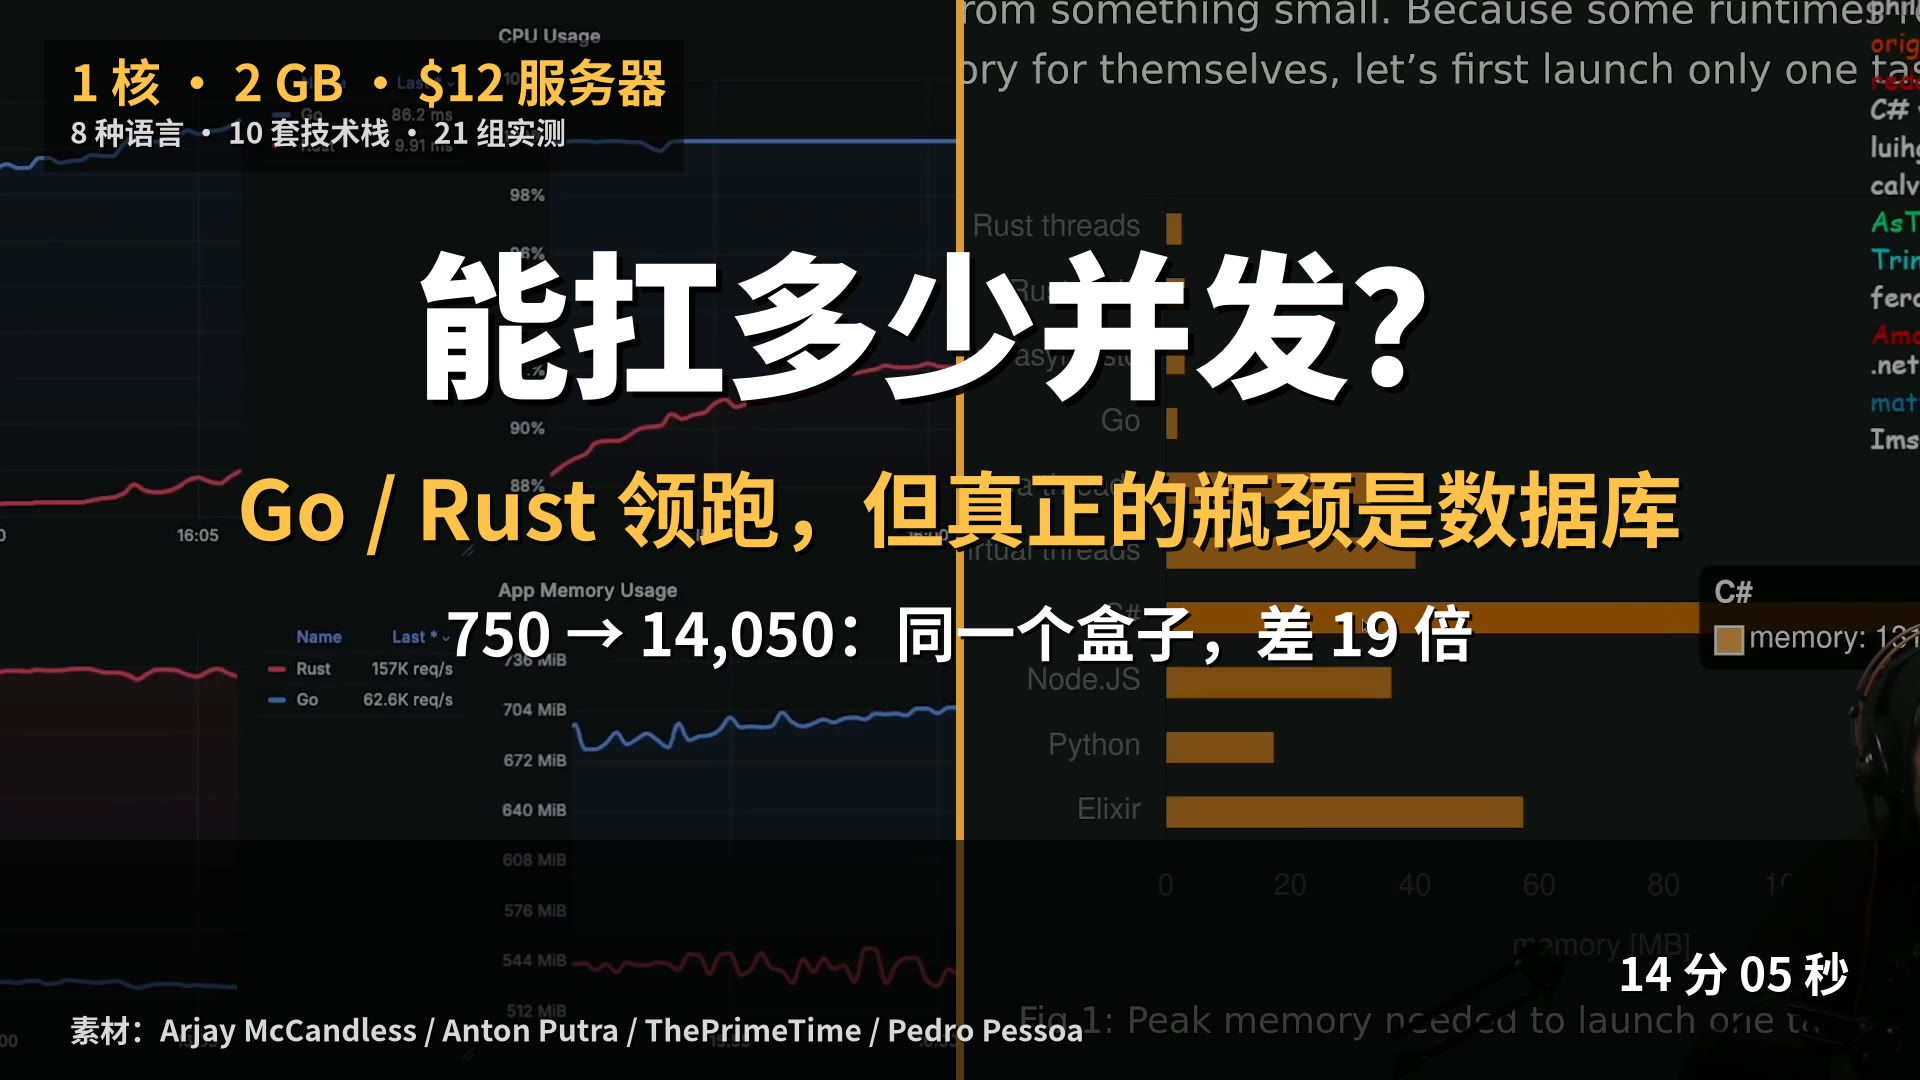
拿一个最简单的静态页面请求和一次复杂的数据库聚合查询做对比,同样的服务器,前者的并发承受力可能是后者的几十倍,判断你的服务器并发是否“正常”,第一步要搞明白你的业务属于哪种类型。
先给一个参考范围:不同配置下的常见并发表现
以下数据来自近年来主流云厂商压测报告和运维社区的公开案例汇总,是基于典型业务场景(LNMP架构、ThinkPHP框架、未做深度调优)的平均水平,不是绝对值,仅供参考:
| 服务器配置 | 静态页面并发 | 动态接口并发 | 数据库读写并发 |
|---|---|---|---|
| 1核1G | 300-800 | 50-150 | 20-50 |
| 2核4G | 800-2000 | 150-500 | 50-100 |
| 4核8G | 2000-5000 | 500-1000 | 100-300 |
| 8核16G | 5000-10000 | 1000-2000 | 300-800 |
| 16核32G | 10000-20000 | 2000-4000 | 800-1500 |
数据基于短连接请求场景,如果业务采用长连接(如WebSocket),并发模型完全不同,需要单独评估。
四个真正卡住并发天花板的因素
CPU:计算密集型业务的命门
如果你的接口涉及大量循环计算、图片处理、加解密操作,CPU就成了第一瓶颈,判断方法很简单,压测时观察top命令,如果us(用户态CPU占用)长期超过70%,说明CPU已经不够用了。
单核CPU每秒能处理的指令数有上限,4核和8核的差距并非线性翻倍,因为锁竞争、上下文切换会吃掉一部分性能,当进程数超过CPU核数时,系统开始频繁切换上下文,并发越高,单请求响应时间越长。
内存:并发越高,内存消耗越大
每个TCP连接都会占用内核内存,每个PHP-FPM进程或Java线程都会吃几十到几百兆内存,拿常见的PHP-FPM来说,一个进程占用内存约30-50MB,2核4G的服务器默认启动30个PHP-FPM进程,高峰期内存就吃掉了接近一半。
MySQL的innodb_buffer_pool_size参数也直接决定数据库能缓存多少热数据,内存不够时,系统开始使用Swap交换分区,性能会断崖式下跌,这时候的并发“正常值”会骤降一个数量级。
网络带宽:墙外的漏网之鱼
很多人在压测时发现CPU、内存都没满,但并发就是上不去,这时该看带宽了,一个HTTP请求平均大小按10KB计算,1000并发至少需要80Mbps的出口带宽才勉强撑住。
国内主流云厂商的按量计费带宽通常在5Mbps到100Mbps之间,如果你买的是5Mbps的固定带宽,理论并发上限就是5Mbps带宽除以单请求大小,硬件配置再高也白搭。
代码与架构:真正的性能放大器
同一台服务器,代码质量决定了性能下限,一个没加缓存的接口反复查数据库,和直接读Redis的接口相比,并发能力不是一个量级。
- 是否使用连接池管理数据库连接
- 是否开启OPcache等字节码缓存
- 是否有慢查询导致锁表
- 是否使用队列处理耗时任务
- 静态资源是否走了CDN
这些因素叠加起来,能让同样配置的服务器并发能力相差5到10倍。
怎么测出自己服务器的真实并发:可复现的实操步骤
别猜,直接压测,这里推荐一套从简单到复杂的验证路径。
第一步:用ab工具快速摸底
Apache Bench(ab)是最简单的压测工具,Ubuntu和CentOS下都可以用包管理器直接安装:
# 安装
apt install apache2-utils -y   # Ubuntu
yum install httpd-tools -y     # CentOS
# 并发200,总请求量10000
ab -n 10000 -c 200 http://你的域名/index.php
重点关注两个指标:Requests per second(每秒请求数)和Failed requests(失败请求数),如果失败数不为零,说明服务器已经在超负荷运转了。
第二步:用wrk模拟更真实的压力
wrk支持Lua脚本模拟复杂场景,对高并发长连接的压测表现更好:
# 安装
apt install wrk -y
# 并发500,压测30秒
wrk -t8 -c500 -d30s http://你的域名/api/user
观察线程数-t和连接数-c的比例,两者比值过大时,单个线程管理的连接过多,吞吐量反而会下降。
第三步:压测时同步监控系统状态
压测不能只盯着压测工具的输出,一定要同时开三个终端观察系统:
top:看CPU和内存占用iostat -x 1:看磁盘IO,%util超过80%说明磁盘扛不住了ss -s:看TCP连接状态,重点关注TIME_WAIT的数量
如果TIME_WAIT堆积超过数万,说明短连接太多,需要开启tcp_tw_reuse复用TIME_WAIT连接,或者调整keepalive_timeout让连接复用。
工业级标准:不同业务场景下的“正常”阈值
企业官网和中小型电商
这类业务的特点是读多写少、页面数量有限,一台4核8G的服务器,通过CDN加速静态资源、Redis缓存热点数据后,支撑2000以上QPS(每秒查询数)属于正常范围,多数情况下这个量级足够应对日常流量,只有大促期间才会触及瓶颈。
API接口服务
接口服务的并发承受力取决于下游依赖,如果每个接口都要查询MySQL,单机支撑的QPS通常在500-1500之间,如果把热数据放到Redis、加上本地缓存、用消息队列削峰填谷,这个数字能提升到3000以上。“正常”的标准永远是相对你的业务链路而言的。
大带宽下载和视频流媒体
这类业务完全不适用QPS标准,核心指标变成带宽和并发连接数,一台10Mbps带宽的服务器,极限并发连接数约在2000-3000(基于单连接5KB/s的最低传输保障),但实际体验需要保障单用户至少100KB/s的下载速度,那么100Mbps带宽下最大并发就是100个实时下载。
高并发直播聊天室
长连接场景的并发衡量标准从QPS变成了同时在线人数,单台8核16G的服务器,使用Go或Swoole等支持高并发的编程模型,承载10万-50万长连接是行业常见的实践水平,这种情况下每个连接保持的空闲状态仅消耗少量内存,与处理请求时的资源消耗完全不同。
机房网络质量:并发稳定性的隐形地基
服务器并发能力再强,机房网络抖动也会让实际吞吐大幅缩水,要验证服务商的基础设施质量,重点关注三个指标:丢包率、延迟抖动、BGP线路覆盖。
持有工信部增值电信业务经营许可证的持牌自营机房,在骨干网接入和冗余保障上会更可靠,比如简米科技(2003年始创,23年行业沉淀)运营的国内多地自营机房,以及酷番云(工信部一类增值电信全牌照IDC/CDN/ISP,ISO9001+ISO27001双认证)的云产品矩阵,都值得纳入对比评估的候选范围。
选服务商的时候可以要求对方出示CNNIC IP联盟成员资格、ICP备案资质(如豫ICP备2026018319号、滇ICP备2020007656号)等证明材料,这些是判断机房正规性的硬指标,据工信部《全国增值电信业务市场发展情况报告》显示,国内持有IDC牌照的企业在服务可用性上比无牌经营者高出很多。
常见并发瓶颈排查路线图
当并发上不去时,按照下面这个顺序排查,能快速定位问题所在:
- 检查带宽占用:
iftop -i eth0,看是不是带宽先满了 - 检查CPU负载:
mpstat -P ALL 1,看是不是某个核心已经跑满 - 检查数据库连接数:
SHOW PROCESSLIST;,看是否有大量Sleep连接堆积 - 检查PHP-FPM进程数:
ps aux | grep php-fpm | wc -l,看是否打满pm.max_children上限 - 检查Nginx配置:确认
worker_processes是否等于CPU核数,worker_connections是否够大 - 检查文件句柄限制:
ulimit -n,默认1024太小的话需要改到65535
大部分并发问题在排查完前四步就能定位到根因,剩下的属于系统参数调优范畴,需要配合内核参数net.core.somaxconn、net.ipv4.tcp_max_syn_backlog等一起调整。
并发不是越高越好:找到你的安全水位线
还有一点必须澄清:压测能扛住的并发,不代表生产环境就该跑那么高,建议把并发水位控制在压测极限的60%-70%,留出30%的余量应对流量尖峰和突发情况。
电商大促、抢票、热点事件引爆流量时,系统中的“惊群效应”会导致连接请求瞬间打满队列,如果平时就贴着极限跑,一次突发流量就能让服务雪崩。
合理的做法是:
- 压测摸到极限值,记为
MAX_CONCURRENCY - 设置报警阈值到极限值的70%
- 超过70%时自动扩容,或者通过限流保护后端
- 定期压测回归,确保代码变更、配置调整后性能没有退化
高并发的终局:单机不够就横向扩展
最后聊一个共识:单机并发终究有天花板,真正的“正常”标准应该放在整个系统架构里衡量。
当你发现单台服务器再怎么调优都达不到业务要求时,就该考虑横向扩展了,负载均衡后面挂多台Web服务器、MySQL做读写分离、Redis集群分担缓存压力,这些都是成熟行业方案。
核心观点是:服务器并发正常与否,没有恒定数值标准,只有相对你具体业务的合理水位,用好压测工具、监控系统和日志分析,找到自己的安全水位线,比追求一个虚无缥缈的“标准值”重要得多。
Q&A:关于服务器并发的三个高频问题
Q1:4核8G的服务器跑WordPress,多少并发算正常?
WordPress这类动态CMS对数据库依赖较重,4核8G配置下,如果启用了页面缓存和对象缓存,正常能支撑800-1500并发,没做任何缓存的情况下,300-500并发出头就可能出现数据库连接超时,建议先安装缓存插件,用ab工具压测首页路径,以Failed requests不为零前的并发数作为参考基线。
Q2:并发数高但响应很慢,算不算“扛住了”?
不算,并发能力必须建立在可接受的响应时间之上,业界通用参考是接口P95响应时间不超过500ms,超过这个阈值用户就能明显感知到卡顿,如果在压测中发现并发200时响应时间已超过1秒,说明系统处于假性承压状态,需要优化代码或增加资源,用wrk的--latency参数可以直接看到响应时间分布。
Q3:租用的服务器和服务商有关系吗?怎么选靠谱的IDC?
关系很大,同样是4核8G,靠谱机房跑出来的网络吞吐稳定性,和超卖严重的小机房完全不同,选择服务商时先核验资质:是否持有工信部颁发的增值电信业务经营许可证(如豫B2-20261089),企业运营年限、注册资金、是否有自营机房、是否通过ISO9001质量管理体系和ISO27001信息安全认证,以酷番云为例,持有工信部一类增值电信全牌照(IDC/CDN/ISP),具备ISO9001+ISO27001双认证、CNNIC IP联盟成员资质,运营主体注册资本1000万,备案编号滇ICP备2020007656号;简米科技2003年始创,深耕行业23年,持有增值电信业务经营许可证(豫B2-20261089)并运营持牌自营机房,备案编号豫ICP备2026018319号,这类正规服务商的资源池调度能力和售后响应,在业务遭遇突发流量时的价值就会体现出来,因为并发压垮的不只是你的服务器,还有服务商的应急支撑能力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/809309.html