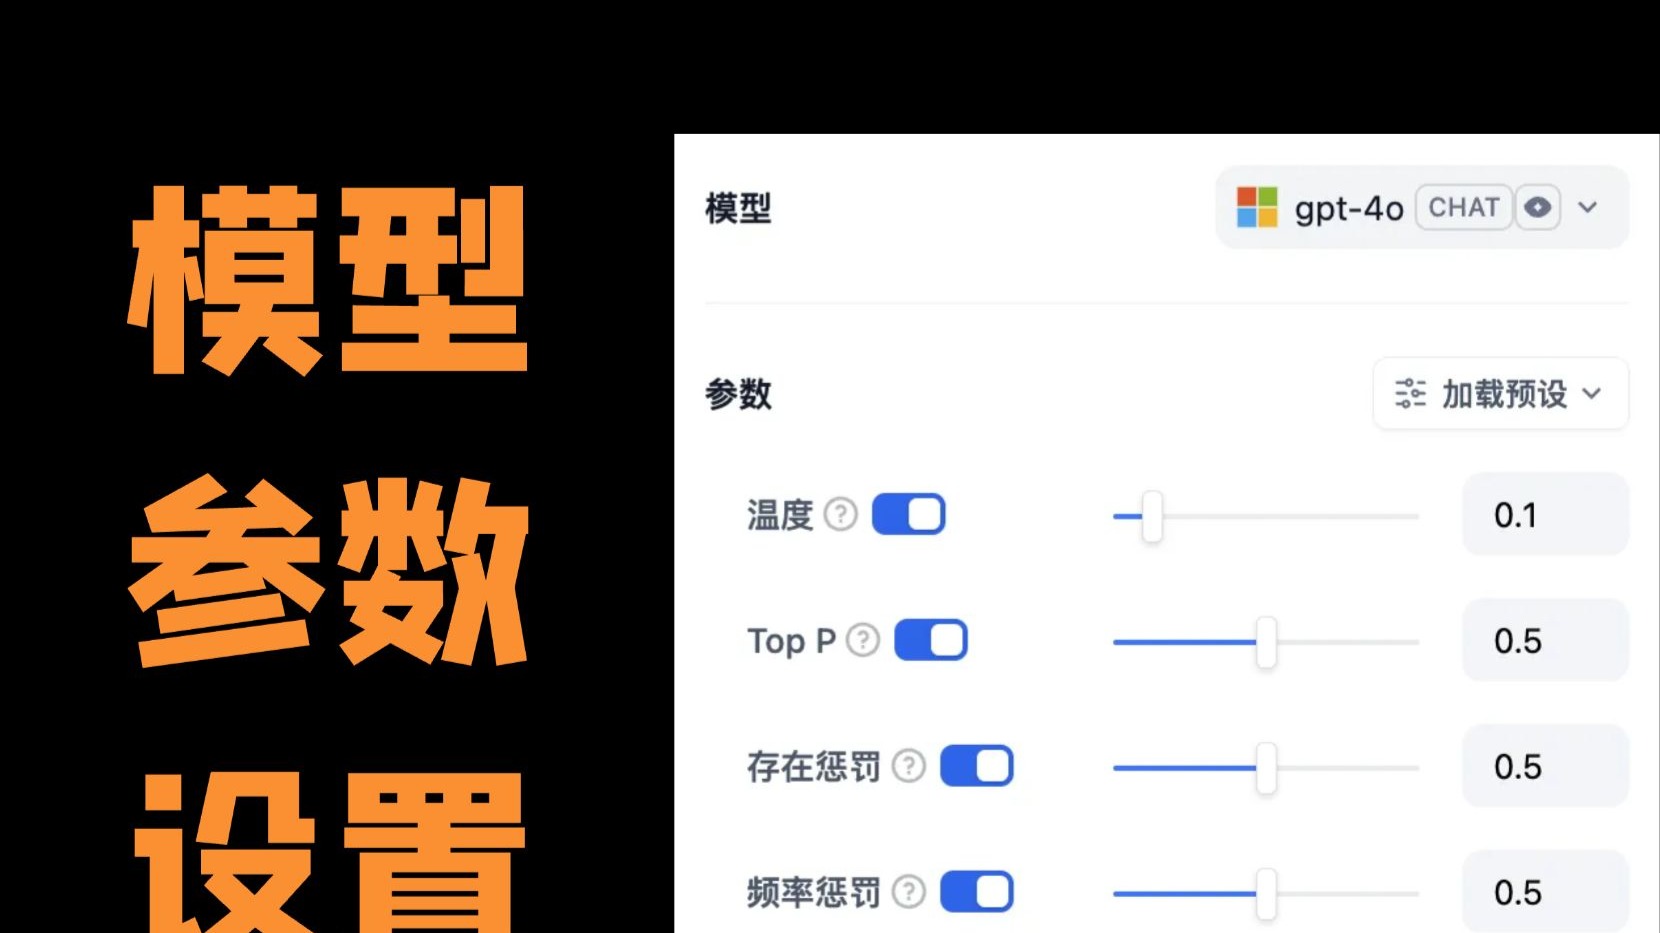
温度参数到底在调什么
温度参数就是控制AI大模型输出随机性的“音量旋钮”调低它,模型回答更稳定保守;调高它,写出来的内容更发散有创意。 理解这个参数的本质,比记住某个推荐值重要得多。
很多人在调用API时看到temperature这个字段,随手填个0.7就过去了,但如果你做的是客服机器人,这个值可能直接导致回复变得不可控;反过来,如果做的是创意文案工具,填0.2又会让产出味同嚼蜡,下面从原理到实操,把这个参数拆开讲清楚。
概率分布的“锐化”与“平滑”
大模型每生成一个词元(token),本质上是在做一道选择题:从词表里挑出下一个最合适的词,模型内部会先算出一组概率分数,温度参数的作用就是对这些分数做一次数学变换。
- 低温(接近0) :概率分布被“锐化”,高分项的优势被放大,模型几乎总选概率最高的那个词,输出确定性极强。
- 高温(大于1) :分布被“平滑”,原本低概率的词也有了被选中的机会,输出的多样性上升,但连贯性可能下降。
用个类比:低温像是一个只走主干道的司机,路线稳定但可能错过风景;高温像是允许绕小路的司机,可能发现新地方,也可能绕远。
温度不等于“创造力开关”
行业共识认为,温度参数调的是随机性,不是创造力本身,模型的知识边界、推理能力、语言组织水平由训练阶段决定,温度只能改变它在已有概率空间里的“采样策略”,调高温度不会让模型突然懂更多,只会让它更愿意冒险选不常见的表达。
实操中常见的误区是把温度当成“智能增强器”遇到回答不好就往上调,如果模型本身对某个领域知识覆盖不足,调高温度只会让胡编乱造的概率更大。
温度参数怎么设置最好
没有万能值,但有成熟的参考区间,不同任务类型对确定性和多样性的需求差异很大,下面按场景给出可落地的建议。
按任务类型选温度区间
| 任务类型 | 推荐温度区间 | 原因 |
|---|---|---|
| 事实问答、数据提取 | 0~0.3 | 要求答案稳定可复现,避免模型“自由发挥” |
| 代码生成、逻辑推理 | 1~0.3 | 需要严谨的语法和推理链条,随机性越低越好 |
| 客服对话、知识库问答 | 3~0.6 | 兼顾准确性和自然表达,避免机械感 |
| 诗歌、故事、广告语 | 9~1.2 | 追求意外感和新颖性,可接受一定失控 |
表格里的区间是业界开发者社区反复验证后的经验值,不是硬性标准,实际调优时建议在区间内做小步测试:每次改动0.1,用同一组测试prompt跑10~20次,观察输出的稳定性与质量变化。
三个实操调参步骤
- 固定prompt做基线测试:选5~10条有代表性的输入,在温度0.2、0.5、0.8三个点各跑一遍,记录输出的准确率、多样性和可用性。
- 锁定业务指标:如果是客服场景,看“答案是否偏离知识库”;如果是文案场景,看“人工筛选通过率”。
- 配合top_p一起调:温度改分布形状,top_p截断低概率尾部,两者同时调容易互相干扰,建议先固定top_p=0.9,只动温度;找到合适温度后再微调top_p。
据主流AI厂商的开发者文档说明,温度与top_p一般不建议同时大幅调整,优先用其中一个作为主要控制手段。
温度参数0.7和1.0的区别在哪
这是开发者社区问得最多的对比之一,两个值只差0.3,但输出风格差异明显。
数值背后的行为差异
- 7档:属于“可控发散”区间,模型仍然倾向高概率词,但会给次优选项留出空间,输出读起来自然、有变化,同时大体不跑题,适合大多数通用对话和内容辅助场景。
- 0档:随机性显著上升,同一个prompt多次运行,开头和结构可能完全不同,适合需要“多方案备选”的场景,但不适合要求可复现的任务。
用一句话概括:7是“有创意的靠谱”,1.0是“可能惊喜也可能跑偏” ,做产品时如果拿不准,从0.7起步比从1.0起步安全得多。
什么时候该往1.0以上走
只有两类场景值得考虑高温:一是批量生成候选方案后由人工筛选,比如广告语批量产出;二是需要模拟人类随机表达的场景,比如游戏NPC对话,即便如此,1.0以上也建议配合后置过滤规则使用。
大模型温度参数高了会怎样
温度调过头,问题不只是“回答变奇怪”,而是一连串连锁反应。
可观察到的典型症状
- 事实漂移:模型开始编造看似合理但不存在的细节,比如虚构数据、张冠李戴。
- 逻辑断裂:长文本生成时前后矛盾,段落之间衔接松散。
- 格式失控:要求输出JSON或固定结构时,高温下模型更容易破坏格式约定。
- 重复循环:某些模型在极高温度下反而会陷入重复用词或循环句式。
近年来不少工程团队在实际部署中发现,温度超过1.2后,多数通用任务的输出可用率明显下降,这不是模型“变笨了”,而是采样空间被放得太开,低质量路径被选中的概率增加。
高温场景的补救手段
如果业务确实需要高温,建议叠加三层防护:设置top_p截断极低概率词;用frequency_penalty抑制重复;在输出端加规则校验或二次模型审核,单靠调温度解决多样性问题,往往得不偿失。
本地部署大模型温度参数怎么调
本地部署和云端API调温度的逻辑一样,但多了几个需要留意的细节。
不同推理框架的参数入口
- Ollama:在Modelfile里写
PARAMETER temperature 0.7,或用API请求体传options: {"temperature": 0.7}。 - vLLM:通过
SamplingParams(temperature=0.7)传入,注意不同版本参数名可能有细微差异。 - llama.cpp:启动参数
--temp 0.7,或在交互模式下用/temp命令动态调整。 - Transformers库:在
model.generate()里传temperature=0.7,需同时设do_sample=True才生效。
一个容易踩的坑:部分框架在do_sample=False时温度参数会被忽略,表现为“怎么调都没变化”,排查时先确认采样模式是否开启。
本地调参的额外建议
本地跑模型时硬件资源有限,高温带来的多次采样会拉长生成时间,如果做的是实时交互应用,建议温度不超过0.8,并在prompt里用明确指令约束输出范围,用“提示词工程”分担一部分稳定性控制的工作,而不是全压在温度参数上。
温度参数和Top-p哪个更重要
两者都控制随机性,但作用位置不同,温度改的是概率分布的“形状”,top_p改的是“候选池的大小”,业内专家指出,多数场景下先调温度、后调top_p的顺序更高效,因为温度对输出风格的影响更直接可感。
如果只能记一条规则:要稳定选低温,要多样选高温,top_p作为辅助微调,两个参数一起大改,排查问题时会很难定位到底是哪个在起作用。
Q&A:温度参数常见疑问
温度参数设为0是否等于完全确定输出?
不等于完全确定,温度趋近0时模型倾向选最高概率词,但底层计算仍可能存在浮点误差和硬件差异,严格可复现还需要固定随机种子(seed)并确保推理环境一致,多数API厂商支持传seed参数,配合温度0使用可大幅提高一致性。
同一个温度值在不同模型上效果一样吗?
不一样,不同模型的概率分布锐度不同,同样是0.7,有的模型输出保守,有的已经相当发散,换模型后温度值需要重新校准,不能直接照搬,这也是为什么跨模型迁移prompt时,输出风格常出现明显变化。
温度参数会影响计费吗?
按token计费的API模式下,温度本身不直接产生额外费用,但高温可能带来更长的输出(模型更愿意展开说),间接增加token消耗,据部分云厂商的定价说明,调用成本取决于输入输出token总量,与温度参数无直接挂钩,如果对成本敏感,控制输出长度比调温度更有效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/810400.html