GPU服务器分布式渲染的核心在于通过高速网络将多台GPU节点的算力池化,由调度软件统一分配渲染任务,让原本一台机器需要跑几天的镜头缩短到几小时,前提是场景支持拆帧或分块,否则分布式无从谈起。
gpu服务器分布式渲染怎么配置才稳定
很多团队第一次尝试分布式渲染,不是死在算力不够,而是死在网络瓶颈和软件调度冲突上,配置一套稳定可用的分布式渲染集群,本质上是在解决三件事:任务怎么拆、数据怎么传、结果怎么合。
硬件层面的基础认知
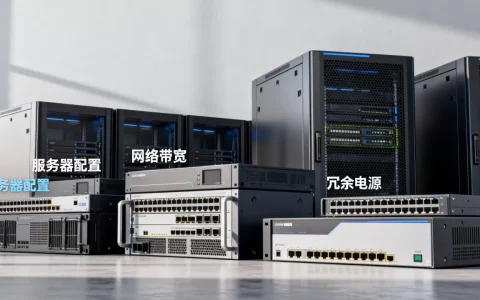
分布式渲染的硬件架构和单机渲染有本质区别,单机拼的是显卡数量和显存容量,分布式拼的是节点间的协同效率。
| 配置项 | 单机渲染方案 | 分布式渲染方案 |
|---|---|---|
| GPU数量 | 4-8张(受物理空间限制) | 16-128张(可扩展) |
| 显存要求 | 单卡越大越好 | 各节点均衡即可 |
| 网络要求 | 无特殊要求 | 万兆内网起步 |
| 存储方案 | 本地硬盘 | 共享存储(NAS/SAN) |
| 调度软件 | 无需 | 必选(Deadline/Thinkbox) |
行业共识认为,网络延迟超过1毫秒就会明显影响分布式渲染效率,所以千兆交换机在这个场景下基本不可用,万兆内网是入门配置。
操作系统与驱动层的坑
Windows和Linux在分布式渲染上的表现差异,比多数人想象的更大,Windows节点配置方便,但长时间高负载运行时的稳定性不如Linux,如果你用的是Blender Cycles或Redshift,Linux节点配合NVIDIA驱动和CUDA环境,内存管理和GPU利用率都更干净。
需要特别提醒的是驱动版本必须全集群统一,混用不同版本的NVIDIA驱动,轻则节点掉线,重则渲染结果出现随机噪点,排查起来极其痛苦。
分布式渲染和单机渲染哪个快取决于场景
不少人误以为分布式渲染是万能的,实际上它只在特定任务上才能发挥优势。
帧序列渲染:分布式的主场
动画项目的每一帧都是独立图像,可以毫无压力地分配给不同节点,一个300帧的镜头,50台GPU节点每台渲染6帧,理论上接近50倍加速,这是分布式渲染最具性价比的应用场景。
单帧高分辨率渲染:分块渲染有代价
单张8K静帧,可以切成多个tile分给不同节点,但tile之间的边缘过渡需要重叠采样,这会带来约5%-15%的额外计算量,镜面反射、景深、全局光照等效果在tile边界容易出现接缝,需要软件层面的融合算法处理,并非所有渲染器都支持得完美。
不适合分布式的场景
- 单帧场景文件超过20GB且IO速度跟不上
- 需要频繁交互调参的预览渲染
- 依赖单张GPU显存承载整个场景的极复杂模型
分布式渲染gpu服务器配置要求详解
基于实际落地经验,一套8节点起步的分布式渲染集群,配置上有明确的硬性指标和弹性选择。
计算节点的三种选型思路
第一种:双卡高主频型,适合CPU和GPU混合渲染,比如V-Ray的GPU+CPU混合模式,两颗高频至强搭配两张RTX 4090或RTX 6000 Ada,能兼顾场景准备阶段和实际渲染阶段。
第二种:四卡算力堆砌型,4张RTX 4090或A6000组合,常见于Redshift和Octane的玩家,NVLink的显存共享效果在此类配置中意义不大,更关键的是PCIe通道要足够充裕。
第三种:八卡集群计算型,A100或H800级别,通常用于云渲染农场或大型视觉特效公司,价格昂贵但单卡吞吐量惊人,适合影视级复杂场景。
存储与IO的决窍
节点数量上来后,最容易被低估的是存储IO,每个节点同时读取纹理、写入渲染结果,共享存储的吞吐量必须高于所有节点读写需求的总和。
推荐方案是一台独立的存储服务器,配备多块NVMe SSD组RAID 5或RAID 10,通过万兆或25G网络接入渲染集群,如果预算有限,至少也要用千兆多网口绑定(Link Aggregation)的方式,避免单点瓶颈。
网络拓扑的实操建议
- 计算网络和存储网络物理分离,避免彼此抢占带宽
- 使用三层交换机或更高端设备,保证东西向流量(节点间通信)的转发效率
- 管理网络(用于控制和监控)可以走千兆,但数据面必须万兆以上
blender分布式渲染配置的完整流程
Blender是免费软件中分布式渲染做得比较完善的,以Blender 4.x配合Blender Studio的渲染调度方案为例,配置步骤如下。
第一步:共享存储挂载
所有渲染节点需要能访问同一个项目文件夹,最简单的方式是NFS共享:
# 主节点上配置NFS共享
echo "/data/render 192.168.1.0/24(rw,sync,no_subtree_check)" >> /etc/exports
exportfs -a
# 渲染节点上挂载
mount -t nfs 192.168.1.100:/data/render /mnt/render
这个步骤的核心价值在于让所有节点看到一模一样的文件路径,否则任务调度时会在一半节点上报错。
第二步:启用Blender内置的网络渲染
Blender 4.x自带Shared Memory和Network Render功能,但你更需要的是第三方调度器,最常用的免费方案是 Blender的Flamenco,它由Blender Studio开发,支持任务队列、依赖关系和错误重试。
# 安装Flamenco(主节点)
flamenco-manager configure
flamenco-manager start
第三步:测试与验证
用你的项目文件做一个小规模测试,先分配5帧给两个节点,确认输出结果完全一致后再全量提交,行业实践表明,这一步能规避后面大排队的返工风险。
分布式渲染集群搭建的费用参考
关于gpu服务器租用价格,不同地域、不同配置差异显著,以一个基础的4节点集群(每节点4张RTX 4090)为例:
| 方案 | 月成本区间 | 适用阶段 |
|---|---|---|
| 自建机房(含电费/运维) | 中等偏高 | 长期固定项目 |
| 苏州gpu服务器租用 | 中高 | 本地工作室就近使用 |
| 上海/北京机房托管 | 偏高 | 需低延迟访问 |
| 云渲染按量计费 | 弹性 | 峰值期扩充算力 |
如果只是短期项目需求,租用按小时计费的GPU服务器显然比自购更划算,但如果是影视公司长期有渲染任务,自建集群在一年半左右可以收回设备成本。
分布式渲染gpu服务器常见故障排查
实际运行中,以下问题是出现频率最高的。
节点掉线
先检查网络稳定性,再确认是否因为散热不良导致GPU温度过高自动降频,用nvidia-smi查看各卡温度,超过85摄氏度就需要加强散热。
渲染结果不一致
不同节点渲染出的帧噪点形态不同,通常是渲染器版本或驱动版本不一致导致的确定性差异,逐个核对所有节点的软件环境,尤其是Cycles的OptiX加速版本。
传输速度远低于预期
用iperf3测试两个节点间的实际带宽,如果达不到万兆线速(通常需达到4Gbps以上),优先检查网卡固件、交换机端口配置和网线质量。
分布式渲染分布式渲染任务调度策略
调度器是分布式渲染的中枢神经,没有它,节点再多也只是散沙,主流的调度器有Thinkbox Deadline、AWS Thinkbox、Pulse和开源的Flamenco。
优秀的调度策略需要做到:任务自动分发、负载均衡、容错重试,当某个节点渲染任务失败时,调度器会自动把该任务重新分配给其他健康节点,并记录错误日志供排查。
实际生产中,建议优先级设置为:镜头完成期限 > 渲染成本 > GPU利用率,不要让调度器一味追求GPU跑满,否则可能出现一个镜头全部渲染完、另一个镜头还剩一半的情况。
关于gpu服务器分布式渲染的常见疑问解答
分布式渲染对显卡品牌有要求吗?
有,不同渲染器对GPU品牌的支持不同,Blender Cycles和Redshift对NVIDIA的CUDA和OptiX支持最完善,AMD的ProRender和HIP生态相对小众,多数情况下,NVIDIA GPU是分布式渲染的稳妥选择,且显存容量比核心数量更关键,因为场景需要整体载入显存。
渲染农场与本地分布式集群的本质区别是什么?
渲染农场本质上就是一个大型分布式渲染集群,只是由服务商统一运维,本地集群的优势是数据不出公司内网,安全性和可控性更好;云渲染农场的优势是弹性伸缩,高峰期可快速申请数百节点,项目结束后释放,无需承担闲置成本。
分布式渲染的加速比能达到什么水平?
理论上节点翻倍,渲染时间减半,但实际加速比受任务分解粒度、网络传输开销、存储IO能力三方制约,多数情况下,8节点集群能获得5-6倍实际加速,16节点时加速比可能降至7-8倍,继续增加节点需要同步升级集群的网络和存储架构,否则收益会持续递减。
GPU服务器分布式渲染的最终价值在于用并行计算换取时间,而一套成熟稳定的集群,需要把硬件选型、网络架构、软件调度和存储方案作为一个整体来规划,从一个小规模集群开始,逐步扩容,比一开始就建大集群更容易发现并解决瓶颈,也更容易控制初期投入成本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/810755.html