清华gml大模型入门该怎么学?清华gml大模型学习路线推荐

想要高效掌握清华GLM大模型,核心路径在于“理论筑基、源码深挖、实战演练”的三位一体循环学习法。不要试图一开始就通读所有论文,也不要盲目调用API而不求甚解,最稳妥且高效的学习策略是:先建立对Transformer架构和GLM独特双向注意力机制的认知,随后深入研读GitHub上的官方开源代码,最后通过微调或部署具体项目来固化知识。这一路径能帮助学习者在最短时间内跨越从“听说过”到“会使用”甚至“能优化”的鸿沟。

清华gml大模型入门该怎么学

夯实地基:理解GLM的核心架构原理

任何大模型的学习都离不开对底层逻辑的洞察,GLM之所以在学术界和工业界备受推崇,关键在于其独特的架构设计。

  1. 掌握Transformer基础:这是所有大模型的基石,必须熟悉Self-Attention机制、位置编码以及前馈神经网络(FFN)的工作原理。
  2. 深入理解GLM的架构创新:GLM并非简单的Decoder-only架构,它提出了一种基于自回归空白填充的预训练模型,你需要重点理解它如何结合了BERT的编码能力和GPT的生成能力,这种“双向注意力+自回归生成”的混合特性,是GLM在NLU(自然语言理解)和NLG(自然语言生成)任务上表现优异的根本原因。
  3. 研读关键论文:精读《GLM: General Language Model Pretraining with Autoregressive Blank Infilling》是必修课,这能让你从理论层面理解模型的优化目标。

源码深挖:从配置文件到模型实现

理论只是空中楼阁,代码才是落地的根本,THUDM(清华KEG实验室)在GitHub上开源的GLM系列代码是最好的教材。

  1. 环境搭建与依赖管理:建议使用Conda创建独立的虚拟环境,严格对应PyTorch版本和CUDA版本。环境配置是新手最容易卡壳的环节,务必仔细阅读官方README中的版本要求。
  2. 剖析模型代码结构:不要只看run脚本,要深入modeling_glm.py或相关模型文件,重点关注以下几个模块:
    • Attention Mask的实现:看GLM是如何通过特殊的Mask矩阵来实现双向上下文感知的。
    • 位置编码:理解GLM使用的2D位置编码策略,这是处理长序列的关键。
    • Prefix Language Model:理解GLM如何处理Prefix任务,这与普通的Causal LM有何不同。
  3. 调试与追踪:利用PyCharm或VS Code的调试功能,在模型前向传播的关键节点打断点,观察Tensor维度的变化。这种“动态追踪”比静态阅读代码效率高出数倍。

实战演练:从推理部署到微调优化

清华gml大模型入门该怎么学

学习的最终目的是应用,通过解决实际问题来反向驱动知识体系的完善。

  1. 模型推理与部署:
    • 初学者可从Hugging Face Transformers库调用GLM系列模型开始,熟悉Tokenizer和Model的加载流程。
    • 进阶学习应涉及模型量化技术,如使用bitsandbytes进行4-bit量化,降低显存占用,实现在消费级显卡上的本地部署。
  2. 高效微调技术(PEFT):
    • LoRA(Low-Rank Adaptation)是目前性价比最高的微调方案,学习如何在GLM架构上挂载LoRA适配器,冻结主干参数,仅训练少量参数即可适配下游任务。
    • 尝试构建指令微调数据集,通过SFT(监督微调)让模型具备特定的对话风格或领域能力。
  3. 项目实战案例:选择一个具体场景,如构建垂直领域的知识库问答系统,结合LangChain等框架,将GLM作为基座模型,实现RAG(检索增强生成)应用。这一过程将串联起Prompt Engineering、向量数据库检索、模型调用等多个技能点。

避坑指南与经验总结

在探索清华gml大模型入门该怎么学?我的经验分享这一话题时,许多初学者容易陷入误区,以下几点需格外警惕:

  1. 避免陷入“论文海”:不要在没有复现基础的情况下过度纠结于数学推导的细节,先跑通Demo,再回头补理论。
  2. 硬件资源规划:GLM-6B等模型虽然门槛降低,但微调仍需一定显存支持,若资源有限,应优先掌握量化技术和参数高效微调,而非全量微调。
  3. 关注社区动态:大模型迭代极快,ChatGLM系列更新迅速,要时刻关注官方GitHub的Issue和Release,很多报错在社区内已有成熟解决方案。

相关问答模块

问:学习清华GLM大模型需要什么样的硬件配置?
答:这取决于学习阶段,如果仅进行推理体验,消费级显卡(如RTX 3060 12G)甚至通过CPU量化推理即可满足需求,若涉及全量微调,建议使用A100或A800等企业级显卡;对于个人开发者,推荐使用LoRA等微调技术,RTX 3090或4090(24G显存)即可完成大部分微调任务。

清华gml大模型入门该怎么学

问:GLM模型与Llama等主流模型相比,最大的优势是什么?
答:GLM最大的优势在于其独特的架构设计,特别是在中文语境下的理解能力,相比于Llama等Decoder-only模型,GLM的预训练目标使其在处理NLU任务(如文本分类、实体抽取)时往往表现更佳,同时其架构对长文本处理也有特定的优化,非常适合中文自然语言处理场景。

如果您在学习过程中有独特的见解或遇到了难以解决的问题,欢迎在评论区留言交流。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/98620.html

赞 (0)
PV、PVC和StorageClass有什么区别?K8s存储原理详解
上一篇 2026年3月17日 05:49
asp网站的安全性如何保障,asp网站安全漏洞怎么修复
下一篇 2026年3月17日 05:51

相关推荐

  • 飞机安225大模型到底怎么样?值得入手吗?

    安225大模型在当前静态模型收藏圈中属于顶级梯队的产品,其核心价值在于极致的还原度与巨大的视觉冲击力,但同时也伴随着高昂的价格门槛与严苛的运输保存要求,对于航空迷而言,这是一款不可多得的镇柜之宝;但对于入门级玩家,其复杂的组装结构与脆弱的零件可能带来挫败感,综合来看,这是一款优缺点极其鲜明的“硬核”收藏品,适合……

    2026年3月5日
    13900
  • 套CDN绕开备案能成功吗?不备案域名如何接入CDN

    使用CDN绕开备案在2026年已属于高风险违规操作,不仅无法真正规避监管,反而会导致网站被强制关停、IP被封禁,甚至面临法律追责,合规备案才是唯一合法且稳定的解决方案,很多站长在搭建新站时,听到“备案”二字就感到头疼,觉得流程繁琐、周期漫长,市面上流传着一种“捷径”:购买境外的CDN服务,将域名解析到海外节点……

    2026年6月14日
    3000
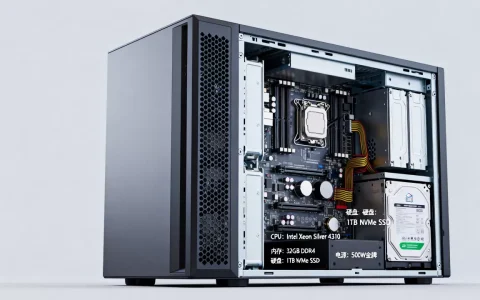
  • 服务器一般什么配置才够用,怎么选性价比高?

    服务器配置没有统一标准,完全取决于你的业务负载,但无论做网站、跑数据库还是部署应用,核心配置始终围绕CPU、内存、硬盘、网络和系统冗余这五个维度展开,服务器一般什么配置?拆解核心硬件这个问题的答案必须放到具体场景里才有意义,一台只跑静态页面的网站服务器和一台处理高并发交易的数据库服务器,配置天差地别,但无论场景……

    2026年8月2日
    300
  • npm安装cdn,npm安装cdn报错怎么办

    在2026年的前端工程化体系中,通过npm安装CDN资源并非直接操作,而是采用“npm管理依赖源码 + Webpack/Vite构建打包 + CDN分发静态资产”的混合架构,这是兼顾开发效率与线上性能的最佳实践,随着Web应用复杂度的指数级增长,单纯依赖第三方CDN链接或完全本地化存储已无法满足现代开发需求,2……

    2026年6月13日
    4910
  • 无显卡Ai大模型好用吗?本地运行卡不卡?

    无显卡运行AI大模型完全可行,且在特定场景下体验极佳,核心在于“选对模型”与“优化部署”,经过半年的深度体验与测试,结论非常明确:对于绝大多数非专业绘图、非超大参数训练的普通用户和开发者而言,无显卡方案不仅够用,甚至在成本与便捷性上完胜传统显卡方案,这并非妥协,而是一种基于云端算力与轻量化本地部署的高效替代路径……

    2026年3月7日
    20700
  • 快云cdn测试效果如何?cdn加速服务哪家强

    快云CDN测试的核心结论是:对于中小规模站点及国内基础加速需求,其性价比高且配置简单,但在高并发场景下的稳定性略逊于头部大厂,建议根据实际业务量级进行灰度对比测试后再做决定,在2026年的互联网环境下,内容分发网络(CDN)已不再是大型企业的专属奢侈品,而是中小型网站、博客乃至个人开发者提升用户体验的标配工具……

    2026年6月2日
    19300
  • 服务器托管需要什么样的配置,有哪些注意事项?

    服务器托管不是把机器扔机房就完事,配置和机房选择直接决定业务稳定性和长期成本,很多团队在初次托管时,容易陷入“配置越高越好”的误区,或者只盯着价格而忽略网络质量和机房环境,本文从实际选型出发,帮你用最少成本选到最合适的方案,服务器托管和云服务器哪个好这是大多数企业面临的第一个问题,两者各有适用场景,没有绝对好坏……

    2026年7月30日
    800
  • 西高地泡沫大模型最新版有哪些功能,西高地泡沫大模型怎么用

    在当前人工智能技术飞速迭代的背景下,西高地泡沫大模型_最新版的发布标志着垂直领域大模型从“通用对话”向“深度决策”的关键跨越,该模型的核心优势在于彻底解决了传统模型在处理复杂逻辑推理时的“幻觉”问题,通过引入独创的“泡沫验证机制”,实现了输出结果的高准确性与可解释性,为企业级用户提供了真正可落地的智能化解决方案……

    2026年3月23日
    11600
  • 国内数据中台最低价多少钱?数据中台建设方案文档介绍

    国内主流数据中台解决方案的公开最低入门价格通常在人民币 6.98 万元/年起,此价格通常针对特定云环境(如阿里云、腾讯云基础资源)、限定数据源接入数量(如≤5个)、核心基础功能模块(主数据管理、基础数据仓库、简易可视化)及基础服务支持(工作日5×8小时)的标准化SaaS化套餐,需注意,此“地板价”存在严格前置条……

    2026年2月8日
    16100
  • 大模型数据训练优化值得关注吗?数据优化能提升模型性能吗?

    大模型数据训练优化不仅值得关注,更是决定人工智能应用落地成败的关键分水岭,在算力红利逐渐见顶的当下,数据质量已成为模型性能提升的唯一杠杆,忽视数据训练优化,等同于在沙堆上建高楼,无论算法多么先进,最终输出结果都将面临崩塌风险, 核心结论非常明确:从“以模型为中心”转向“以数据为中心”,是降低训练成本、提升模型泛……

    2026年3月13日
    12200

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注