程序编程
-
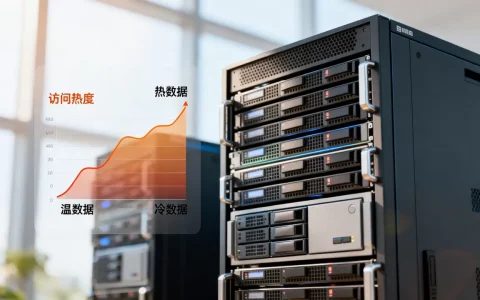
金融数据分级存储如何匹配访问热度,有什么方法?
金融数据分级存储的核心不是技术选型,而是让每一份数据的存储位置与它的访问热度精确匹配:热数据留在高性能层,冷数据沉入低成本层,这套逻辑做到位,性能和成本才能同时站稳,金融数据分级存储方案怎么选?先看访问热度的三个层级存储层级不是拍脑袋定的,得盯着访问热度走,金融数据里,真正高频访问的只有一小部分,业内专家指出……
-
跨机房时钟偏差会怎样扰动交易排序结果,原因是什么?
跨机房时钟偏差会直接扭曲交易的全局时间序,导致同一笔订单在不同节点上获得截然不同的排序身份,进而引发撮合结果错乱、对账失败和责任难以界定,它会将“谁先到达”这个原本清晰的问题,变成一个依赖本地手表时间的模糊判断,下面我们把这个隐蔽的技术痛点拆开揉碎,看看它到底怎么“捣乱”,以及如何应对,核心矛盾:本地时间戳到底……
-
撮合系统订单薄重建算力峰值如何预估,有哪些方法?
用户搜索“撮合系统订单簿重建算力峰值预估方法”时,真正想问的是:我的系统在重启、故障恢复或热切流量的瞬间,需要准备多少计算资源才不被打垮,答案很直接:算力峰值由“订单重放速度”和“状态重建复杂度”共同决定,预估的核心方法是把物理资源换算成撮合逻辑的原子操作次数,再用三倍安全余量压测确认,撮合系统订单簿重建性能瓶……
-
行情推送端到端延迟由哪些环节构成,怎么优化?
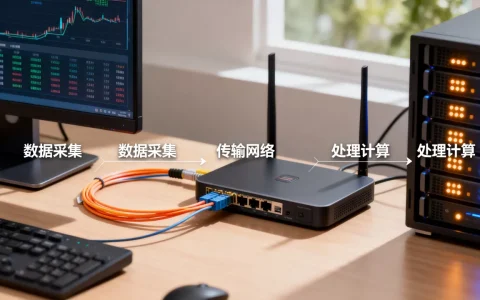
行情推送端到端延迟是交易链路中每一段“搬运工”耗时的总和,延迟构成主要集中在交易所撮合、行情网关、网络传输、客户端解码与终端渲染这五个核心环节,很多交易者遇到卡顿,第一反应是抱怨网络,但实际上,多数延迟并不发生在网络线路上,而是藏在券商或第三方行情服务的内部处理逻辑里,行情推送延迟构成:从交易所撮合到终端K线的……
-
量化交易终端就近接入要关注网络跳数吗,如何降低网络延迟?
网络跳数是决定延迟的关键变量,跳数越少、链路越直,延迟越低;就近接入的核心就是压缩物理距离和路由层级,让数据包少绕路,对于跑策略、抢价格的量化玩家来说,跳数不是技术名词,是实实在在的成本和收益,量化交易为什么死磕网络跳数很多刚接触量化交易的朋友,第一反应是“我的策略够不够好”“服务器CPU够不够快”,但当你真正……
-
如何平衡交易系统归档与查询性能?,数据归档对查询速度影响
交易系统数据归档与在线查询的性能平衡,本质是一场数据生命周期管理的精细运营——把热数据留在在线库,把冷数据归档到廉价存储,通过统一查询层让两端数据对用户无感,既保住在线查询的毫秒级响应,又不让历史数据撑爆在线库,这个结论说起来简单,做起来涉及到归档策略、分库分表逻辑、查询路由设计、底层存储选型等多个环节,任何一……
-
金融等保中数据备份基础认知是什么,怎么做?
本地备份、异地备份、定期恢复验证三者缺一不可,且备份系统本身也要纳入等保测评范围, 这项要求横跨技术、制度、人员三个层面,不是买台备份软件就能交差的事,金融等保数据备份要求到底包含哪些内容金融行业等保测评依据的是《信息安全技术 网络安全等级保护基本要求》(GB/T 22239-2019),其中对数据备份的要求集……
-
高频交易对报文时间戳精度有什么要求,如何选择合适的时间戳精度?
高频交易的报文时间戳精度,不是越准越好,而是必须和你的交易距离、策略类型、硬件成本做严格匹配,对大多数参与高频交易的团队来说,硬件时间戳是入场券,纳秒级是追求,微秒级是底线,高频交易时间戳纳秒还是微秒:精度多大才够用在讨论这个核心问题前,先看清楚一个现实:交易所撮合引擎给你的回报时间戳,和你自己系统里记录的订单……
-
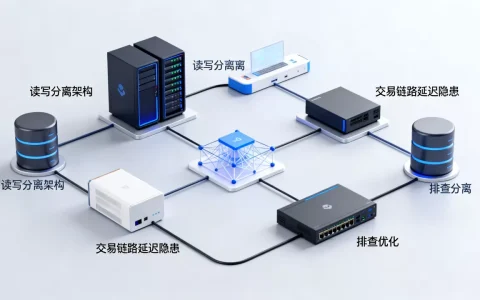
读写分离架构会给交易链路带来哪些延迟隐患,如何排查优化?
读写分离架构在提升交易系统吞吐量的同时,主从复制延迟会在高并发峰值期给交易链路埋下数据不一致的隐患,导致订单状态查询异常、库存超卖感知滞后,这不是理论推演,而是线上故障的高发区,读写分离延迟在交易链路中藏着哪些坑读写分离的核心逻辑是将写操作压在主库,把读操作分散到从库,这个设计在统计报表、内容列表等场景非常完美……
-
把行情解码算力沉到边缘能换来多少时延红利?,边缘计算是什么?
行情解码算力下沉到边缘节点,换来的直接红利是省掉了从客户端到云端再到行情源这段物理链路的往返时间,多数场景下时延可以从几十毫秒压到个位数,这个结论背后不是新算法,而是数据走的物理路径变短了,行情的实时性从来都是“寸毫秒必争”,今天商业行情源和免费源差距越来越大,交易所直连费用又不是每个团队都扛得住,边缘解码就成……