AI展现优化
-
内存告警为何不能只看占用率?,交换区占用高怎么解决
内存告警别只盯着占用率,交换区(swap)的使用情况才是那个最会“隐瞒真相”的变量, 当服务器内存亮起红灯,相当一部分运维同行第一反应是看 free -h 里的used列,但往往真正拖垮性能的,是那个静悄悄增长的swap分区,内存占用率不高,系统却卡成PPT?问题多半出在交换区业内专家指出,内存告警的排查逻辑应……
-
CPU使用率告警阈值多少合适,业务系统如何设置?
CPU使用率告警阈值不能一刀切,核心原则是按业务重要性和响应成本分层设定:核心交易链路建议15%-20%触发预警、40%-50%触发告警,非核心业务可放宽至70%-80%,这是业内专家普遍认可的分层策略,既保证核心业务有充足缓冲,又避免非核心系统告警轰炸,为什么不能照搬“默认80%”?先看业务的三六九等很多运维……
-
磁盘空间监控为何要设多级阈值,阈值怎么设置?
磁盘空间监控提前设多级阈值,不是为了多收几条报警,而是为了把“磁盘已满”这个必然发生的故障,从深夜紧急抢修变成白天从容处理,单靠一个固定阈值,本质上是在赌运气,而多级阈值是一张倒计时表,本文将从故障场景、阈值设计、操作步骤、工具对比等维度,拆解为什么分级监控是2026年服务器运维的底线操作,为什么单一阈值经常兜……
-
业务层监控为何非要和主机监控分开看,有何区别?
主机监控回答”机器还扛不扛得住”,业务监控回答”用户还能不能用”,把两者混在一起看,故障发生时你会被几十条告警同时轰炸,却分不清哪个才是真正要处理的,核心结论:业务层监控必须独立于主机监控单独看,因为两者处理的对象、告警的语义、响应的紧急程度完全不在一个维度上,很多团队最开始做监控,手段很朴素:盯CPU、看内存……
-
为什么带宽跑满才发现监控要覆盖流量曲线,怎么办?
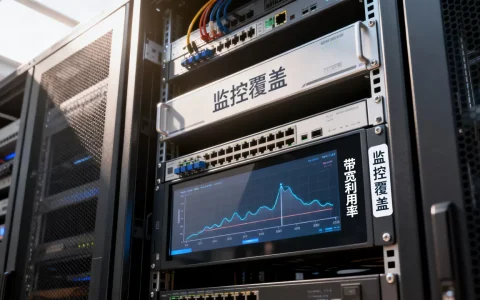
带宽跑满才发现监控不覆盖流量曲线,监控就是聋子的耳朵——要提前看趋势、卡时间点、追溯来源,关键是让监控把流量走势一条不落画出来,带宽监控为什么必须覆盖流量曲线:速度测完一样卡很多人以为带宽监控就是盯着实时速率,数字一飙就扩容,数字一落就归零,干过运维的都懂,带宽跑满的前十分钟往往没有任何告警信号,因为即时速度只……
-
磁盘IO延迟升高该设置哪些告警指标,怎么解决?
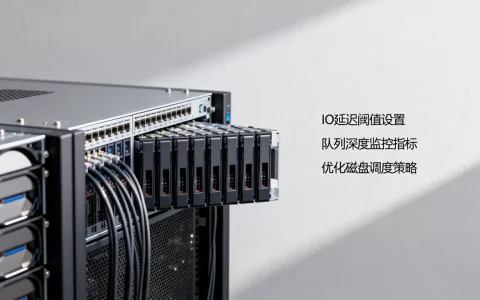
磁盘IO延迟升高时,核心告警指标应聚焦在读延迟、写延迟、IOPS、队列长度和磁盘使用率这五类关键数据上,其中读延迟和写延迟是判断问题最直接的信号,延迟升高不会凭空出现,它背后要么是磁盘硬件在老化,要么是业务流量在暴涨,要么是系统配置出了问题,如果不提前设置告警,等到业务侧反馈“卡死了”“超时了”,那时候往往已经……
-
监控探针究竟该布置在哪些关键节点,有哪些注意事项?
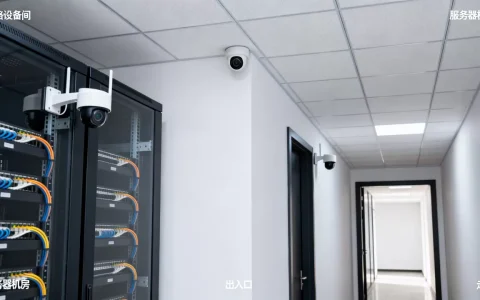
监控探针应该优先布置在哪几个位置?监控探针的核心布置原则是“先外围、后内部,先通道、后房间”,具体到关键节点,依次是出入口、周界、通道交叉口、财物存放区以及机房配电间, 这五个位置覆盖了入侵路径、行为轨迹和核心资产,按照这个优先级布置,能有效避免监控盲区,也为后续扩展留出余地,出入口与周界:为什么说这是监控探针……
-
给入门团队的一页式监控指标速查表怎么用,监控指标有哪些?
给入门团队的一页式监控指标速查表,核心是把指标从“能看”变成“能判断”,先圈定范围,再定阈值,最后绑到人,很多新团队的第一步不是缺工具,而是被工具淹没,Grafana 里几百个图表,Prometheus 配了一堆 exporter,真到告警的时候,群里除了“某某服务挂了”之外什么都说不清,问题不在工具,在于没有……
-
业务高峰时监控阈值怎么调整,有哪些实用经验?
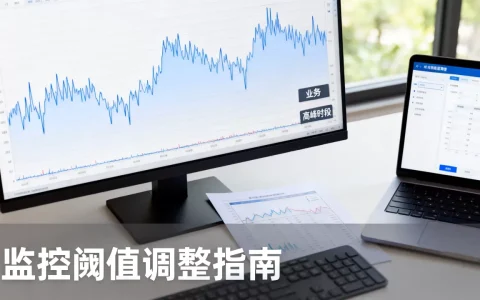
按业务高峰调整监控阈值的正确做法,不是把固定值调大,而是用历史分位数做基线、按时段切分告警策略、持续校准,做运维这几年来,我见过太多团队在业务高峰期被监控告警折腾得够呛,凌晨两三点被电话叫醒,接通后那头是值班同事焦急的声音——“CPU又飙了,报警刷屏了,但系统其实没挂”,这种场景太熟悉了,核心问题不在监控工具……
-
告警通知发给谁的值班机制怎么搭
告警通知发给谁,核心答案是把告警发给当前正在值班且能立即处理问题的人,而不是发给所有人,很多人搭建值班机制时,第一步就在“通知谁”上栽跟头:要么全员轰炸,要么发给一个长期不看的静态群,真正合理的机制,是用“值班表+路由规则+升级策略”三层结构,让每一条告警都能精准找到当班负责人,值班机制的核心:先定义“谁该收到……