服务器测评
-
Hadoop大数据基本原理是什么?大数据技术原理详解
Hadoop 是大数据领域的基石,其核心设计理念可以概括为:“将计算向数据移动,而不是将数据向计算移动”,以及“利用廉价硬件集群实现高容错性的大规模数据处理”,以下是 Hadoop 大数据基本原理的详细解析,主要围绕其两大核心组件:HDFS(分布式文件系统)和 MapReduce(分布式计算框架),并简要提及生……
-
H5网站真的不利于SEO优化吗?H5网站百度收录慢怎么办
这是一个在SEO(搜索引擎优化)领域非常经典且常被误解的问题,简单直接的结论是:H5网站本身并不“不利于”优化,甚至在很多场景下比传统的PC站或原生App更具优势,如果H5网站的技术实现或内容策略不当,确实会导致优化效果不佳,为了让你更全面地理解,我们需要从优势、潜在风险、以及关键优化点三个维度来详细分析: 为……
-
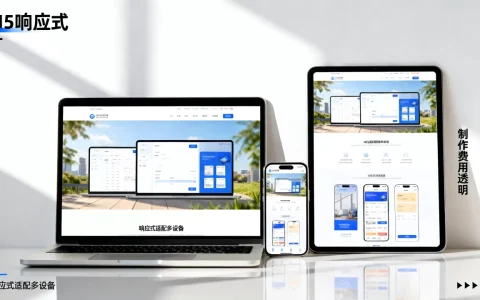
H5响应式网站怎么做?H5响应式网站开发费用
2026年做企业官网,必须优先选择H5响应式设计,因为它能一次性解决手机、平板和电脑端的适配问题,大幅降低维护成本并提升搜索引擎排名,在移动互联网深度渗透的今天,用户指尖滑动的习惯已经彻底改变了信息获取的方式,如果你的网站还在用传统的PC端布局,或者专门为手机端开发一个独立的APP,那不仅浪费了宝贵的流量入口……
-
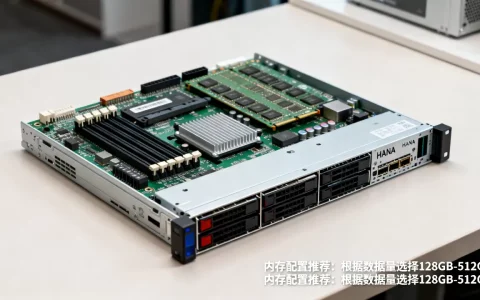
hana服务器内存配置多少合适?hana服务器内存配置推荐
HANA服务器内存配置的核心原则是“内存即数据库”,必须确保所有热数据 reside 在内存中,通常建议物理内存容量至少为预期热数据量的1.5至2倍,并优先选择高频低延迟的DDR4/DDR5 ECC Registered内存条,很多人误以为给数据库服务器加内存就是简单的“堆料”,但实际上SAP HANA的架构逻……
-
Hadoop数据仓库营销服务怎么做?企业搭建Hadoop数据仓库方案
Hadoop数据仓库营销服务的核心价值在于通过底层海量数据的清洗与整合,构建精准的用户画像,从而将传统的粗放式广告投放转化为基于实时行为分析的个性化营销,显著提升转化率并降低获客成本,在数字化转型的深水区,企业面临的痛点不再是“有没有数据”,而是“数据乱、数据杂、用不上”,传统的营销手段依赖经验判断,而基于Ha……
-
H5响应式网站有哪些优势?H5响应式网站制作费用多少
H5响应式网站的核心优势在于“一套代码适配所有终端”,能以最低的开发维护成本实现多设备无缝体验,是当前企业数字化转型的高性价比选择,为什么H5响应式成为移动端流量入口的首选方案移动互联网早已渗透进生活的每个角落,用户浏览网页的习惯从桌面端彻底转向了手持设备,对于企业而言,如果还在坚持为手机、平板和电脑分别开发独……
-
hdfs进程服务器是什么?hdfs进程服务器启动失败怎么办
HDFS进程服务器并非单一软件,而是由NameNode、DataNode及SecondaryNameNode等守护进程协同组成的分布式文件系统核心架构,其稳定性直接决定了企业级大数据存储的可靠性,当我们谈论HDFS(Hadoop Distributed File System)时,很多人容易将其误解为一个简单的……
-
H3C郑州大数据培训真的靠谱吗?郑州大数据培训机构哪家好
H3C郑州大数据解决方案通过“云网端”一体化架构,帮助企业在2026年以更低成本实现数据资产化,核心优势在于其成熟的国产化适配能力与极致的运维稳定性,在数字化转型进入深水区的当下,郑州及周边企业面临的不再是“要不要上云”的问题,而是“如何选对云”的难题,H3C作为老牌IT基础设施巨头,其在河南市场的深耕并非偶然……
-
HBASE数据库试用促销是真的吗?HBASE数据库试用促销
HBASE数据库试用促销的核心价值在于以极低的初始成本验证其在大容量、高并发场景下的性能优势,建议优先通过官方云服务商的免费试用额度进行小规模集群部署测试,在2026年的数据架构选型中,企业面对PB级数据增长,传统关系型数据库往往显得力不从心,HBase作为分布式列式存储数据库,凭借其线性扩展能力和低延迟读写特……
-
Hadoop数据倾斜怎么解决?hadoop数据倾斜优化方案
Hadoop数据倾斜的核心解决方案在于通过调整MapReduce或Spark的 Shuffle 机制,结合加盐随机前缀、两阶段聚合或自定义分区器,将热点数据均匀分散到不同节点,从而避免单个Task处理数据量过大导致的任务卡顿或OOM,在大数据处理领域,数据倾斜就像是一个繁忙餐厅里,所有顾客都涌向同一个收银台结账……