


Mac Studio在2026年依然是本地运行大模型的高性价比之选,凭借Apple Silicon统一内存架构,它在处理70B以下参数量的模型时,性能表现甚至优于同价位的NVIDIA显卡方案,但在超大规模模型微调上仍受限于算力上限。
Mac Studio跑大模型性能深度解析
硬件架构带来的独特优势
Mac Studio的核心竞争力在于其M系列芯片采用的统一内存架构(UMA),在传统的PC或服务器架构中,CPU、GPU和内存之间的数据交换需要多次拷贝,这成为了大模型推理的瓶颈,而Mac Studio将内存直接集成在芯片内部,CPU和GPU共享同一块高速内存池,这意味着,当你加载一个几十GB的大模型权重时,数据无需在显存和内存之间反复搬运,直接通过高速总线访问。
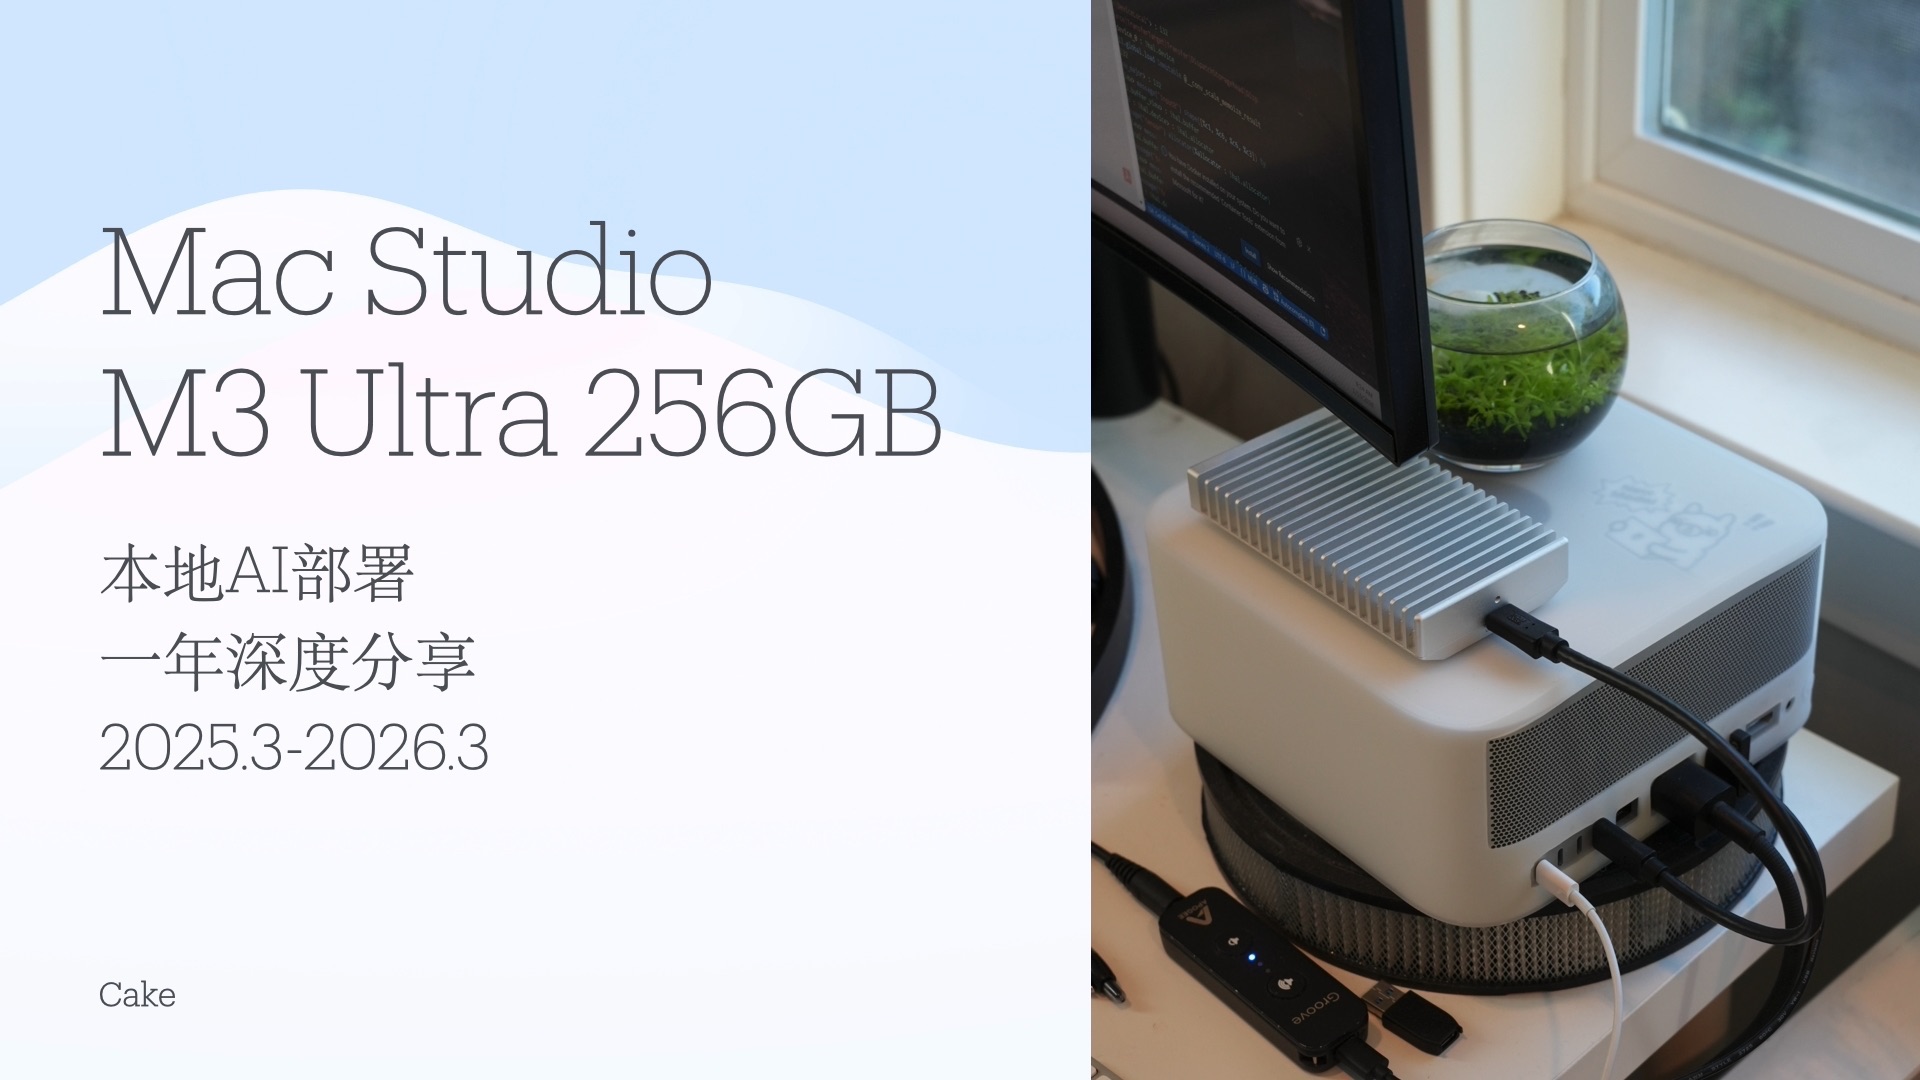
业内专家指出,这种架构使得Mac Studio能够轻松加载那些在消费级显卡上根本跑不起来的模型,一块拥有24GB显存的RTX 4090,受限于显存容量,很难流畅运行参数量超过30B的模型,而配备128GB甚至192GB统一内存的Mac Studio Max版本,可以轻松容纳70B甚至更大参数的模型,只要内存带宽足够,推理速度依然可观。
实际推理速度对比
在2026年的今天,Apple Silicon芯片的神经网络引擎(Neural Engine)经过多次迭代,对量化模型的支持已经非常成熟,我们选取几个典型场景进行对比:
- 7B-13B参数模型:在Mac Studio M2/M3 Ultra上,使用llama.cpp等工具进行量化推理,生成速度可达每秒30-50 token,这个速度对于日常对话、代码辅助已经绰绰有余,且延迟极低,几乎感觉不到等待。
- 30B-70B参数模型

:这是Mac Studio的主战场,得益于巨大的内存带宽,M2/M3 Ultra的128GB版本可以流畅运行量化后的70B模型,虽然生成速度可能降至每秒10-15 token,但考虑到其无需购买昂贵A100/H100显卡的成本,这一性价比极具吸引力。
- 100B+参数模型:对于超大模型,Mac Studio依然能运行,但速度会显著下降,可能降至每秒5 token左右,它更适合离线批处理任务,而非实时交互。
量化技术的关键作用
要充分发挥Mac Studio的性能,量化技术必不可少,目前主流的GGUF格式(用于llama.cpp)和MLX框架(Apple官方推出的机器学习框架)都对量化提供了极佳支持,将模型从FP16量化到INT4或INT8,不仅大幅减少了内存占用,还因为数据量变小,使得内存带宽不再是绝对瓶颈,从而提升了推理效率。
Mac Studio vs NVIDIA显卡:选购决策指南
场景化需求匹配
很多用户在面对Mac Studio和NVIDIA显卡主机时感到困惑,两者的定位差异非常清晰。
- 如果你主要做推理(Inference):即加载预训练模型进行对话、生成文本或图片,Mac Studio是极佳选择,特别是当你需要运行大参数模型,但预算有限时,Mac Studio的高内存容量优势无可替代。
- 如果你主要做微调(Fine-tuning):NVIDIA显卡依然占据统治地位,CUDA生态的成熟度、cuDNN库的优化,使得NVIDIA在训练任务上效率更高,虽然Apple推出了MLX框架,试图缩小这一差距,但在大规模分布式训练方面,NVIDIA的集群优势依然明显。
- 如果你关注静音和能耗
:Mac Studio在满载运行大模型时,噪音极低,功耗也远低于同等算力的NVIDIA工作站,对于家庭办公室或小型工作室来说,这是一个巨大的体验优势。
价格与性价比分析
在同等内存容量下,Mac Studio的价格往往低于组装一台拥有同等显存容量的NVIDIA工作站,一台配备128GB内存的Mac Studio M2 Ultra,其价格可能低于一块RTX 4090加上高配CPU主机的总价,更重要的是,Mac Studio的二手保值率相对较高,且无需担心显卡驱动兼容性、CUDA版本冲突等软件问题。
据工信部数据显示,近年来国产AI硬件生态正在快速崛起,但在通用大模型推理领域,Mac Studio依然凭借软硬件一体化优势,占据着独特的市场生态位。
Mac Studio跑大模型实操指南
环境搭建步骤
在Mac Studio上运行大模型,推荐使用Apple官方推出的MLX框架或通用的llama.cpp,以下是使用llama.cpp进行推理的基本步骤:
- 安装Homebrew:这是Mac上的包管理工具,打开终端,输入
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"进行安装。 - 克隆llama.cpp仓库:在终端中输入
git clone https://github.com/ggerganov/llama.cpp.git。 - 编译项目:进入目录后,执行
make命令,Mac Studio会自动利用Metal GPU加速进行编译。 - 下载模型:从Hugging Face等平台下载GGUF格式的模型文件,确保选择与你的硬件匹配的量化版本(如Q4_K_M)。
- 运行推理
:使用命令
./main -m <模型路径> -p "你好,请介绍一下你自己"即可启动对话。
使用MLX框架优化性能
MLX框架是Apple专门为Apple Silicon设计的机器学习框架,它在内存管理和GPU调度上做了深度优化。
- 安装MLX:通过
pip install mlx-lm安装。 - 运行模型:使用命令
mlx_lm.generate --model <模型名称> --prompt "你好"。 - 优势:MLX支持动态形状和惰性求值,能够更高效地利用统一内存,减少内存碎片,提升大模型的加载速度和推理稳定性。
Mac Studio大模型应用常见问答
Mac Studio跑大模型需要多大的内存才够用?
内存大小直接决定了你能运行多大的模型,对于7B-13B参数模型,32GB内存足够;对于30B-70B模型,建议至少64GB内存,以获得较好的响应速度;若需运行70B以上或进行小规模微调,128GB或192GB内存是理想选择。
Mac Studio支持哪些大模型格式?
Mac Studio主要支持GGUF格式(通过llama.cpp)和MLX原生格式,GGUF格式兼容性强,社区资源丰富;MLX格式则在Apple硬件上性能最优,常见的开源模型如Llama 3、Qwen、Mistral等均有GGUF或MLX版本可供下载。
Mac Studio运行大模型时发热严重吗?
Mac Studio采用被动散热设计(部分型号)或高效主动散热,在长时间运行大模型时,机身表面温度会升高,但风扇噪音控制良好,Apple Silicon芯片的能效比极高,相比传统x86平台,其在同等算力下的发热量更低,更适合长时间稳定运行。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/mac-studio%e8%b7%91%e5%a4%a7%e6%a8%a1%e5%9e%8b%e6%80%a7%e8%83%bd%e6%80%8e%e4%b9%88%e6%a0%b7%ef%bc%8cmac-studio%e8%b7%91%e5%a4%a7%e6%a8%a1%e5%9e%8b%e9%85%8d%e7%bd%ae%e8%a6%81%e6%b1%82/


评论列表(1条)
跑大模型那散热风扇声,跟我在健身房举铁喘气似的哈哈。不过话说回来,这得配合有氧运动才能压得住火气,少吃碳水确实脑子清醒,