MapReduce是Hadoop生态中的核心计算框架,其基本原理是“分而治之”:将大规模数据集拆分为多个小任务并行处理,最终合并结果,理解MapReduce的工作机制是掌握大数据处理技术的关键一步。参考2
MapReduce工作原理详解
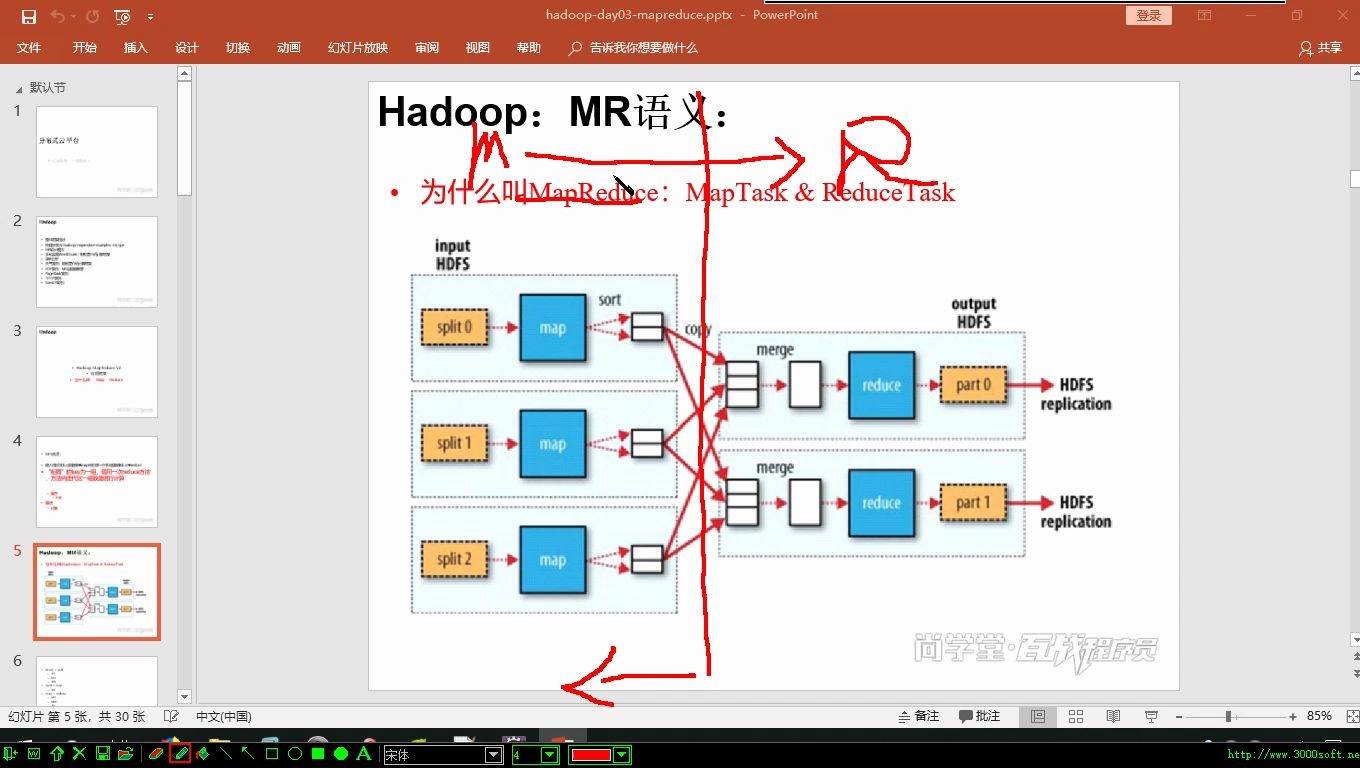
MapReduce的设计灵感源自函数式编程,核心思想是“先分后合”,整个计算过程分为两个主要阶段:Map(映射)和Reduce(归约),中间由Shuffle连接,下面拆解每个环节的细节。

分而治之的设计思想
当数据量达到TB甚至PB级别时,单机无法处理,MapReduce将输入数据切分成若干独立的数据块,每个块由一个Map任务处理,这些Map任务完全并行运行,互不干扰,完成后,系统将Map输出的中间结果按照相同的Key进行分组,再交给Reduce任务合并输出,这种“分而治之”让计算能力可以随集群规模线性扩展。
Map阶段:数据拆分与映射
- 输入分片:Hadoop根据输入格式(如TextInputFormat)将文件按行或按块切分成InputSplit,每个Split对应一个Map任务。
- 映射逻辑:开发者自定义map函数,接收<Key, Value>对,处理后输出新的<Key, Value>对,例如WordCount的map负责将每行文本拆成单词,输出<单词, 1>。
- 执行环境:Map任务运行在数据所在节点(数据本地化),减少网络开销。
Shuffle阶段:数据排序与分组
Shuffle是MapReduce最核心也最复杂的部分,它发生在Map输出之后、Reduce输入之前。
- 分区:Map输出的<Key, Value>根据Reduce数量(默认一个)进行分区,分区号由Partitioner决定,默认按Key的哈希值取模。
- 排序:每个分区内的数据按键排序,排序后写入本地磁盘(可能涉及溢写和合并)。
- 拉取:Reduce任务从各个Map任务所在节点拉取属于自己的分区数据,再次进行归并排序,形成按Key有序的输入流。
Reduce阶段:聚合与输出

- 归并:Reduce任务从Shuffle中获取到有序的<Key, Value列表>,对每个Key调用reduce函数进行聚合计算。
- 输出:reduce结果直接写入HDFS或其他存储系统,每个Reduce任务生成一个独立的输出文件。
上述流程完整展示了MapReduce的数据流转路径,业内专家指出,理解Shuffle细节是优化性能的关键,因为它占据了作业运行时间的相当一部分。
Hadoop MapReduce入门教程:从零开始
对于刚接触Hadoop的开发者,最直接的方式是通过一个经典案例WordCount,走通整个流程,下面给出具体步骤。
环境准备:Hadoop集群搭建要点
- 至少准备三台机器(或虚拟机),安装Java 8以上版本。
- 配置SSH免密登录,确保NameNode和DataNode之间通信正常。
- 解压Hadoop安装包,修改core-site.xml、hdfs-site.xml、mapred-site.xml、yarn-site.xml等配置文件。
- 启动HDFS和YARN进程,使用
jps命令确认NameNode、DataNode、ResourceManager、NodeManager等进程都已运行。
编写第一个MapReduce程序:WordCount
- Map类:继承Mapper类,覆写map方法。
public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable> { private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } - Reduce类:继承Reducer类,覆写reduce方法。
public static class IntSumReducer extends Reducer<Text, IntWritable, Text, IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } 参考2
- 主类:设置Job配置,包括输入输出路径、Mapper和Reducer类、输出格式等。
- 打包:使用Maven或Ant将项目打包成jar,上传到集群。

运行与调试:常见错误解决
- ClassNotFoundException:确保jar中包含了所有依赖的类,或者使用
-libjars参数。 - 内存不足:调整
mapreduce.map.memory.mb和mapreduce.reduce.memory.mb参数。 - 数据倾斜:观察到部分Reduce任务运行时间远长于其他,可考虑自定义Partitioner或使用Combiner预聚合。
MapReduce与Spark对比分析
随着Spark的兴起,多数开发者常面临选型困惑,下表直观对比两者核心差异:
| 对比维度 | MapReduce | Spark |
|---|---|---|
| 计算模型 | 数据必须经过Map→Shuffle→Reduce | 支持DAG有向无环图,多种算子组合 |
| 中间结果存储 | 写入磁盘,IO开销大 | 优先使用内存,效率高 |
| 延迟 | 分钟级起步 | 秒级至分钟级 |
| 编程接口 | 仅Map和Reduce,逻辑受限 | 丰富算子,易于表达复杂业务 |
| 适用场景 | 超大规模离线批处理,对稳定性要求高 | 迭代计算、实时流处理、交互式查询 |
计算模型差异
MapReduce的流水线是固定的,每个作业必须经过Shuffle,导致多次磁盘读写,Spark则通过构建DAG,将多个操作串联,尽可能在内存中完成计算,只有在必要时才落盘。
性能与适用场景
行业共识认为,对于50GB以下的作业,两者的性能差距不明显;但当数据量达到TB级别且迭代次数多(如机器学习算法),Spark的优势可达数倍,不过MapReduce在资源管控和稳定性上经过多年验证,很多银行、电信等对数据可靠性要求极高的场景仍在使用。

MapReduce实战项目案例
只看原理和教程不足以掌握,需要结合真实场景,这里列举两个常见需求。
日志分析:统计PV/UV
- 需求:统计网站每天每个页面的访问次数(PV)和独立访客数(UV)。
- 实现思路:Map输出<页面URL, 用户ID>,Reduce对相同URL的用户ID去重并计数(UV),同时累加所有记录(PV),注意UV去重可以使用Set或借助HashSet在内存中维护,但页面量极大时需考虑分布式去重方案。
数据清洗:ETL处理
- 需求:从原始日志中筛选出符合规则的记录,丢弃脏数据,然后输出到结构化存储。
- 实现思路:Map阶段对每条记录编写校验逻辑,不符合规则的直接丢弃(不输出),符合规则的输出清洗后的字段,可以设置Reduce任务数为0,仅用Map完成ETL,避免Shuffle开销。
MapReduce学习常见问题解答
Q1: MapReduce处理数据量多大合适?
MapReduce是为海量数据设计的,通常建议在TB级别以上使用,如果数据量只有几十GB,使用单机处理或Spark可能更高效,但具体还要看集群资源配置,节点越多,MapReduce能处理的数据量就越大。参考2
Q2: 如何优化MapReduce作业?
主要有几个方向:调整InputSplit大小使其与HDFS块对齐(默认128MB);使用Combiner在Map端预聚合,减少网络传输;对中间结果进行压缩,降低IO压力;增大Reduce并行度,避免单个Reduce负载过重。
Q3: MapReduce适合实时计算吗?
不适合,MapReduce的启动和Shuffle过程有较高延迟,作业执行时间通常以分钟为单位,实时计算场景应选用Storm、Flink或Spark Streaming等流处理框架,MapReduce的定位是稳定的离线批处理。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/mapreduce%e5%8e%9f%e7%90%86%e6%98%af%e4%bb%80%e4%b9%88%ef%bc%8chadoop%e5%a6%82%e4%bd%95%e5%a4%84%e7%90%86%e6%b5%b7%e9%87%8f%e6%95%b0%e6%8d%ae%ef%bc%9f/