后端某节点异常时,健康检查自动把它摘掉是保障服务整体可用性的核心机制,核心逻辑就是通过定期探测节点状态,一旦发现异常立即将其从负载均衡池中移除。这套机制如果配置得当,能在大流量冲击或代码故障时保住整个集群的命,下面从原理、方案选型到实战配置,把这件事讲透。
健康检查自动摘除节点的基本原理
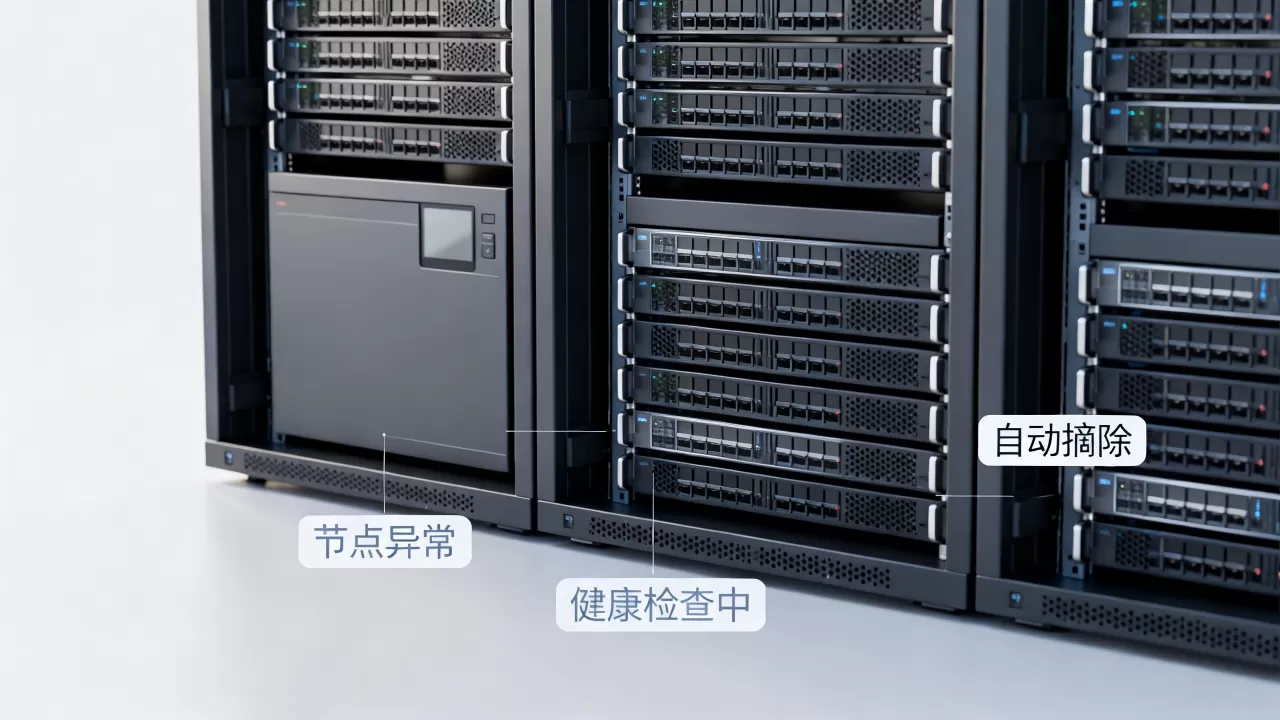
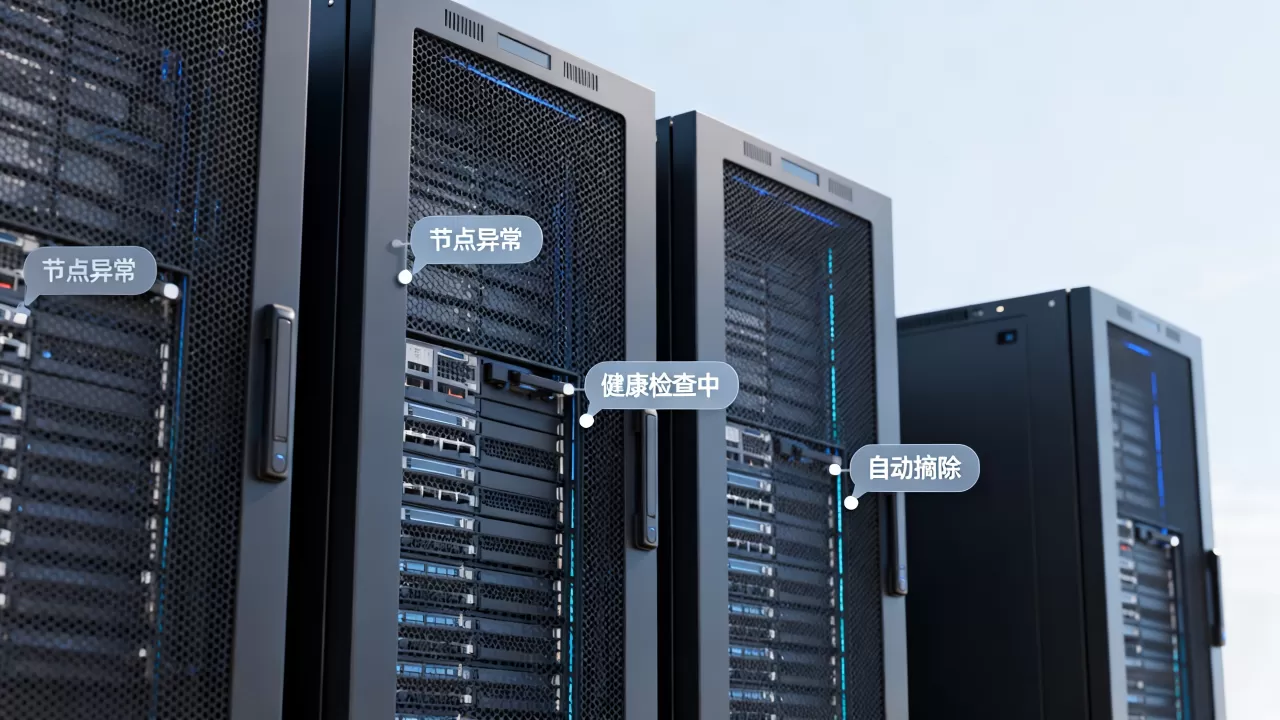
后端节点从“正常服务”到“被摘除”,中间经历的是一个标准的状态机流转,负责流量分发的组件(比如Nginx、LVS、Kubernetes)会按照预设的间隔,向后端节点发送探测请求,探测方式通常有三种:
- TCP端口探测:只检查端口能否建立连接,成本最低,但无法发现应用层故障。
- HTTP/HTTPS探测:发送指定路径的请求,根据状态码判断应用是否存活,最常用。
- 自定义脚本探测:在节点上执行脚本,检查更复杂的业务逻辑,适用于特殊场景。
当探测连续失败的次数达到阈值时,系统就会在内存中把该节点标记为down,并将其从可用的服务器列表中剔除,此时新进来的请求不会转发到这个故障节点,直到它再次通过探测被自动加回。
这里有一个关键概念需要理解:摘除节点不是为了惩罚它,而是为了保护整体系统,如果不摘掉,错误请求占满线程池后,故障会快速传染给其他节点,导致雪崩。
主流方案对比:选对工具才能不踩坑
不同架构环境下,实现自动摘除的手段完全不同,先看一张横向对比表,再逐一拆解典型场景。
| 方案 | 适用场景 | 探测粒度 | 摘除速度 | 运维成本 |
|---|---|---|---|---|
| Nginx开源版被动探测 | 中小型Web集群 | 转发失败计数 | 约3-5秒 | 低 |
| Nginx Plus主动探测 | 企业级生产环境 | 应用层HTTP/HTTPS | 毫秒级 | 较高(商业版) |
| Keepalived+LVS脚本 | 四层负载均衡场景 | 自定义Shell脚本 | 脚本执行周期 | 中 |
| Kubernetes探针 | 云原生容器环境 | 容器内进程/HTTP/TCP | 约10-30秒 | 低 |
| Consul+Haproxy联动 | 微服务注册发现 | 脚本或HTTP检查 | 秒级,依赖TTL | 高 |
Nginx场景:使用健康检查把故障节点自动摘掉
开源版Nginx不带主动健康检查模块,但通过upstream里的max_fails和fail_timeout参数,同样能实现“探测失败后自动摘除”的效果,这是一个常见的nginx健康检查配置示例:
upstream backend_pool {
    server 192.168.1.11:8080 max_fails=2 fail_timeout=10s;
    server 192.168.1.12:8080 max_fails=2 fail_timeout=10s;
}
server {
    listen 80;
    location / {
        proxy_pass http://backend_pool;
        proxy_next_upstream http_502 http_503;
    }
}在这个配置里,每个后端节点在10秒内如果出现2次转发失败,Nginx会将其标记为不可用,并在接下来的10秒内不再向它转发任何请求,10秒后试探性恢复,如果再次失败则继续冷却。proxy_next_upstream参数很关键,它允许请求在遇到502或503时自动转发给下一个节点,用户几乎无感知。
生产环境推荐再加一层被动探测与主动探测结合的策略,如果预算允许,可以考虑商业版Nginx Plus的主动健康检查,它能主动探测应用层状态,比如检查/health接口返回的JSON内容,而不仅仅是看TCP连接状态。
Keepalived场景:后端节点异常时自动摘除的具体脚本
在四层负载均衡场景下(例如直接使用LVS转发流量),Keepalived通常需要配合脚本来实现节点摘除,keepalived健康检查脚本写法的通用模板如下:
- 编写探测脚本
/etc/keepalived/check_http.sh,核心逻辑是先检测端口连通性,再检查HTTP状态码。 - 如果探测失败,脚本返回非零值,Keepalived通知LVS将该后端节点的权重设为0,实现摘除效果。
- 恢复后脚本返回零值,节点自动重新加入转发池。
一个精简的脚本内容示例:
#!/bin/bash
if curl -s -o /dev/null -w "%{http_code}" http://127.0.0.1:8080/health | grep -q 200; then
    exit 0
else
    exit 1
fi
行业共识认为,脚本探测的频率不宜太高,5秒一次比较合理,过于频繁会增大节点压力,过低则摘除不够及时。
Kubernetes场景:探针实现自动隔离
云原生环境下,后端节点异常时健康检查自动把它摘掉是Kubernetes内置操作,主要依赖两种探针:
- 存活探针(LivenessProbe):检测容器是否假死,失败会直接重启容器。
- 就绪探针(ReadinessProbe):检测服务是否可接收流量,失败时自动将Pod从Service的Endpoints中摘除,但容器不会重启。
这套机制的价值在于它直接操作于Endpoints列表层面,流量调度器不再向异常的Pod发送请求,整个过程完全自动化。
一个常见的问题是:为什么Pod重启了但仍然偶尔报错?业内专家指出,很多情况下是存活探针写得太宽松,比如只探测TCP端口,而应用层已经无法正常处理请求,建议针对业务核心接口配置HTTP探针,
readinessProbe:
  httpGet:
    path: /health
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
periodSeconds决定了探测频率,从发现异常到摘除节点,大约需要3-5个周期,也就是15-25秒的延迟,这在容器场景下可以接受。
摘除节点后的流量调度策略设计
自动摘除虽然解决了“流量打给坏节点”的问题,但摘掉之后流量如何平滑转移,是很多人的盲区。
- 摘除节点后,存量长连接如何处理?Nginx与后端之间的连接池可能有未完成的请求,处理策略是设置优雅退出超时,比如Nginx中的
drain模式(商业版支持),或者Kubernetes的terminationGracePeriodSeconds。 - 摘除要区分主动摘除(维护、发布)和被动摘除(故障),被动摘除时,节点上可能还有正在处理的请求,建议配合
proxy_next_upstream_timeout控制转移等待时间,超过1秒直接转给下一个健康节点,避免用户长时间等待。 - 当同一个服务有多个节点被摘掉,剩下节点是否扛得住?可以在负载均衡器上配置最小连接数调度算法,配合熔断器(如Sentinel、Hystrix),防止剩余节点被打垮。
从业务角度看,摘除节点时,建议同时将监控系统里的告警触发,这部分的实现路径一般是:健康检查状态变化时,回调Webhook到监控平台,然后进行通知。
五个常见的配置误区与排查落地路径
配置不恰当,健康检查反而成为隐患,常见误区有五个:
- 探测间隔设置过小,导致节点CPU被打满,应用健康检查接口本身需要消耗资源,高频探测会引发性能问题。
- 只看TCP端口,不看业务状态,端口通不代表业务正常,建议至少探测一个轻量级API,例如返回当前请求耗时的接口。
- 没有设置恢复重试次数,节点恢复后立即加入流量,立刻又故障,引发反复抖动,应该设置连续成功3次后才重新上线。
- 摘除后没有通知机制,自动化摘除会掩盖故障,如果在半夜摘除一个节点,第二天才发现就失去了意义,建议接入企业微信或钉钉机器人,摘除动作主动推送。
- 后端节点之间配置不一致,不同节点上的服务版本不同,健康检查接口响应不一致,导致部分节点被误摘。
如果遇到“节点显示正常,但实际请求大量超时”的疑难问题,排查路径建议如下:
- 先看负载均衡器的被动健康检查计数(例如Nginx的
ngx_http_upstream_check_module状态页)。 - 手动curl后端节点的健康检查接口,观察响应时间。
- 检查系统层指标(CPU、IO等待),常见于磁盘IO或垃圾回收导致的停顿。
- 最后确认数据库连接池是否被打满,这种问题健康检查通常探测不到。
无固定解法,但有一个原则:健康检查要模拟真实流量,探测路径越接近用户实际请求路径,摘除的准确性越高。
常见问题与解答
后端节点一直处于“被摘除”状态,应该从哪些方面排查?
首先用命令行手动检查该节点的端口和HTTP接口,例如执行curl -I http://节点IP:端口/health,确认是否返回200状态码,如果返回正常,检查负载均衡器的探测间隔和失败阈值配置,是否最近被人调整过,还有相当一部分情况是防火墙规则拦截了负载均衡器IP对节点端口的访问,导致探测请求根本无法到达,最后查看节点系统负载,高负载时探测请求响应慢,触发了超时阈值。
健康检查与注册中心的摘除机制有什么区别?
健康检查是负载均衡器维度的流量控制,它决定“流量要不要发到这台机器”,注册中心(如Nacos、Consul、Eureka)的摘除是服务发现维度的控制,消费者从注册中心拿到的是健康的服务列表,两者会同时生效,但注册中心摘除通常依赖客户端心跳上报,默认时间较长(例如30秒到90秒),而负载均衡器层面的健康检查更实时,生产环境中两者需要并行配置,互相备份,避免单点判断失误,注册中心机制一般配合TTL过期实现,是分布式系统里最终一致性的典型应用,它的摘除不是即时生效,而是基于租约过期。
健康检查自动摘除节点后,如何保证该节点上的定时任务不重复执行?
这个问题常见于分布式定时任务场景,节点被摘除只是不再接收外部请求,但节点上的进程仍然存活,原本配了定时任务的框架依旧会触发执行,如果任务不支持分布式锁,就会产生重复执行的问题,这种情况下需要额外考虑将节点标记为离线状态,例如通过注册中心的元数据标识,或者使用XXL-Job这类框架自带的分片和故障转移功能,确保摘除节点时,同步去注册中心取消该节点的任务注册,避免同一任务被两个节点重复执行。
后端节点异常时健康检查自动把它摘掉,看似小机制,实际牵扯到流量调度、故障转移和系统稳定性的方方面面,无论你用的是Nginx、Keepalived还是Kubernetes,核心思路一致:快速发现异常,果断摘除流量,平滑恢复服务,建议从最小配置(比如Nginx的max_fails)入手,逐步叠加主动探测和告警通知,让系统具备基本的自愈能力,要为“所有节点同时被摘掉”这种极端情况留好预案,比如静态备份页或者多活容灾,健康检查只是故障处理的第一步,真正的高可用还需要完整的降级、限流和灰度发布机制共同发挥作用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/633696.html