大模型微调数据集污染的核心解法在于建立“清洗-去重-质量评估-动态监控”的全链路闭环,通过引入自动化清洗工具与人工抽检相结合的手段,从源头切断低质数据的注入路径,确保模型训练数据的纯净度与多样性。
在2026年的AI应用落地深水区,微调(Fine-tuning)已成为企业定制专属大模型的标准动作,许多团队在追求效果时,往往忽略了数据源头的“脏乱差”问题,一旦训练数据被污染,模型不仅无法提升性能,反而会出现逻辑混乱、幻觉频发甚至输出有害内容的严重后果,这不仅仅是技术问题,更是数据治理能力的体现。

如何识别微调数据集是否遭受污染
在着手解决之前,首要任务是确认污染的存在及其严重程度,业内专家指出,数据污染通常表现为数据分布偏差、噪声比例过高或存在版权合规风险。
常见污染场景与特征
数据污染并非单一现象,它可能以多种形式潜伏在训练集中,我们需要通过具体的场景来识别这些“隐形杀手”。
重复数据导致的过拟合
这是最直观的污染形式,当训练集中存在大量完全相同或高度相似的数据样本时,模型会机械地记忆这些内容,而非学习其背后的逻辑规律,在金融问答微调中,如果同一问题的标准答案出现了上千次,模型在面对新问题时,可能会强行套用旧答案,导致泛化能力极差。
噪声数据引发的逻辑断裂
噪声数据包括错别字、乱码、无关广告、HTML标签残留等,在自然语言处理任务中,这些噪声会干扰模型对语义的理解,据统计,相当一部分公开爬取的数据集中,噪声比例可能高达10%-20%,这足以显著降低模型的准确率。
版权与合规性风险
随着2026年数据合规法规的日益严格,使用未经授权的 copyrighted 内容(如受保护的小说、代码库、学术论文)进行微调,不仅面临法律风险,还可能导致模型输出侵权内容,进而被平台下架。

自动化检测工具的应用
为了高效识别上述问题,团队应引入自动化检测流程。
- 重复性检测:使用MinHash或SimHash算法计算数据块的指纹,快速定位高度相似的样本,阈值设定建议根据任务复杂度调整,一般相似度超过0.85的样本需重点审查。
- 噪声过滤:利用预训练语言模型计算每句话的困惑度(Perplexity),困惑度过高通常意味着语句不通顺或包含大量噪声,可将其标记为低质量数据。
- 敏感信息扫描:部署正则表达式与NLP模型结合的规则引擎,扫描PII(个人身份信息)及敏感关键词,确保数据脱敏合规。
微调数据集清洗与去重的实操策略
识别问题后,关键在于如何高效清洗,这一步直接决定了最终模型的上限。
构建分层清洗流水线
不要试图用一种方法解决所有问题,建议采用“粗筛-精筛-人工复核”的分层策略。
第一阶段:粗筛去重
这一阶段的目标是快速剔除明显重复和无效数据。
- 文本标准化:统一全角/半角、去除多余空格、标准化标点符号。
- 基于指纹的去重:使用SimHash算法对文档进行分块,计算哈希值,对于哈希值相同的文档,仅保留一条,其余删除。
- 长度过滤:剔除长度过短(如少于10字)或过长(如超过模型上下文窗口限制)的样本,这些样本通常信息密度低或难以处理。
第二阶段:精筛质量评估
在去重基础上,进一步筛选高质量数据。
- 语言模型打分:使用一个轻量级但性能良好的基座模型,对每条数据进行困惑度打分,保留得分最高的前80%数据,剔除尾部低质数据。
- 多样性增强:检查数据在主题、风格、难度上的分布,如果某类数据占比过高,需进行欠采样;如果某类数据缺失,需通过合成数据或补充采集来平衡。
- 指令遵循度检测:

对于指令微调数据,使用规则或模型判断输入指令是否清晰、输出是否完整,剔除指令模糊或回答不相关的样本。

第三阶段:人工抽检与标注
自动化手段无法覆盖所有边缘情况,建议抽取5%-10%的数据进行人工复核。
- 随机抽样:确保样本覆盖不同领域、不同难度等级。
- 专家评估:由领域专家评估数据的准确性、逻辑性和安全性。
- 反馈迭代:将人工发现的问题反馈给自动化流程,优化过滤规则,形成闭环。
2026年主流微调数据清洗工具对比
选择合适的工具能事半功倍,以下是几款在行业内广泛使用的开源工具及其特点。
| 工具名称 | 核心功能 | 适用场景 | 优势 |
|---|---|---|---|
| Deduplicate-Datasets | 基于MinHash的去重 | 大规模文本去重 | 速度快,内存占用低,适合TB级数据 |
| DataFilter | 多模型联合打分 | 高质量数据筛选 | 集成多种打分模型,可自定义权重 |
| LangCleaner | 语言规范性检查 | 多语言数据清洗 | 支持多种语言,擅长处理语法错误 |
| PrivacyGuard | PII识别与脱敏 | 合规性处理 | 规则库更新及时,支持自定义敏感词 |
工具选型建议
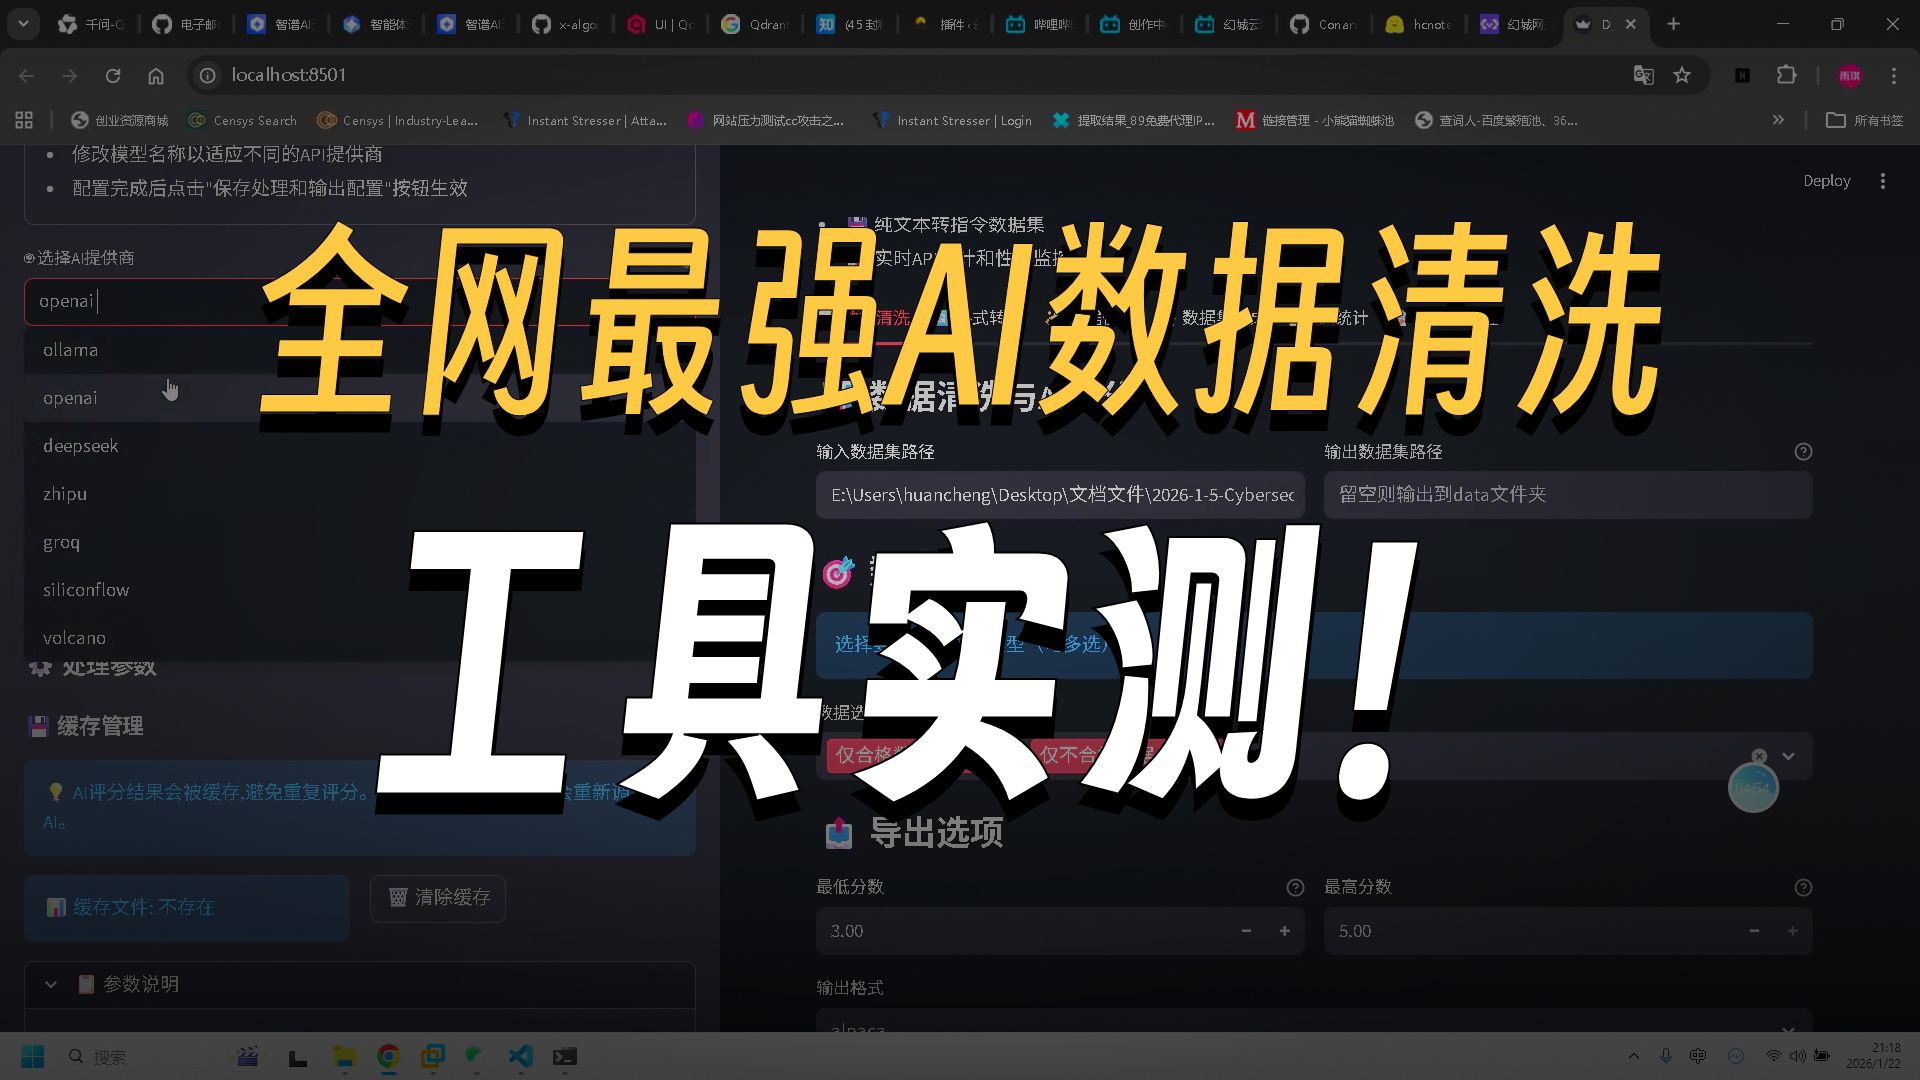
团队应根据自身数据规模和资源情况选择工具,对于初创团队,建议优先使用基于Python的开源库,如datasets库中的去重功能,配合transformers库进行困惑度计算,成本低且灵活,对于大型企业,可考虑构建自研的数据清洗平台,集成上述工具,实现自动化流水线。
微调后模型效果评估与反馈机制
清洗只是第一步,持续监控模型在真实场景中的表现同样重要。
建立多维度评估体系

不要仅依赖单一指标,建议从以下维度评估模型效果:
- 准确性:在测试集上的准确率、F1值。
- 流畅性:通过BLEU、ROUGE等指标评估生成文本的自然度。
- 安全性:使用红队测试(Red Teaming)方法,尝试诱导模型输出有害内容,评估其防御能力。
- 用户满意度:在实际应用中收集用户反馈,分析差评原因,反向追溯数据问题。
数据飞轮效应
构建“数据-模型-反馈-数据”的飞轮,将用户在实际使用中与模型交互的数据(尤其是被用户修正的数据)收集起来,经过清洗后重新加入训练集,定期微调模型,这种持续迭代的方式,能确保模型始终贴合最新需求,避免数据老化带来的性能下降。
大模型微调数据集污染怎么办:Q&A
微调数据集污染对模型性能的具体影响有哪些?
数据污染会导致模型过拟合、泛化能力下降、幻觉增加以及安全性降低,过拟合会使模型在训练数据上表现优异,但在未见数据上表现糟糕;幻觉增加意味着模型会生成看似合理但事实错误的内容;安全性降低则可能使模型被恶意利用。
如何平衡数据清洗的成本与效果?
平衡成本与效果的关键在于分层处理,首先使用低成本自动化规则进行粗筛,剔除明显低质数据;然后使用中等成本的模型打分进行精筛;最后仅对高价值或高风险数据进行人工复核,建立自动化流水线可减少重复劳动,长期来看能显著降低人力成本。
2026年是否有专门针对微调数据污染的法律法规?
是的,2026年各国普遍加强了数据合规监管,欧盟《人工智能法案》明确要求高风险AI系统的训练数据需具备代表性、无偏见且无错误,中国《生成式人工智能服务管理暂行办法》也强调训练数据需合法合规,不得侵犯知识产权和个人隐私,企业需密切关注当地法规,确保数据清洗流程符合法律要求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/392821.html