在本地部署AI大模型的核心在于利用消费级显卡或服务器硬件,通过Ollama、LM Studio等工具加载量化模型,实现数据完全离线、隐私绝对安全且无需订阅费用的私有化智能体验。
为什么选择本地部署而非云端API
过去几年,大多数企业和开发者依赖云端大模型API,但随着应用场景深入,痛点日益凸显,云端调用存在数据泄露风险,敏感商业文档上传后难以保证不被用于训练;网络延迟和按Token计费模式在高频调用下成本激增,本地部署将这些控制权收回手中,虽然初期有硬件门槛,但长期看具备显著优势。
业内专家指出,数据主权已成为企业数字化建设的底线要求,本地模型确保数据不出内网,从根本上切断了第三方窃取或滥用的可能,对于法律、医疗、金融等强监管行业,这种隔离环境是合规的前提,本地模型一旦部署完成,后续调用零边际成本,适合需要高并发、低延迟的实时推理场景。
硬件需求与性能平衡
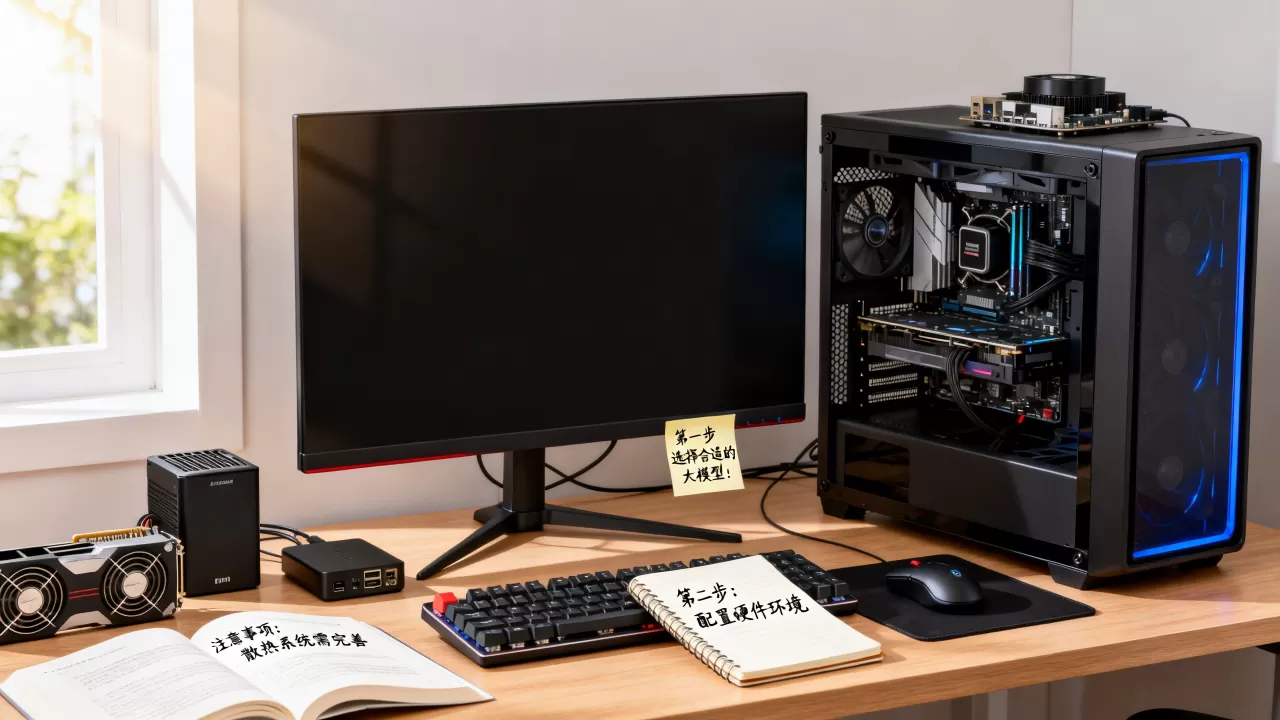
本地部署并非只有顶级显卡才能运行,关键在于理解显存(VRAM)与模型参数的关系,模型参数量越大,智力越高,但占用的显存也越多。
消费级显卡方案
对于个人用户或小型团队,NVIDIA RTX 4090(24GB显存)是目前性价比最高的入门旗舰,它可以流畅运行7B至13B参数量的模型,经过4-bit量化处理后,甚至能勉强支撑30B-34B规模的模型,如果预算有限,RTX 3060(12GB显存)是极佳的起步选择,适合运行7B-8B模型,满足日常写作、代码辅助和基础问答需求。
专业级服务器方案
企业级应用通常需要处理更复杂的逻辑推理或多轮对话,双卡甚至四卡互联成为主流,使用两张RTX 4090或一张A100/A800(40GB/80GB显存),可以部署70B参数量的模型,虽然70B模型在云端API中常见,但在本地运行需要极高的显存带宽支持,否则推理速度会大幅下降。
软件生态与工具链
硬件只是基础,软件工具决定了部署的难易程度,目前主流方案主要分为两类:极简命令行工具和图形化界面工具。
- Ollama:目前最受开发者欢迎的开源项目,它支持macOS、Linux和Windows,通过一行命令即可下载和运行模型,在终端输入
ollama run llama3即可启动模型,它内置了API接口,方便开发者将其集成到现有应用中。 - LM Studio:提供直观的图形界面,适合非技术人员,用户可以直接搜索模型文件(GGUF格式),调整上下文长度和温度参数,并实时预览生成效果,它同样提供本地API服务器功能,兼容OpenAI接口标准。
- Text Generation WebUI (oobabooga):功能最强大的开源界面,支持多种后端引擎(如llama.cpp、vLLM),允许用户加载LoRA微调模型,适合高阶玩家进行深度定制。
本地大模型价格与成本分析
很多人误以为本地部署成本高昂,实则不然,与云端按Token计费相比,本地部署是一次性投入,长期收益显著。
硬件投入对比
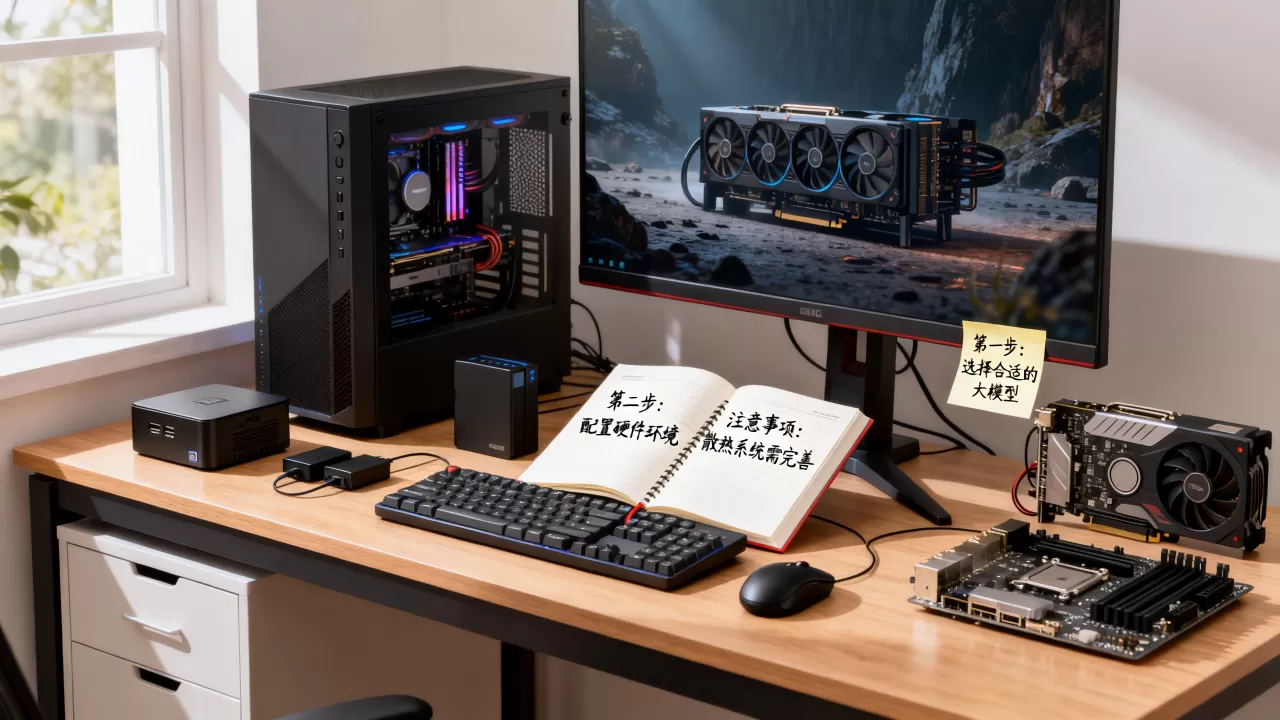
以下表格展示了不同场景下的硬件成本估算:
| 场景 | 推荐配置 | 预估硬件成本 (人民币) | 适用模型规模 |
|---|---|---|---|
| 个人学习 | RTX 3060 12GB |
~1,500元 | 7B-8B (量化) |
| 进阶创作 | RTX 4090 24GB | ~15,000元 | 13B-34B (量化) |
| 企业私有化 | 双卡 RTX 4090 或 A6000 | ~30,000元+ | 70B+ (量化/半精度) |
隐性成本考量
除了硬件,还需考虑电费和维护成本,一台满载运行的RTX 4090功耗约为450W,每天运行8小时,月电费约100元左右,远低于云端API的高频调用费用,本地模型需要定期更新权重文件和软件版本,这部分时间成本由用户自行承担,但换来的是对系统环境的完全掌控。
据工信部数据显示,近年来中小企业数字化转型中,本地化部署比例逐年上升,主要驱动力正是成本控制与数据安全。
实操指南:从零搭建本地AI环境
对于初次尝试的用户,建议从Ollama入手,因其流程最为标准化。
第一步:环境准备
确保你的NVIDIA显卡驱动已更新至最新版本,如果使用AMD显卡或Mac M系列芯片,Ollama同样原生支持,无需额外配置,安装Ollama官方安装包,并在终端验证安装成功,输入ollama --version查看版本号。
第二步:下载与运行模型
打开终端,输入以下命令下载并运行Llama 3.1 8B模型(当前主流高效模型):
ollama run llama3.1
首次运行会自动从Hugging Face拉取模型文件,大小约5GB,下载完成后,终端将进入交互模式,你可以直接输入中文或英文指令。
第三步:集成到应用
Ollama默认在本地启动一个API服务,监听端口11434,你可以使用Python的requests库或LangChain框架轻松调用,发送一个POST请求到http://localhost:11434/api/generate,即可在自定义程序中接入AI能力。
第四步:优化推理速度
如果感觉响应缓慢,可以尝试调整参数,在LM Studio中,增加GPU层数(n_gpu_layers)至最大值,可充分利用显存加速,在Ollama中,可以通过设置环境变量OLLAMA_NUM_PARALLEL来限制并发请求数,避免显存溢出。
常见问题解答
本地大模型配置需要多少内存和硬盘空间?
内存(RAM)建议至少16GB,推荐32GB以上,以便在显存不足时进行CPU卸载加速,硬盘空间取决于模型数量,一个7B模型约5-6GB,70B模型约40GB,建议预留100GB以上SSD空间,因为模型加载和交换过程对磁盘读写速度敏感,使用NVMe SSD能显著提升加载速度。
本地大模型配置后能否实现多语言支持?
绝大多数现代开源模型(如Llama 3、Qwen、Yi)均具备优秀的多语言能力,包括中文、英文、法语等,无需额外配置语言包,只需在提示词中使用相应语言即可,但需注意,部分早期模型在中文理解上存在偏差,建议优先选择经过中文语料微调的版本,如Qwen系列或InternLM系列。
本地大模型配置失败常见原因有哪些?
最常见的原因是显存不足导致OOM(Out Of Memory)错误,解决方法包括:降低模型量化位数(如从Q4降至Q2,虽牺牲精度但节省显存),或减少上下文长度(context length),其次是驱动版本过旧,需更新显卡驱动,最后是防火墙拦截了本地API端口,需确保11433或11434端口未被阻止。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/383777.html