AI语言大模型的核心原理是基于Transformer架构,通过海量文本数据训练,利用注意力机制捕捉上下文关联,从而以概率预测的方式生成自然语言。
从“猜词游戏”到“逻辑推理”的技术跃迁
很多人误以为大模型像人类一样拥有真正的意识或理解能力,但业内专家指出,其本质更像是一个极其复杂的“超级猜词机器”,它并不真正懂得什么是“苹果”,也不理解“悲伤”的情绪,它只是通过计算,在无数种可能的下一个字中,选出概率最高的那一个,这种基于统计学的预测机制,构成了现代人工智能的基石。

Transformer架构:打破传统序列的枷锁
在2017年之前,处理文本主要依赖循环神经网络(RNN)或长短期记忆网络(LSTM),这些老式结构像是一个只能记住前几个字的“金鱼”,处理长文本时容易遗忘前面的信息,Transformer架构的出现彻底改变了这一局面,它引入了“自注意力机制”(Self-Attention)。
想象你在阅读一篇长文章,当你看到“他”这个代词时,大脑会自动回溯去查找前文中“他”指的是谁,自注意力机制让模型在读取每一个词时,都能同时关注到句子中所有其他词的重要性,这种并行处理能力不仅大幅提升了训练速度,更让模型能够捕捉到跨越数百个词的长距离依赖关系。
预训练与微调:从“博学”到“专精”
大模型的诞生通常分为两个关键阶段,这解释了为什么我们需要区分通用大模型与垂直领域应用。
- 预训练(Pre-training):这是模型的“通识教育”阶段,模型在数千亿甚至万亿级的文本数据上进行无监督学习,它不需要人工标注标签,而是通过“掩码语言模型”任务,比如遮住句子中的一个词,让模型去猜,在这个过程中,模型学会了语法、事实知识、甚至基本的逻辑推理能力,据行业共识认为,这一阶段消耗了巨大的算力资源,旨在构建一个通用的世界知识图谱。
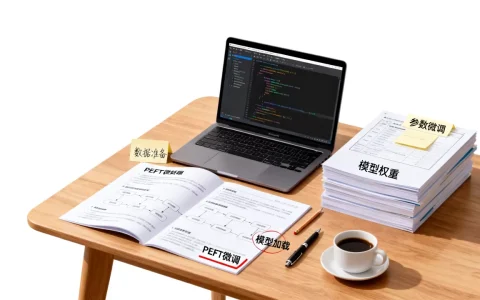
- 微调(Fine-tuning):这是“职业教育”阶段,预训练后的模型虽然博学,但可能不会按照人类期望的方式回答问题,甚至可能输出有害内容,通过指令微调(Instruction Tuning),开发者使用高质量的人机对话数据对模型进行训练,让它学会遵循指令、识别意图,并符合人类价值观,这一过程显著提升了模型在特定任务上的表现,使其从“知识仓库”转变为“智能助手”。
注意力机制如何模拟人类思维
理解大模型的关键,在于看懂它是如何处理信息的,注意力机制并非简单的加权平均,而是一种动态的信息筛选过程。
查询、键与值的三角关系
在技术实现上,每个输入的词向量会被映射为三个向量:查询(Query)、键(Key)和值(Value)。
- Query:代表当前词想要寻找什么信息。
- Key:代表当前词能提供什么信息。
- Value:代表当前词携带的实际内容。
当模型处理句子“猫坐在垫子上”时,对于“猫”这个词,它的Query会与“垫子”的Key进行匹配,如果匹配度高,说明“垫子”对理解“猫”的位置很重要,模型就会赋予“垫子”的Value更高的权重,这种机制让模型能够根据上下文动态调整对每个词的关注程度,从而实现精准的理解。
上下文窗口与记忆限制
尽管注意力机制强大,但它并非无限,模型的上下文窗口(Context Window)决定了它能一次性“多少内容,早期的模型只能处理几千个token,而近年来主流模型已支持数十万甚至百万级token,随着上下文变长,计算复杂度呈平方级增长,这带来了显著的延迟和成本压力,如何高效管理长文本记忆,成为当前技术优化的重点方向。
从原理到应用:场景化落地指南
理解了原理,我们就能更清晰地判断哪些场景适合使用大模型,以及如何优化使用效果。
创作与辅助写作
在营销文案、新闻稿或创意写作中,大模型能迅速生成草稿,用户只需提供核心关键词和风格要求,模型即可基于预训练数据中的语言模式,生成结构完整、逻辑通顺的文本。
- 提示词工程:明确角色设定(如“你是一位资深编辑”)、任务目标、输出格式和约束条件。
- 迭代优化:不要期望一次生成完美结果,通过多轮对话,逐步修正模型的输出,引导其向预期方向调整。
代码生成与调试
对于开发者而言,大模型不仅能生成代码片段,还能解释复杂逻辑、查找Bug,由于代码具有严格的语法结构,大模型在编程任务上的表现尤为出色。
- 代码补全:在IDE中集成大模型插件,根据当前代码上下文自动推荐后续代码。
- 自然语言转代码:用中文描述需求,让模型生成Python或JavaScript代码,大幅降低入门门槛。
数据分析与洞察提取
面对非结构化数据(如用户评论、客服录音),大模型能进行情感分析、主题聚类。
- 情感分类:自动识别评论中的正面、负面或中性情绪。
- 关键信息抽取:从长篇报告中提取关键数据点、趋势和结论。
常见误区与未来展望
幻觉问题:为什么模型会“胡说八道”?
由于大模型是基于概率预测的,当训练数据中缺乏相关信息或信息模糊时,模型可能会自信地生成错误内容,这种现象被称为“幻觉”,通过引入检索增强生成(RAG)技术,让模型在生成回答前先检索外部知识库,能显著降低幻觉率。
算力成本与绿色AI
训练和运行大模型需要巨大的算力支持,这不仅带来高昂的经济成本,也引发能源消耗的担忧,模型压缩、量化技术以及更高效的算法将帮助降低部署门槛,让大模型在边缘设备上运行成为可能。
人机协作的新范式
大模型不会完全取代人类,而是成为人类的“认知外骨骼”,它将重复性、低创造性的工作自动化,让人类专注于更具战略性和创造性的任务,未来的核心竞争力,将是如何有效地与AI协作,提出精准的问题,并批判性地评估AI的输出。
AI语言大模型原理相关问答
AI语言大模型原理中,什么是Token?
Token是大模型处理文本的基本单位,可以是一个字、一个词或一个子词,模型并不直接理解字符,而是将文本转换为Token ID序列进行计算,分词方式直接影响模型的效率和上下文理解能力,常见的分词算法包括BPE(字节对编码)和WordPiece。
AI语言大模型原理如何保证回答的安全性?
安全性主要通过多层过滤机制实现,首先在训练阶段,通过人类反馈强化学习(RLHF)剔除有害内容;在推理阶段,部署内容安全过滤器,实时检测并拦截违规请求;通过持续监控和更新模型,应对新型攻击和偏见。
AI语言大模型原理在中文场景下的表现差异?
中文具有单音节字多、无空格分隔等特点,对分词算法要求更高,中文大模型通常在中文语料上进行了更充分的预训练,因此在成语、诗词、文化隐喻的理解上优于通用模型,中文语境下的语义细微差别需要更精细的微调数据支持,才能提升回答的准确性和地道性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/384657.html