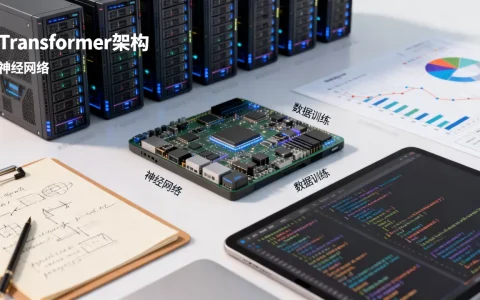
建立大模型的核心在于构建高质量数据流水线、选择适配的算力集群并采用分布式训练框架,目前主流路径已从从头预训练转向基于开源基座模型的指令微调与强化学习对齐。
大模型构建的底层逻辑与核心组件
构建一个大语言模型并非简单的代码堆砌,而是一场涉及数据、算法与算力的精密工程,业内专家指出,数据的质量直接决定了模型的认知上限,而算力的规模则决定了模型的推理速度与复杂度。

数据清洗:模型的“粮食”来源
数据是大模型的燃料,没有经过清洗的原始数据如同混杂着沙石的矿石,无法炼出高纯度的金属。
数据收集策略
– 多源采集:涵盖网页爬虫、书籍、学术论文、代码库及专业领域文档。
– 去重处理:使用MinHash算法去除重复内容,确保训练数据的多样性。
– 质量过滤:通过困惑度(Perplexity)评分剔除低质量文本,保留逻辑连贯、事实准确的内容。
数据标注与指令构建
为了让模型学会“听话”,需要构建高质量的指令数据集(Instruction Tuning Data),这包括:
– SFT数据:监督微调数据,用于教会模型遵循人类指令。
– RLHF数据:基于人类反馈的强化学习数据,用于优化模型价值观和安全性。
算力基础设施:训练的“引擎”
训练千亿参数级别的大模型需要庞大的算力支持。
- GPU集群:目前主流选择是NVIDIA A100或H100集群,或国产华为昇腾910B集群。
- 网络互联:采用InfiniBand或RoCE网络,确保节点间通信低延迟、高带宽。
- 存储系统:使用高性能并行文件系统,满足海量数据的高速读写需求。
技术路线选择:从头训练还是微调优化?
对于大多数企业和开发者而言,从头训练一个大模型既昂贵又不现实,选择合适的技术路线至关重要。

预训练模型的获取与评估
开源社区提供了丰富的基座模型,如Llama 3、Qwen、ChatGLM等。
- 模型选型:根据任务需求选择参数量,通用对话可选7B-14B参数模型,复杂推理可选70B以上参数模型。
- 性能评估:使用C-Eval、CMMLU等基准测试集评估模型的中文理解与推理能力。
指令微调(SFT)实操步骤
指令微调是让通用模型转化为垂直领域专家的关键步骤。
- 数据准备:整理领域内的问答对、对话历史及任务描述。
- 格式转换:将数据转换为模型支持的格式,如Alpaca格式或ShareGPT格式。
- 模型加载:使用LoRA或QLoRA技术加载基座模型,降低显存占用。
- 训练配置:设置学习率、批次大小、训练轮数等超参数。
- 验证与调优:在验证集上监控损失函数,防止过拟合。
强化学习对齐(RLHF/DPO)
微调后的模型可能仍存在幻觉或偏见问题,需要通过强化学习进行对齐。
- 奖励模型训练:构建一个奖励模型,用于评估模型输出的质量。
- PPO/DPO算法:使用近端策略优化(PPO)或直接偏好优化(DPO)算法,根据奖励信号调整模型参数。
- 安全过滤安全过滤器,防止生成违规或有害内容。
常见误区与成本考量
在建立大模型的过程中,许多团队容易陷入误区,导致资源浪费或效果不佳。
数据质量的陷阱
许多团队认为数据越多越好,但实际上,低质量数据会严重损害模型性能。
- 噪声污染:未清洗的数据包含大量错误信息,导致模型学习错误模式。
- 偏见放大:如果训练数据存在社会偏见,模型会放大这些偏见,导致输出不公。
- 解决方案:建立严格的数据审核机制,引入人工校验环节。

算力资源的误区
算力并非越大越好,关键在于效率。
- 显存瓶颈:大模型训练受限于显存大小,需使用模型并行、张量并行等技术优化。
- 通信开销:分布式训练中,节点间通信可能成为瓶颈,需优化网络拓扑结构。
- 成本控制:采用混合精度训练、梯度累积等技术,降低显存占用,提高训练效率。
应用场景匹配
不同场景对模型的要求不同,需针对性优化。
- 客服场景:注重响应速度与准确性,可使用较小参数模型配合RAG技术。
- 创作场景:注重创意与多样性,可使用较大参数模型并调整温度参数。
- 代码生成:注重逻辑严谨性,需使用专门训练的代码模型。
未来趋势与行业展望
大模型技术仍在快速发展,未来将呈现以下趋势。
多模态融合
单一文本模态已无法满足复杂需求,多模态大模型将成为主流。
- 图文理解:模型将同时处理图像与文本,实现更丰富的交互体验。
- 视频生成:结合扩散模型,实现高质量视频内容的自动生成。
- 语音交互:实时语音识别与合成,提升人机交互的自然度。
端侧部署与轻量化
随着芯片性能提升,大模型将向端侧迁移。
- 模型压缩:通过量化、剪枝、蒸馏等技术,减小模型体积。
- 边缘计算:在手机、PC等终端设备上运行小型化大模型,保护用户隐私。
- 实时推理:降低延迟,实现毫秒级响应,提升用户体验。
行业垂直化深化
通用大模型将向垂直行业深入,提供更专业的服务。

- 医疗辅助:辅助医生进行诊断、病历分析及药物研发。
- 金融风控:实时监测交易风险,提供智能投顾建议。
- 法律咨询:快速检索法律法规,生成法律文书初稿。
建立大模型常见问题解答
建立大模型需要多少启动资金?
建立大模型的成本差异巨大,取决于技术路线与规模,若选择基于开源基座模型进行指令微调,主要成本在于算力租赁与数据清洗,初期投入可能在几万元至几十万元人民币之间,适合中小企业验证场景,若选择从头预训练千亿参数模型,则需构建千卡级GPU集群,成本高达数千万元甚至上亿元,通常仅适合头部科技巨头或国家级科研项目,业内共识认为,对于大多数商业应用,微调现有开源模型是性价比最高的选择。
大模型训练需要多长时间?
训练时长主要取决于模型参数量、数据集大小及算力集群规模,以千亿参数模型为例,在千卡A100集群上,从头预训练可能需要数周时间;而基于开源模型进行指令微调,通常只需数天甚至数小时,数据预处理与清洗往往占据总时间的较大比例,建议预留充足时间进行数据质量把控,据统计,多数情况下,数据准备阶段耗时约为模型训练阶段的1.5倍至2倍。
如何评估自建大模型的效果?
评估大模型效果需结合自动化指标与人工评估,自动化指标包括BLEU、ROUGE等文本相似度指标,以及困惑度(PPL)等语言模型指标,但这些指标无法完全反映模型的真实能力,人工评估更为关键,需设计涵盖事实准确性、逻辑连贯性、安全性及有用性的多维评分表,由领域专家对模型输出进行盲测打分,行业共识认为,最终效果应以实际业务场景中的用户满意度为准,而非单纯依赖基准测试分数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/386447.html