AI大模型为何频频翻车?大模型应用失败案例解析

AI大模型翻车并非技术失效,而是提示词工程、数据幻觉与业务场景错位共同导致的系统性风险,解决之道在于建立“人机协同”的校验机制而非盲目依赖算法。

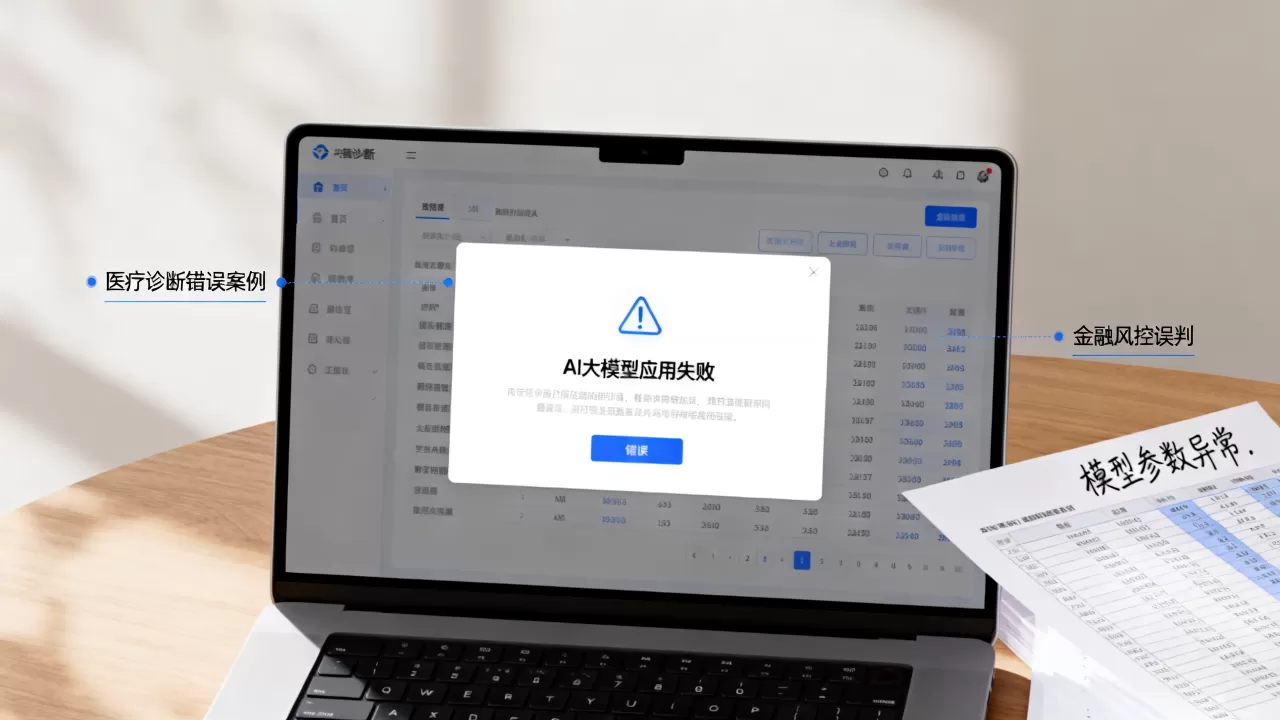
2026年至2026年,企业级AI应用从“尝鲜期”迅速进入“深水区”,许多团队发现,曾经惊艳的演示Demo在实际生产环境中频频出错:代码生成逻辑断裂、客服回复前后矛盾、分析报告数据张冠李戴,这种现象被业界通俗地称为“AI大模型翻车”,这并非单一的技术故障,而是技术成熟度与业务期望值之间的巨大落差,理解这一落差的成因,并掌握规避策略,是当前数字化团队的核心竞争力。
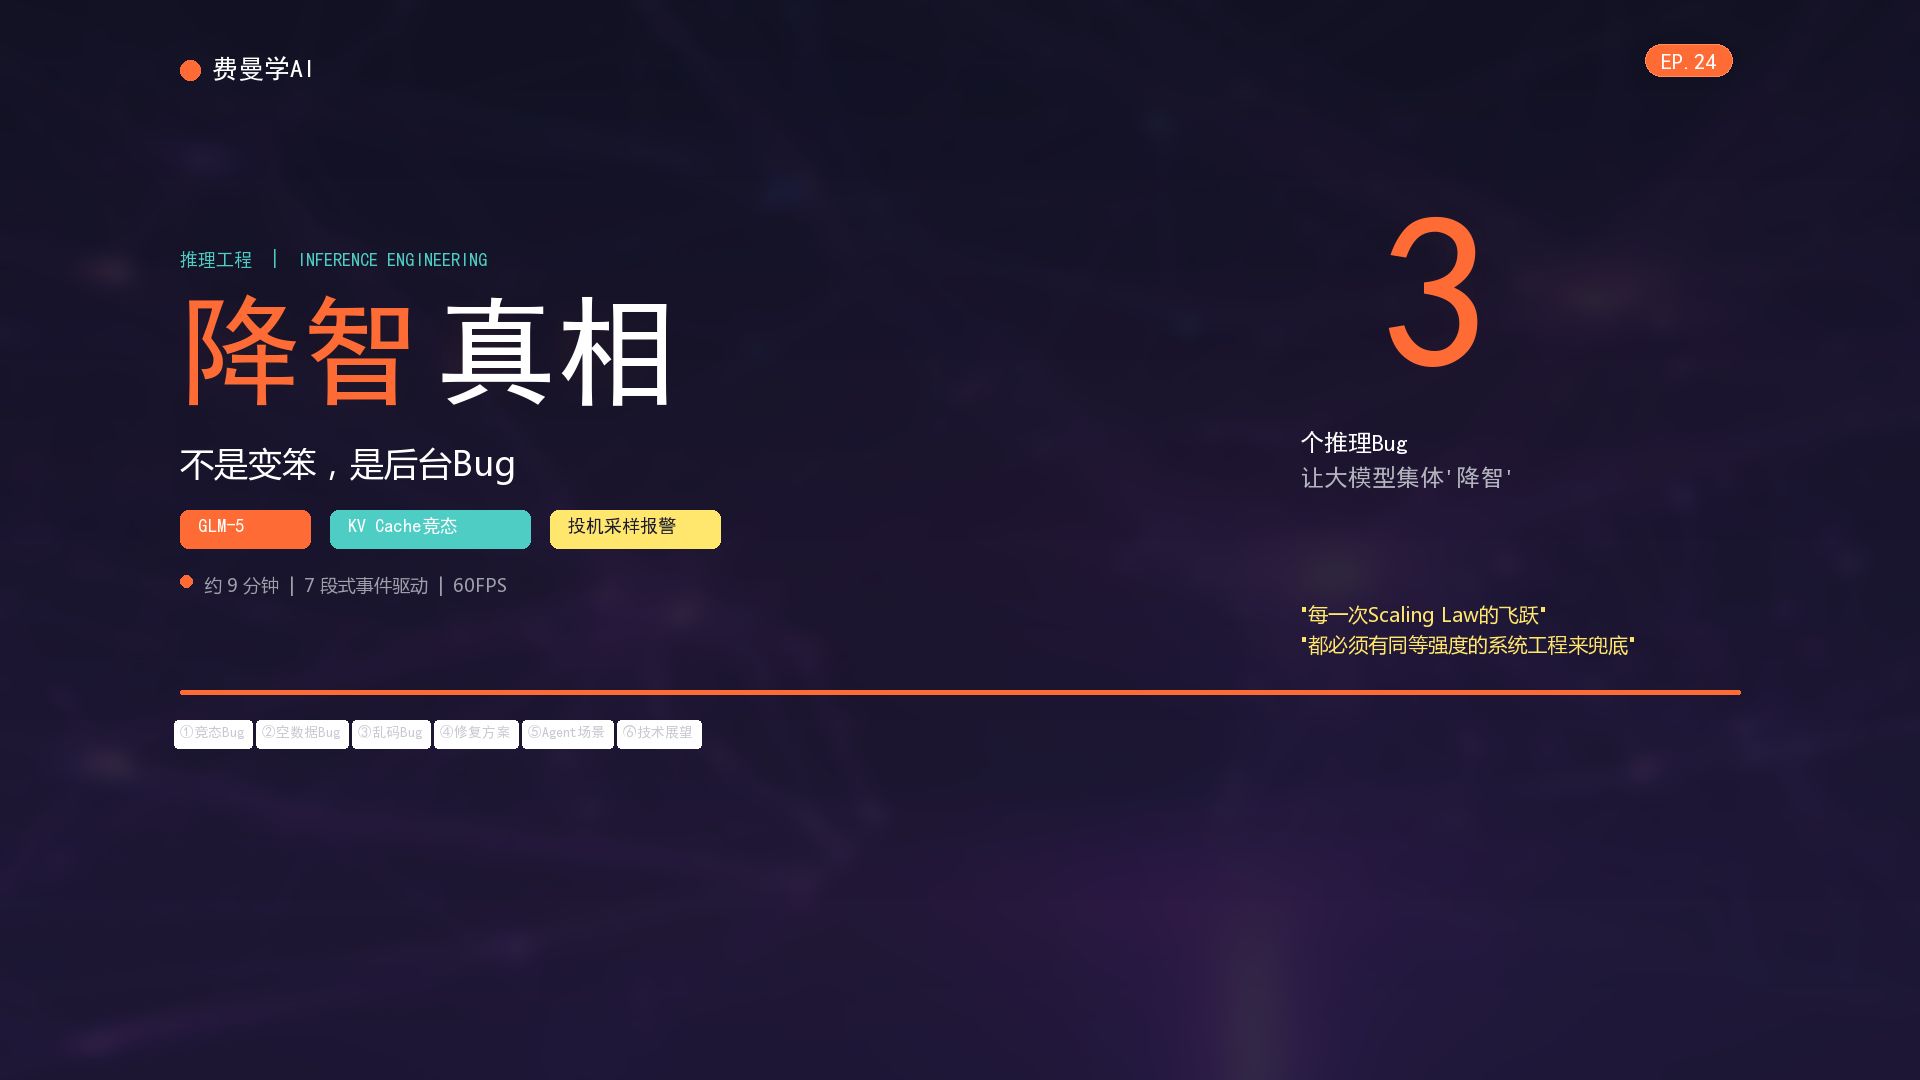
大模型"降智"真相:不是变笨,是后台Bug | 智谱GLM-5推理工程深度拆解 | 3个让AI集体翻车的推理Bug | 费曼学AI EP.24
加载中
大模型"降智"真相:不是变笨,是后台Bug | 智谱GLM-5推理工程深度拆解 | 3个让AI集体翻车的推理Bug | 费曼学AI EP.24

AI大模型翻车的核心成因深度解析

AI并非拥有真实意识的智能体,而是基于概率预测下一个字的统计模型,这种底层逻辑决定了其固有的局限性。

幻觉问题:一本正经地胡说八道

“AI幻觉”是翻车最高频的场景,模型在缺乏确切知识时,会倾向于生成通顺但虚假的内容。

  • 事实性错误:在撰写行业报告时,AI可能编造不存在的市场数据或引用虚构的文献,询问“2026年某小众芯片厂商的营收”,模型可能根据类似案例生成看似合理的数据,实则完全捏造。
  • 逻辑自洽陷阱:AI擅长构建内部逻辑闭环,即使前提错误,如果用户输入了错误的前提条件,AI会基于此前提推导出看似严谨但结论荒谬的结果。

业内专家指出,幻觉问题在开放域问答中尤为显著,而在结构化数据查询中相对可控,将AI用于创造性写作与用于严谨的数据分析时,需采用不同的信任阈值。

上下文窗口与注意力分散

的增加,模型的“注意力”会被稀释。

  • 长文档处理失效:当上传数十页的PDF文档要求提取关键信息时,模型往往只能关注开头和结尾,中间部分的关键细节极易被忽略。
  • AI大模型为何频频翻车?大模型应用失败案例解析

  • 指令遵循偏差:在多轮对话中,早期的指令可能被后续的新话题覆盖,导致模型忘记“不要使用专业术语”或“保持语气幽默”等约束条件。
数据偏见与伦理红线

训练数据的来源决定了AI的价值观倾向。

  • 刻板印象强化:若训练数据中包含性别或地域偏见,AI生成的招聘文案或新闻评论可能无意中强化这些偏见,导致品牌声誉受损。
  • 触发:在特定语境下,AI可能因过度敏感而拒绝回答正常问题,或因防御机制失效而输出不当内容,造成公关危机。

不同场景下的翻车表现与应对策略

针对常见的业务场景,AI的表现差异巨大,盲目套用同一套提示词会导致截然不同的结果。

代码开发场景:逻辑漏洞与语法错误

在软件开发中,AI生成的代码往往能运行,但存在隐蔽的逻辑缺陷。

  • 常见问题:变量命名冲突、边界条件处理遗漏、依赖库版本不兼容。
  • 实操建议:
    1. 分步生成:不要要求AI一次性生成整个模块,而是先让AI设计类结构,再逐步实现具体函数。
    2. 单元测试驱动:要求AI同时生成对应的单元测试用例,通过测试用例来验证代码的正确性。
    3. 人工审查重点:重点关注异常处理逻辑和资源释放机制,这些是AI最容易忽略的部分。
      创作场景:同质化与缺乏深度

营销文案和新闻稿是AI翻车的高发区,主要表现为内容空洞、语气平淡。

  • 常见问题:文章结构模板化严重,缺乏独特观点,情感共鸣弱。
  • 实操建议:
    1. 提供具体素材:不要只给主题,需提供具体的案例、数据、用户反馈等原始素材,让AI基于事实进行重组。
    2. AI大模型为何频频翻车?大模型应用失败案例解析

    3. 设定人设与语气:明确指定目标受众、品牌调性(如“专业严谨”或“亲切幽默”),并给出正面和负面的示例。
    4. 多轮迭代优化:将AI生成的初稿作为草稿,通过追问要求“增加具体案例”、“强化情感色彩”或“缩短段落”,逐步打磨。

数据分析场景:计算错误与图表误导

AI在数学计算和复杂数据解读上表现不佳,容易犯低级错误。

  • 常见问题:简单的加减乘除出错,对图表趋势解读偏差,混淆相关性因果关系。
  • 实操建议:
    1. 使用代码解释器:对于需要计算的任务,务必启用支持Python代码执行的AI工具,让代码完成计算而非让语言模型直接输出结果。
    2. 交叉验证:将AI的分析结论与Excel、SQL等传统工具的结果进行比对,确保数据一致性。
    3. 明确数据口径:在提问时,清晰定义指标的计算方式(如“活跃用户”是指日活还是月活),避免歧义。

构建企业级AI防翻车体系

单个用户的提示词技巧有限,企业需要建立系统性的风控机制。

提示词工程标准化

建立统一的提示词模板库,减少随意性。

  • 结构化提示词:采用“角色+背景+任务+约束+输出格式”的结构。“你是一位资深数据分析师(角色),请分析这份销售报表(背景),找出增长最快的三个产品(任务),要求使用表格展示,并标注数据来源(约束)。”
  • 思维链引导:要求AI在给出最终答案前,先列出推理步骤,这不仅能提高准确性,还便于人工审查逻辑漏洞。
  • AI大模型为何频频翻车?大模型应用失败案例解析

人工审核流程嵌入

AI不应是终点,而是起点。

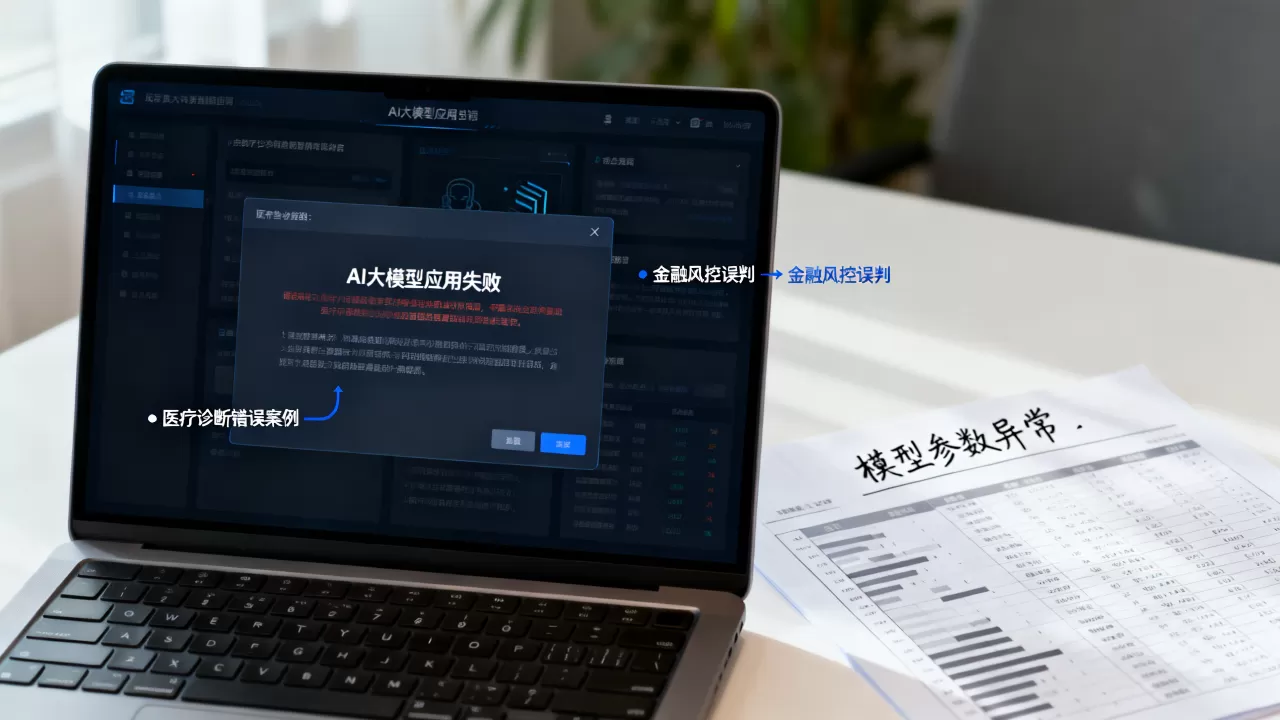
  • 分级审核制度风险等级设定不同的审核流程,高风险内容(如法律、医疗、金融建议)必须经过专业人员复核;低风险内容(如创意灵感)可快速发布。
  • 反馈闭环机制:建立用户反馈渠道,记录AI的错误案例,定期用于微调模型或优化提示词库。

技术架构优化

利用RAG(检索增强生成)和Agent(智能体)技术弥补大模型的不足。

  • RAG应用:将企业私有数据存入向量数据库,让AI在生成回答时先检索相关知识,减少幻觉。
  • 多智能体协作:设计多个专用AI角色(如“研究员”、“编辑”、“审核员”),让它们相互协作和校验,提高最终输出的质量。

常见问题解答

AI大模型翻车是否意味着技术不成熟?

当前大模型在通用语言理解和生成上已相当成熟,但在特定领域的精确性和可靠性上仍有局限,翻车更多是应用场景与模型能力不匹配的结果,而非技术本身完全不可用,随着多模态技术和推理能力的提升,翻车率正在逐步降低。

如何判断AI生成的数据是否可信?

对于关键数据,永远不要直接采信,应要求AI提供数据来源链接,或通过其他权威渠道进行交叉验证,对于无法验证的数据,默认视为不可信,在商业决策中,AI生成的数据仅作为参考线索,而非最终依据。

企业引入AI后是否需要大量技术人员维护?

初期确实需要技术人员搭建RAG系统、优化提示词和监控模型表现,但随着低代码平台和API服务的普及,日常维护工作量正在减少,核心在于业务人员需具备基本的AI素养,能够准确描述需求并识别输出质量,而非依赖纯技术团队解决所有问题。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/387871.html

赞 (0)
个人云存储巅峰时刻是什么?个人云存储哪个牌子好
上一篇 2026年6月16日 06:40
IDC机房容灾备份方案怎么做?容灾备份方案有哪些类型
下一篇 2026年6月16日 06:41

相关推荐

  • 大模型如何生成3D模型?3D生成技术有哪些

    大模型3D生成技术正通过文本或图像直接驱动几何体与材质构建,彻底颠覆传统手工建模流程,实现从创意到可用资产的秒级转化,大模型3D生成技术核心解析过去,制作一个高质量的3D模型需要建模师花费数天甚至数周时间进行拓扑、UV展开和贴图绘制,生成式AI改变了这一格局,这项技术不再依赖人工逐点构建,而是利用深度学习算法……

    2026年6月20日
    6400
  • IPv6的FTP服务器地址是什么?,怎么设置

    IPv6的FTP服务器地址,核心区别在于必须用中括号[]将IPv6地址括起来,再紧跟端口号,例如[2001:db8::1]:21,否则标准FTP客户端无法正确解析,IPv6 FTP服务器地址格式与填写方法这是很多新手一开始就卡住的地方,IPv6地址本身包含冒号,和FTP地址中端口分隔符的冒号冲突,因此IETF标……

    2026年8月3日
    900
  • 服务器如何区分不同客户端?服务器怎么识别唯一设备

    服务器通过“IP地址+端口号”的组合唯一标识客户端,并在TCP连接建立时通过三次握手确认身份,后续通信则依赖会话状态或Token维持区分,想象一下,服务器就像是一个巨大的呼叫中心,而客户端就是打进来的电话,如果所有电话都混在一起,客服根本不知道谁在说话,更别提处理各自的业务了,在数字世界里,这种“区分”是系统稳……

    2026年7月8日
    19400
  • 服务器内存为何如此便宜?二手服务器内存选购指南

    服务器内存之所以便宜,核心原因在于DDR5技术的规模化量产大幅降低了单比特成本,加上二手拆机件市场的成熟流通,使得企业级存储硬件的获取门槛显著降低,技术迭代带来的成本红利DDR5普及如何压缩价格空间内存行业遵循着典型的摩尔定律周期,每当新一代内存标准确立,初期的高昂溢价会随着产能爬坡迅速消散,近年来,DDR5内……

    2026年7月3日
    2900
  • IV值和WOE值记录怎么查看,值集是什么意思?

    IV值和WOE值记录与查看值集是风控模型特征筛选的核心环节,通过分箱计算WOE并汇总IV值,你能快速判断变量对违约事件的预测能力,从而筛选出高区分度的变量,IV值和WOE值怎么计算:分箱与记录值集无论你使用Python还是商业风控平台,记录IV值和WOE值集的第一步都是分箱,分箱的目的是将连续变量或类别变量划分……

    2026年8月10日
    1400
  • 服务器内存盘是什么?服务器内存盘和固态硬盘区别

    服务器内存盘是将数据直接存储在RAM中的高性能存储方案,其读写速度远超传统SSD,但断电后数据会丢失,因此最适合对IOPS要求极高且允许数据非持久化的场景,如数据库缓存、临时文件处理或高性能计算,在云计算和大数据时代,存储性能往往成为制约业务扩展的瓶颈,传统机械硬盘(HDD)受限于物理结构,随机读写能力极弱;即……

    2026年7月1日
    2700
  • 大模型量化对性能影响有多大?大模型量化技术原理详解

    大模型量化对性能的影响是“以微小的精度损失换取显著的资源节省和速度提升”,在多数实际业务场景中,这种权衡是极具性价比且完全可接受的,当我们谈论大语言模型(LLM)时,往往会被其惊人的参数量吓退,动辄千亿级别的参数意味着巨大的显存占用和计算开销,量化技术正是为了解决这一痛点而生,它通过降低模型权重的数值精度,比如……

    2026年6月22日
    3400
  • 如何给IB网卡手动配置IP地址?ib配置地址详细步骤有哪些?

    要给IB网卡手动配置IP地址,核心是通过IPoIB驱动将IP协议层绑定到InfiniBand链路层,在Linux系统中使用ifconfig或ip命令临时配置,或通过编辑网络配置文件永久生效,ib网卡手动配置ip地址的核心步骤确认IPoIB驱动与硬件状态配置IP前,先用ibstat查看IB端口状态,输出应显示“A……

    2026年8月18日
    1500
  • AI大模型专科建议有哪些?AI大模型学习路径推荐

    AI应用开发与低代码集成对于具备一定编程基础(如Python、JavaScript)的专科生,这一方向更具职业护城河,企业需要的不是从零训练模型的人,而是能将大模型API接入现有业务系统的人,技术栈重点API调用与封装:学习如何调用主流大模型接口,并处理返回数据的格式转换,LangChain框架应用:掌握这一主……

    2026年6月15日
    2500
  • Flask租用服务器怎么操作?flask租用服务器多少钱

    Flask应用租用服务器的核心在于根据流量规模选择弹性云主机,初期建议选用1核2G配置搭配Nginx反向代理,通过Docker容器化部署实现低成本、高可用的快速上线,很多开发者在将Python Flask项目从本地开发环境迁移到生产环境时,往往陷入“买什么配置”和“怎么部署”的纠结中,服务器选型并非越贵越好,而……

    2026年7月3日
    14710

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注