


2026年AI大模型架设的核心在于构建“私有化部署+行业微调+边缘推理”的混合架构,以平衡数据安全、响应速度与算力成本,而非单纯追求通用大模型的云端调用。
随着生成式人工智能从概念验证走向深度产业融合,企业不再满足于直接调用公有云API,数据隐私合规、业务逻辑的精准度以及长期运营成本的管控,成为决定技术落地成败的关键变量,传统的“买服务器、装软件”模式已无法应对当前复杂的业务场景,取而代之的是基于容器化、微服务化的灵活部署方案。
私有化部署 vs 云端API:成本与安全的博弈
在决定如何架设大模型时,首要问题是选择部署路径,这不仅仅是技术选型,更是商业战略的考量。
云端调用的隐形成本陷阱
许多初创团队倾向于使用云端API,因为初期投入极低,随着调用量的增加,计费模式往往成为预算黑洞。
- Token计费的不确定性:云端服务通常按Token数量计费,对于高频业务场景,如智能客服或内容批量生成,月度账单可能远超预期。
- 数据主权风险:敏感业务数据经过第三方服务器,即便有保密协议,仍存在合规隐患,特别是在金融、医疗等强监管行业,数据出境或出域是红线。
- 延迟瓶颈:网络波动直接影响用户体验,对于需要毫秒级响应的实时交互场景,云端链路的不稳定性是致命缺陷。
本地部署的硬件门槛与优化策略
本地部署虽然前期硬件投入大,但长期来看具备成本可控的优势,业内专家指出,当并发请求量超过一定阈值后,自建集群的单位成本将显著低于云端调用。
- 算力选型建议:不必盲目追求最新旗舰显卡,对于70B参数以下的模型,通过量化技术(如INT4/INT8),在消费级或入门级专业显卡上即可实现流畅推理。
- 显存优化技术:利用vLLM、TensorRT-LLM等推理加速框架,可以大幅提升吞吐量,这些工具能自动管理显存,实现连续批处理(Continuous Batching),让单卡性能提升数倍。
- 混合架构趋势:最佳实践往往是“核心数据本地化+非敏感任务云端化”,客户隐私数据在本地模型处理,而创意性内容生成则调用云端大模型。
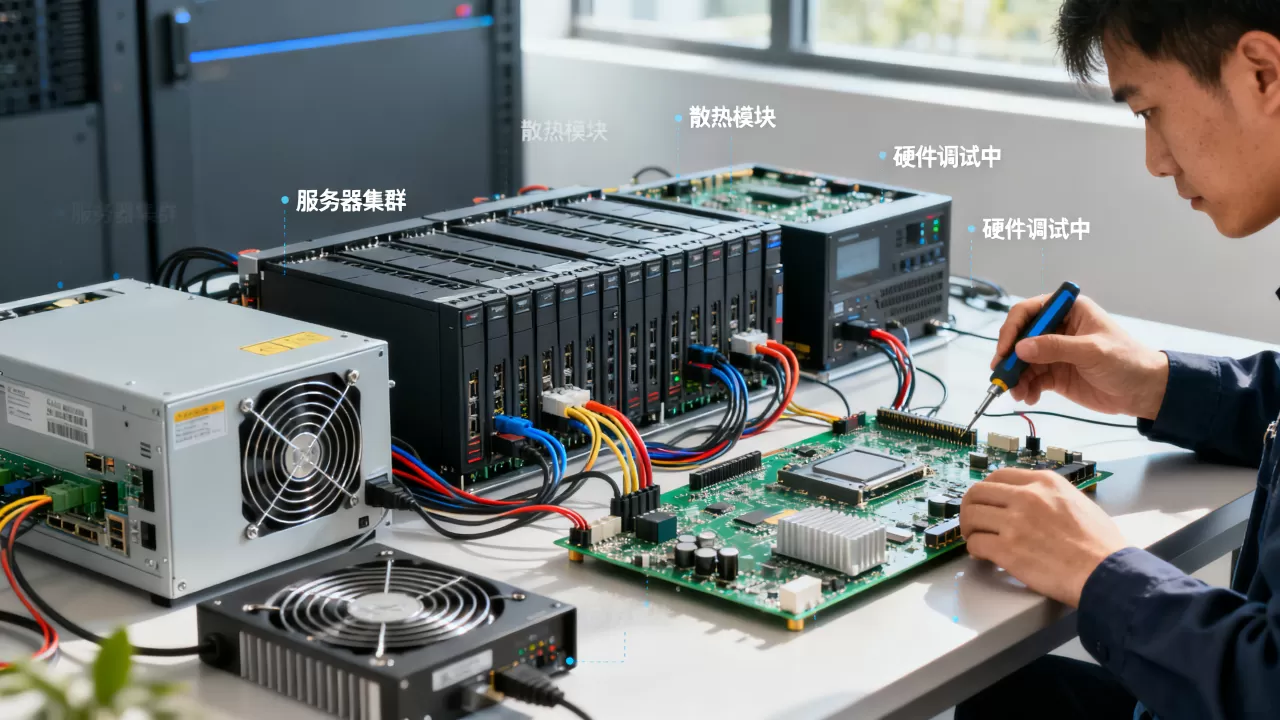
2026年主流大模型架设技术栈解析
到了2026年,大模型的基础设施已经高度标准化,一套成熟的架设方案通常包含模型层、推理层和应用层。
模型选择:开源与闭源的平衡
企业应根据自身需求选择基座模型。
- 开源模型优势:如Llama系列、Qwen系列等,允许完全定制和微调,适合需要深度融入业务逻辑的场景。
- 闭源模型优势:在通用知识覆盖和指令遵循上表现更佳,适合快速原型开发或对特定领域知识要求不高的场景。
- 小模型崛起:7B至14B参数的小模型在特定垂直领域经过微调后,性能往往优于未经微调的大模型,且推理成本极低。
推理引擎与容器化部署
Docker和Kubernetes已成为标配,通过容器化,可以实现模型的快速迭代和弹性伸缩。
- 微服务架构:将嵌入生成、文本分类、对话管理等模块拆分为独立服务,便于单独维护和升级。
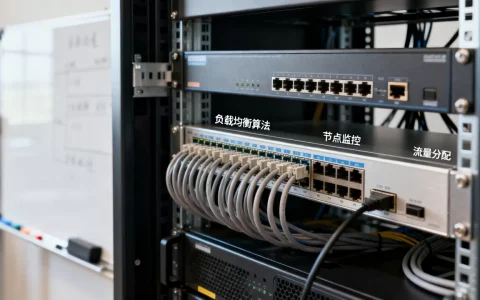
- 负载均衡:使用Nginx或K8s Ingress进行流量分发,确保高并发下的系统稳定性。
向量数据库与RAG架构
检索增强生成(RAG)是解决大模型幻觉和知识滞后问题的关键。
- 向量存储选型:Milvus、Chroma、FAISS等工具可根据数据规模选择,对于亿级向量,分布式向量数据库是必然选择。
- 检索策略优化:结合关键词检索(BM25)与语义检索,提高召回准确率,引入重排序(Rerank)模型,进一步过滤无关信息。
企业级大模型落地实操指南
从理论到实践,架设过程需要严谨的工程化思维,以下是关键步骤。
第一步:需求评估与场景定义
不要为了技术而技术,明确业务痛点,是提升效率、降低成本,还是创新产品?
- 场景细分:将业务拆解为具体任务,如文档摘要、代码辅助、智能问答等,不同任务对模型能力要求不同。
- 性能指标设定:定义响应时间、准确率、并发量等KPI,作为后续技术选型的依据。
第二步:数据准备与清洗
数据质量决定模型上限。
- 数据清洗:去除噪声、重复内容和错误标注,使用正则表达式、规则引擎进行初步清洗。
- 格式标准化:将多源数据统一转换为JSON、Markdown等结构化格式,便于模型训练和推理。
- 隐私脱敏:在数据入库前,使用NLP工具识别并替换敏感信息,如姓名、电话、身份证号。
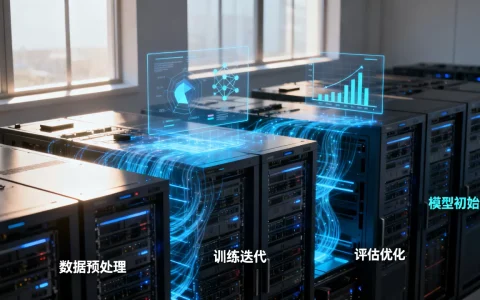
第三步:模型微调与评估
全量微调成本高昂,参数高效微调(PEFT)如LoRA成为主流。
- 微调流程:准备指令数据集 -> 配置LoRA参数 -> 训练 -> 验证 -> 部署。
- 评估体系:建立自动化评估流水线,使用BLEU、ROUGE等指标结合人工评审,确保模型输出符合业务标准。
第四步:监控与迭代
模型上线不是终点,而是起点。
- 日志记录:记录每次请求的输入、输出、耗时、Token消耗,便于问题追踪和成本分析。
- 反馈机制:建立用户反馈通道,收集Bad Case,定期重新训练模型,形成闭环优化。
常见误区与避坑指南
在架设过程中,企业容易陷入一些认知误区,导致资源浪费或项目失败。
参数越大越好
大参数模型在通用任务上表现优异,但在垂直领域,经过微调的小模型往往更精准、更快速、更便宜,不要迷信参数规模,而要关注任务适配度。
忽视算力基础设施
模型架构再完美,如果底层算力不足,也会体验极差,确保GPU显存充足、带宽足够,并预留弹性扩容空间。
一次性投入,长期不管
大模型技术迭代极快,今天的最佳实践,明天可能过时,建立持续集成/持续部署(CI/CD)流程,保持技术栈的更新。
2026年大模型架设价格与ROI分析
成本是决策的核心因素,不同部署方式的成本结构差异巨大。
| 部署方式 | 初期投入 | 运营成本 | 数据安全性 | 灵活性 | 适用场景 |
|---|---|---|---|---|---|
| 公有云API | 极低 | 高(按量计费) | 中 | 高 | 初创公司、非敏感业务 |
| 私有化部署 | 高(硬件+人力) | 中(电费+维护) | 高 | 中 | 大型企业、敏感数据行业 |
| 混合云架构 | 中高 | 中 | 高 | 高 | 大多数成熟企业 |
据工信部数据,近年来企业在AI基础设施上的投入占比逐年上升,但通过优化架构,单位推理成本下降了近半数,对于大多数企业,混合云架构是性价比最高的选择。
如何降低长期运营成本
- 模型量化:将FP16模型量化为INT8或INT4,显存占用减半,推理速度提升,精度损失极小。
- 缓存机制:对高频重复查询结果进行缓存,减少重复推理。
- 闲时训练:利用夜间低峰期进行模型微调或数据预处理,避免占用白天业务算力。
Q&A:关于AI大模型架设的常见问题
AI大模型架设需要多少预算?
预算取决于规模和需求,小规模测试可使用单张消费级显卡,成本几千元;企业级生产环境通常需要集群部署,初期硬件投入在数十万至数百万不等,还需考虑运维人力成本,建议从最小可行产品(MVP)开始,逐步扩展。
自建大模型与使用第三方服务相比,优势在哪里?
自建大模型的核心优势在于数据主权和定制化能力,企业可以将专有数据完全保留在内部,避免泄露风险;可以根据业务逻辑深度微调模型,获得更精准、更符合行业术语的输出结果。
大模型架设后如何保证回答的准确性?
准确性通过RAG架构和持续微调来保证,RAG将模型检索到的外部知识与生成能力结合,减少幻觉;持续微调则让模型熟悉特定领域的知识和表达方式,引入人工审核机制和反馈循环,也是提升准确性的关键手段。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/388683.html

评论列表(1条)
“2026年”?博主是穿越回来的吗?现在大模型私有化部署成本高得离谱,中小企业哪玩得起这套“边缘推理”啊,别画饼了😂