


AI跑大模型的核心在于算力资源的高效调度与显存优化,通过量化压缩、模型并行及云端弹性实例,普通用户也能以极低成本实现高性能推理。
为什么你的本地显卡跑不动大模型?
很多人刚接触AI时,兴致勃勃地下载了Llama 3或Qwen 2.5,结果发现电脑风扇狂转,画面却卡成PPT,这并非设备故障,而是对大模型运行机制存在误解,大模型本质上是巨大的参数矩阵,每一次生成回复,都需要将海量数据在GPU显存中进行矩阵乘法运算。
业内专家指出,显存容量是决定能否加载模型的硬门槛,而显存带宽则决定了生成速度,如果你使用的是8GB显存的入门级显卡,连一个70亿参数(7B)的模型都难以完整加载,更别提流畅推理了。
显存焦虑的真相
要理解显存占用,必须拆解模型加载的两个阶段:加载阶段与推理阶段。
- 加载阶段:模型权重文件从硬盘读取到显存,FP16(半精度)格式的7B模型约占14GB显存;INT8(8位量化)格式约占7-8GB;INT4(4位量化)格式仅需4GB左右。
- 推理阶段:除了模型权重,还需要预留空间给KV Cache(键值缓存),上下文越长,KV Cache占用越大,如果你开启长对话,显存占用会迅速飙升。
常见配置与模型匹配表
| 显卡显存 | 推荐模型类型 | 量化格式建议 | 预期体验 |
|---|---|---|---|
| 4GB – 6GB | 1B – 3B 小模型 | INT4 | 流畅,适合简单问答 |
| 8GB – 12GB | 7B – 8B 中等模型 | INT4 / Q4_K_M | 基本流畅,长文本需截断 |
| 16GB – 24GB | 13B – 14B 较大模型 | INT4 / Q5_K_M | 流畅,支持中等上下文 |
| 24GB+ | 30B+ 大型模型 | INT4 / 多卡并行 | 需专业优化,体验接近云端 |
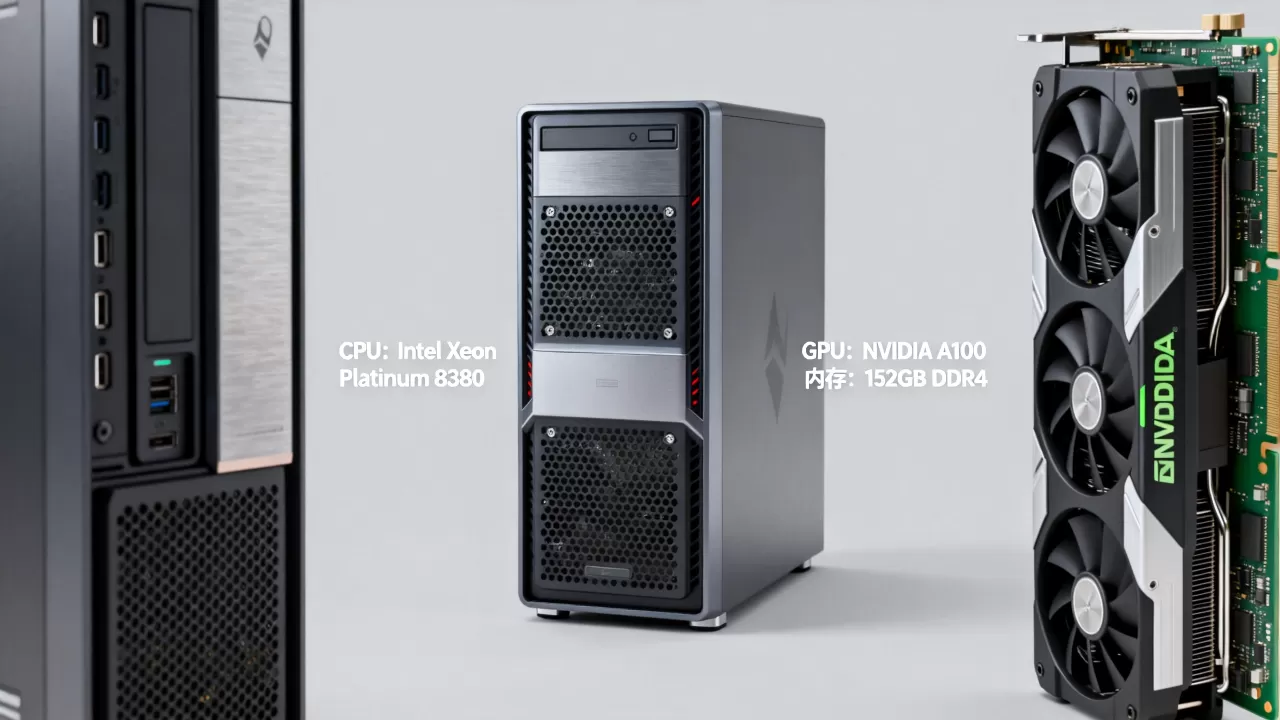
本地部署 vs 云端API:哪种方案更划算?
对于大多数非技术背景的用户,”本地部署”往往是个伪需求,除非你有特定的数据隐私要求,或者需要24小时不间断运行私有助手,否则云端服务在性价比上具有压倒性优势。
成本对比分析
让我们算一笔账,假设你拥有一张RTX 4090显卡,购入成本约1.5万元,这笔钱如果用于购买云端API调用额度,在同等算力下,可以支撑数百万次的token生成。
- 本地部署隐性成本:电费、硬件折旧、散热噪音、时间成本(调试环境、解决报错)。
- 云端API成本:按量付费,无闲置浪费,目前主流大模型API价格已大幅下降,部分开源模型甚至提供完全免费的推理接口。
何时选择本地部署?
- 数据极度敏感:涉及医疗、金融核心数据,严禁上传至公网。
- 离线环境需求:在断网或网络受限的工业现场使用。
- 深度定制需求:需要对模型底层进行微调(Fine-tuning)或修改架构。
对于90%的日常应用场景,如文案创作、代码辅助、资料总结,云端API是更优解,你只需关注提示词工程,无需关心底层算力调度。
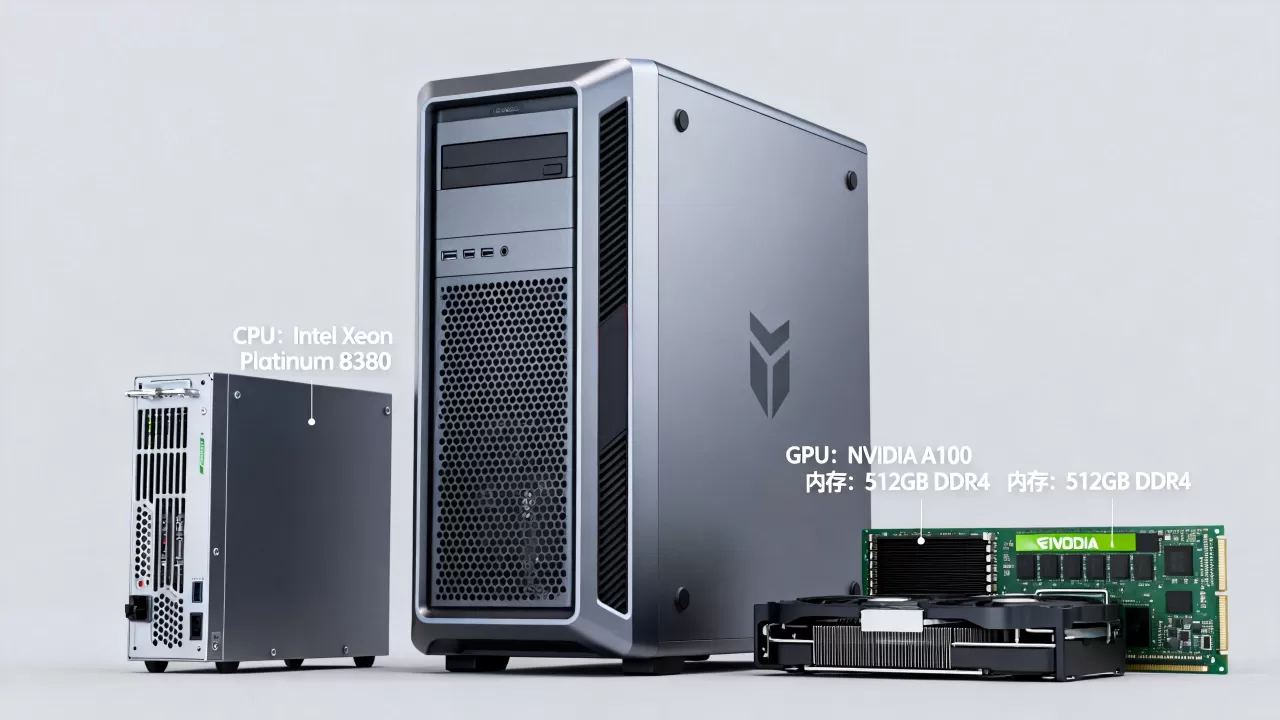
如何以最低成本体验顶级大模型?
如果你仍想尝试本地运行,或者希望优化现有的云端使用体验,以下实操步骤能帮你避开90%的坑。
第一步:选择合适的推理引擎
不要直接从头编译模型,使用成熟的推理框架能节省大量时间。
- Ollama:适合新手,一条命令即可运行,自动处理量化和上下文管理,支持Mac和Linux,Windows支持也在完善中。
- LM Studio:图形化界面友好,适合Windows用户,内置模型库,拖拽即可加载,支持实时查看显存占用。
- vLLM:适合开发者,高吞吐量,支持并发请求,适合搭建私有API服务。
第二步:掌握量化技术
量化是将模型精度降低,从而减少显存占用和计算量的技术,目前主流的量化格式包括:
- GGUF:主要用于CPU和Mac运行,兼容Ollama和LM Studio。
- AWQ / GPTQ:主要用于NVIDIA GPU,精度损失极小,速度提升明显。
实操建议:下载模型时,优先选择Q4_K_M或Q5_K_M量化版本,这是精度与速度的最佳平衡点,除非你的显存非常充裕(24GB+),否则不要尝试加载FP16原始模型。
第三步:优化提示词与上下文
模型跑得快不快,不仅看硬件,还看你怎么用。
-
精简上下文:不要将整本书扔给模型,先让模型总结章节,再基于摘要提问。
-
结构化指令:使用Markdown格式清晰分隔指令、背景知识和输出要求。
# Role
资深文案策划
# Task
根据以下产品特点,撰写一篇小红书种草文案
# Constraints
- 语气活泼,使用emoji
- 字数200字以内
- 包含3个热门标签
2026年AI推理趋势:边缘计算与混合架构
站在2026年的视角回顾,AI推理正在从”云端集中式”向”边缘分布式”演进,手机、PC、甚至智能汽车都在成为推理节点。
端侧大模型的崛起
随着NPU(神经网络处理单元)的普及,端侧运行7B-13B参数模型已成为可能,这意味着你的个人设备将具备离线智能处理能力,无需联网即可处理敏感信息。
混合推理架构
未来主流架构将是”端云协同”:
- 端侧:处理简单、高频、隐私性强的任务(如语音转文字、即时翻译)。
- 云端:处理复杂逻辑、长上下文、高创意性任务。
这种架构既保证了响应速度,又保留了模型的强大能力,据工信部数据显示,端侧AI设备的出货量在过去三年中增长了近四倍,标志着个人智能终端的正式到来。
常见问题解答
AI跑大模型需要多高的配置?
配置需求取决于模型规模和量化方式,对于普通用户,推荐至少16GB内存和8GB显存的显卡,可流畅运行7B参数模型的INT4量化版本,若使用Mac M系列芯片,16GB统一内存即可胜任同等任务,因为其内存带宽远高于传统显卡。
云端API和本地部署哪个更安全?
本地部署在物理层面更安全,数据不出本地,云端API的安全性取决于服务商的合规认证,选择通过ISO 27001认证、支持私有化部署或提供VPC隔离服务的云厂商,其安全性足以满足绝大多数商业需求,对于极高敏感数据,必须选择本地部署。
为什么我的模型生成速度很慢?
速度慢通常由三个原因导致:一是显存不足导致频繁交换数据;二是上下文过长导致KV Cache过大;三是网络延迟(云端调用),优化路径包括:降低量化精度、截断历史对话、使用vLLM等高性能推理引擎,或切换至延迟更低的区域节点。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/390772.html

评论列表(1条)
一般不评论但这次忍不住…… article里说“普通用户也能以极低成本跑大模型”,笑死,我3060 12G卡跑Qwen-