大模型全参数微调的显存需求主要取决于模型参数量、批次大小(Batch Size)以及使用的优化技术,通常每10亿参数需要约20GB-40GB显存,具体数值需结合训练精度和硬件配置综合测算。
在2026年的算力环境下,许多开发者仍对全参数微调(Full Fine-Tuning, FFT)的硬件门槛感到困惑,很多人误以为微调只是“换个头”,实际上它需要加载模型权重、梯度、优化器状态以及激活值,这构成了巨大的显存黑洞,理解这一需求并非为了炫技,而是为了在有限的预算下,选择最合适的训练方案,避免在训练中途因OOM(显存溢出)而崩溃。
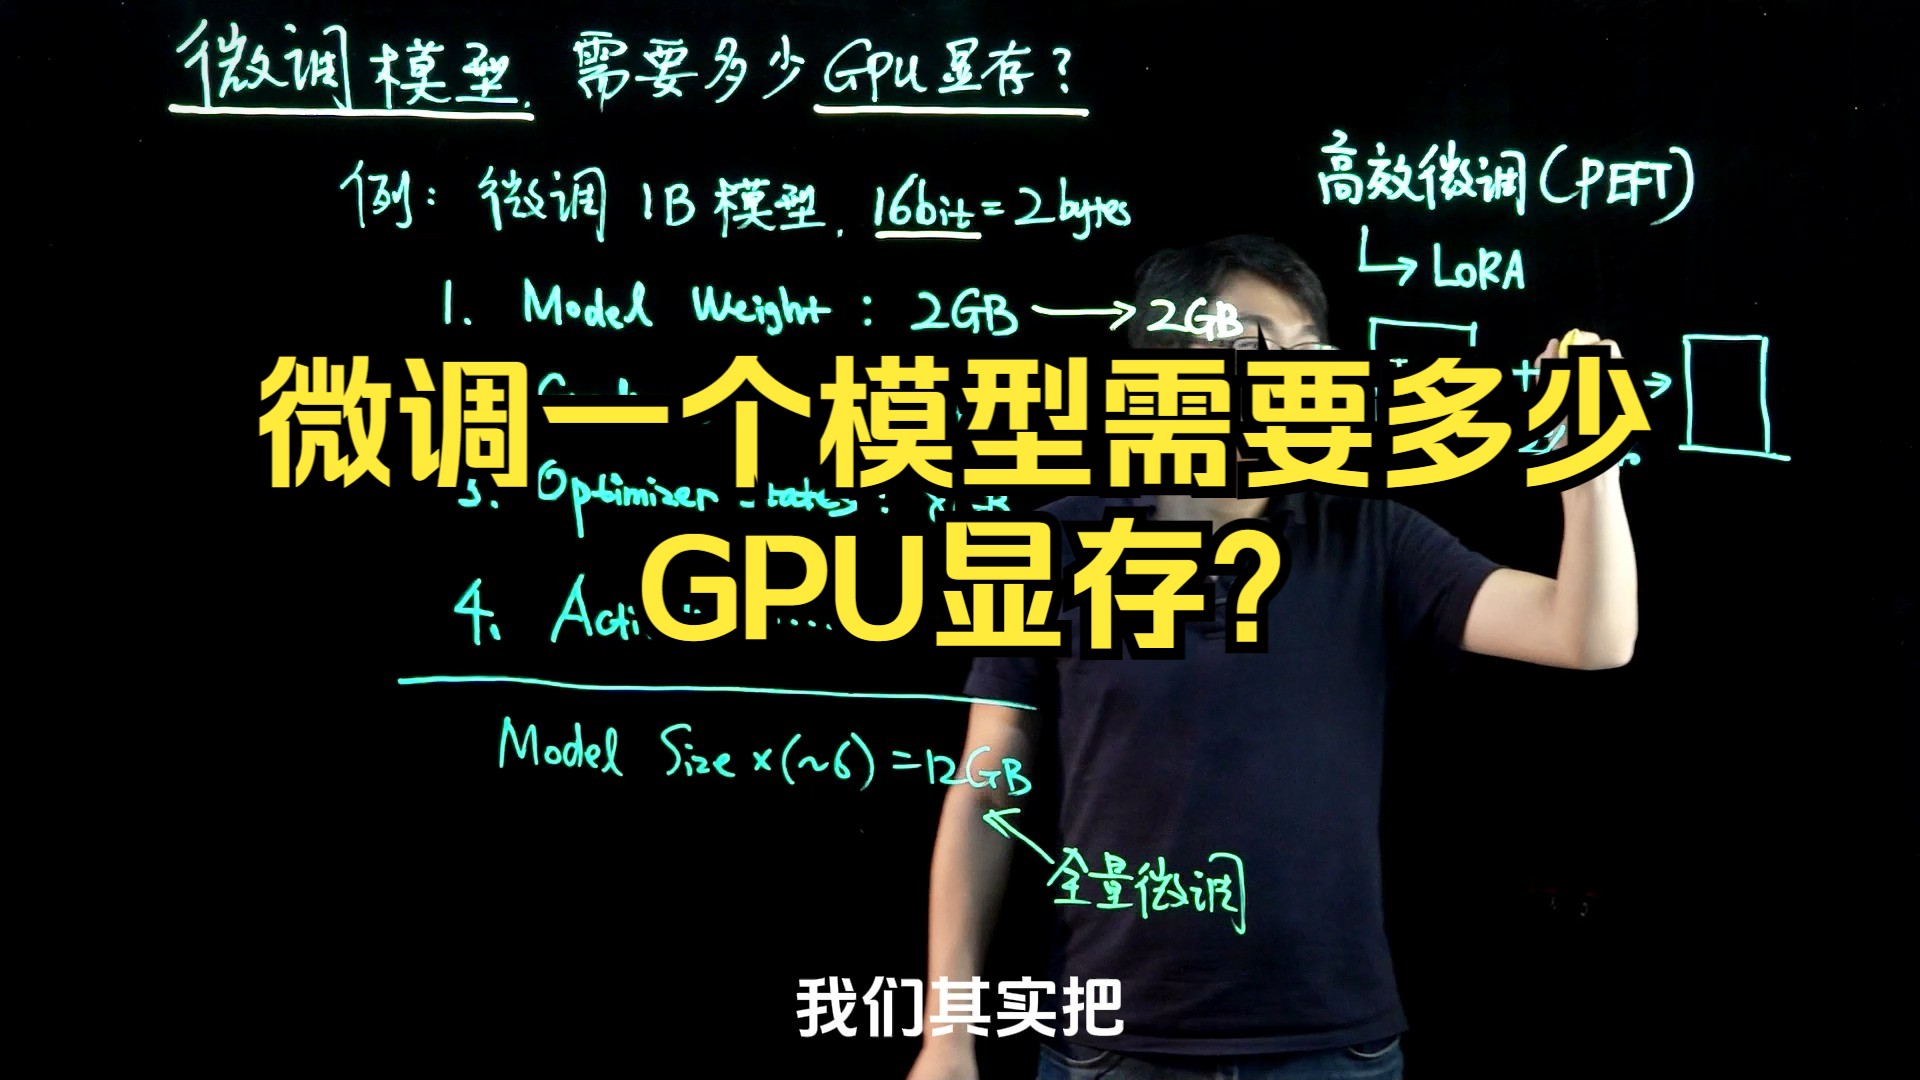

全参数微调显存构成的底层逻辑
要准确估算显存,必须拆解其四大核心组成部分,业内专家指出,显存消耗并非线性增长,而是由多个模块共同决定的复杂函数。
模型权重与梯度
这是显存占用的大头,全参数微调意味着所有参数都需要更新。
- 模型权重:如果模型是FP16(半精度)格式,权重占用空间是参数量乘以2字节。
- 梯度:反向传播时需要存储与权重同样大小的梯度数据。
这意味着,仅权重和梯度就需要占用参数量4倍的空间。
优化器状态
这是最容易被忽视的“隐形杀手”,以常用的AdamW优化器为例,它需要维护每个参数的动量(一阶矩)和方差(二阶矩)。
- 动量与方差:每个参数需要存储两个FP32(全精度)的浮点数。
- 计算结果:优化器状态通常需要占用参数量8倍的空间。
对于一个大模型,优化器状态往往比模型本身还要大。
激活值与临时缓冲区
前向传播过程中产生的中间结果(激活值)需要保存,以便反向传播计算梯度。
- 序列长度影响:激活值与输入序列长度成正比,长文本训练会显著增加这部分显存压力。
- 批次大小影响

:Batch Size越大,同时处理的样本越多,激活值占用呈线性增长。

显存碎片与系统开销
CUDA上下文、PyTorch框架本身的开销以及显存碎片化,通常还会额外占用5%-10%的显存空间,这部分虽然不直接参与计算,但在规划时必须预留。
不同参数量模型的显存需求对比
为了更直观地理解,我们可以对比不同规模模型在典型配置下的显存需求,以下数据基于FP16精度、梯度累积步数为1、无特殊优化技术的基础场景。
| 模型参数量 | 模型+梯度 (GB) | 优化器状态 (GB) | 基础总需求 (GB) | 推荐显卡配置 |
|---|---|---|---|---|
| 7B | ~56 | ~112 | ~168 | 4x A100 80GB 或 8x RTX 4090 |
| 13B | ~104 | ~208 | ~312 | 8x A100 80GB |
| 70B | ~560 | ~1120 | ~1680 | 16x+ A100 80GB 集群 |
注:以上数据未包含激活值和系统开销,实际训练时需额外预留30%-50%空间。
从表中可以看出,7B模型在单卡上几乎无法进行全参数微调,必须依赖多卡并行,而70B及以上的大模型,单卡甚至单节点都无法承载,必须使用分布式训练。
批次大小对显存的线性影响
批次大小(Batch Size)是调整显存压力的关键杠杆。
- 小批次:显存占用低,但可能导致梯度噪声大,收敛慢。
-
大批次:显存占用高,但训练更稳定,适合大模型。
在实际操作中,如果显存不足,首先尝试减小Batch Size,其次考虑梯度累积。

降低显存需求的实战优化方案
面对高昂的显存成本,直接全参数微调往往不经济,行业共识认为,通过技术手段降低显存需求是主流选择。
混合精度训练
使用BF16或FP16进行前向和反向传播,同时使用FP32存储优化器状态。
- 优势:相比纯FP32,显存占用减半。
- 操作:在PyTorch中使用
torch.cuda.amp自动混合精度训练。
梯度检查点(Gradient Checkpointing)
这是一种以时间换空间的策略。
- 原理:不保存所有激活值,而是在反向传播时重新计算部分前向传播结果。
- 效果:可将激活值显存占用降低50%-70%,但会增加约20%-30%的训练时间。
对于显存紧张的场景,这是必选项。
分布式数据并行(DDP)与ZeRO
当单卡显存不足时,分布式训练是必经之路。
- DDP:将数据分片到多卡,每卡存储完整模型副本,显存需求随卡数线性增加,通信开销大。
- ZeRO(Zero Redundancy Optimizer):由DeepSpeed提出,将模型权重、梯度和优化器状态分片存储在不同卡上。
- ZeRO-2:优化器状态分片,显存需求降低4倍。
- ZeRO-3:权重、梯度、优化器均分片,显存需求降低N倍(N为卡数)。
对于70B以上模型,ZeRO-3是标配。
LoRA与QLoRA的替代方案
如果全参数微调显存压力过大,可以考虑参数高效微调(PEFT)。
- LoRA:仅训练低秩矩阵,显存占用极低,适合消费级显卡。
- QLoRA:将模型量化为4-bit,进一步降低显存需求,同时保持接近全参数微调的效果。
对于资源有限的团队,QLoRA是性价比最高的选择。

2026年主流硬件配置建议
根据当前的硬件市场和技术趋势,以下是针对不同场景的硬件配置建议。
入门级:个人开发者与小型团队
- 推荐配置:2x RTX 4090 (24GB) 或 1x A6000 (48GB)。
- 适用场景:7B-13B模型的LoRA微调,或7B模型的全参数微调(需ZeRO-2)。
- 成本:相对较低,适合快速原型验证。
进阶级:中型企业与研究机构
- 推荐配置:4x-8x A100 80GB 或 H100 80GB。
- 适用场景:13B-70B模型的全参数微调,使用ZeRO-2或ZeRO-3。
- 成本:较高,但训练效率高,适合生产环境。
企业级:大型科技公司
- 推荐配置:16x+ H100 80GB 集群,配备高速互联(InfiniBand)。
- 适用场景:70B+模型的全参数微调,大规模预训练或指令微调。
- 成本:极高,需专业运维团队支持。
常见问题解答
大模型全参数微调显存需求如何快速估算?
可以使用经验公式:显存需求 ≈ 参数量 × 4字节(权重) + 参数量 × 4字节(梯度) + 参数量 × 8字节(优化器状态) + 激活值开销,对于7B模型,基础需求约160GB,加上激活值和碎片,建议预留200GB以上显存。
全参数微调与LoRA微调显存差距有多大?
全参数微调需要加载所有参数及其状态,显存占用极大,LoRA仅训练少量低秩矩阵,显存占用仅为全参数微调的10%-20%,7B模型全参数微调可能需要4张A100 80GB,而LoRA可能只需1张RTX 4090。
显存不足时除了减小批次大小还能做什么?
除了减小批次大小,还可以启用梯度检查点以牺牲时间换取空间,使用ZeRO-3将模型分片到多卡,或切换至QLoRA等量化微调方案,这些方法能有效缓解显存压力,确保训练顺利进行。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394379.html