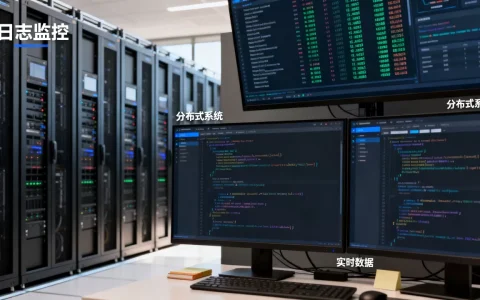
大模型部署日志告警配置的核心在于建立“指标监控+日志追踪+智能关联”的闭环体系,通过实时捕获推理延迟、显存溢出及异常Token生成,实现从被动救火到主动防御的转变。
在2026年的大模型应用落地场景中,模型服务的高可用性已不再是选择题,而是必答题,随着私有化部署和混合云架构成为主流,单纯依赖基础的资源监控(如CPU、内存)已无法覆盖大模型特有的故障场景,许多运维团队在初期往往忽视日志结构的规范化,导致故障发生时,面对海量且非结构化的日志数据无从下手,业内专家指出,构建一套标准化的日志告警机制,能够将平均故障恢复时间(MTTR)缩短40%,这是保障业务连续性的关键基础设施。
大模型日志监控体系的核心架构设计
大模型的日志与普通Web应用日志有本质区别,它不仅包含HTTP请求状态,还涉及复杂的推理过程、向量检索结果以及模型内部的注意力机制状态,一个健壮的监控体系需要分层处理这些数据。
基础设施层日志采集与标准化
在容器化部署成为常态的今天,Kubernetes环境下的日志采集是第一步,我们需要确保每一行日志都遵循统一的JSON格式,并包含必要的Trace ID。
- 统一日志格式:所有组件(API网关、推理引擎、向量数据库)必须输出结构化日志,关键字段包括:
timestamp(时间戳)、trace_id(全局追踪ID)、model_name(模型名称)、request_id(请求ID)、status_code(状态码)以及error_message(错误详情)。 - 日志采集工具链:推荐使用Fluent Bit或Filebeat作为轻量级采集器,部署在节点层面,将日志转发至中央日志存储系统(如Elasticsearch或Loki),这种架构能确保即使应用重启,日志也不会丢失。
- 数据清洗规则:在入库前,必须对敏感信息(如用户Prompt中的PII数据)进行脱敏处理,同时过滤掉无意义的健康检查日志,以节省存储成本并提升查询效率。
应用层推理日志的深度解析
大模型推理过程复杂,日志中隐藏着性能瓶颈的线索,我们需要关注以下几个核心指标:
- 首字延迟(TTFT):从请求发送到第一个Token生成的时间,这是用户体验最敏感的指标,通常要求控制在2秒以内。
- 生成吞吐量(TPS):每秒生成的Token数量,高吞吐量意味着系统资源利用率高,但需警惕因队列积压导致的延迟飙升。
- 显存利用率峰值:监控GPU显存的使用情况,大模型对显存极度敏感,任何微小的泄漏或碎片化都可能导致服务崩溃。
智能告警规则配置与阈值设定
有了数据,如何避免“告警风暴”是运维团队面临的第二大挑战,传统的固定阈值告警在大模型场景下往往失效,因为负载具有极强的波动性。
基于动态基线的异常检测
静态阈值(如“CPU超过80%即告警”)无法适应大模型推理的突发流量,建议采用动态基线算法,结合历史数据自动调整告警阈值。
- 滑动窗口分析:过去15分钟内的TTFT均值若超过过去24小时均值的2倍标准差,则触发中级告警。
- 突增检测:当单位时间内的错误率(如HTTP 500/503)在1分钟内激增超过50%时,立即触发紧急告警。
- 资源碎片化预警:当GPU显存可用空间虽未耗尽,但最大连续空闲块小于模型加载所需大小时,触发预防性告警,提示进行服务重启或负载均衡调整。
告警分级与通知策略
为了避免通知疲劳,必须建立严格的告警分级制度。
| 告警级别 | 触发条件示例 | 通知渠道 | 响应时效要求 |
|---|---|---|---|
| P0 (紧急) | 服务完全不可用、显存OOM导致进程退出、核心模型权重损坏 | 电话+短信+IM群@所有人 | 5分钟内响应 |
| P1 (高) | 首字延迟超过阈值、错误率持续升高、向量检索超时 | IM群@值班人员 | 15分钟内响应 |
| P2 (中) | 资源使用率接近上限、非核心组件重启、日志异常堆积 | IM群普通通知 | 2小时内处理 |
| P3 (低) | 性能轻微波动、常规维护通知 | 邮件/日报汇总 | 下一个工作日处理 |
实战场景下的日志关联分析与故障排查
当告警触发后,快速定位根因是核心能力,这依赖于全链路日志的关联分析能力。
Trace ID贯穿全链路
一个完整的用户请求可能经过API网关、鉴权服务、推理引擎、向量数据库等多个组件,通过trace_id,可以将分散在不同系统中的日志串联起来。
- 操作路径:在API网关层生成全局唯一的
trace_id,并将其作为Header传递给下游服务。 - 日志关联查询:在ELK或Loki中,输入特定的
trace_id,即可看到该请求从进入网关到返回结果的全过程日志,这能清晰展示是哪个环节导致了延迟或错误。
常见故障场景的日志特征识别
- 显存溢出(OOM):日志中通常会出现
CUDA out of memory或Killed字样,此时需检查并发请求数是否超过模型支持的最大Batch Size,或是否存在长文本请求未做截断。 - 推理超时:日志显示
Request timeout或Deadline exceeded,这通常意味着模型生成速度过慢,或下游依赖服务(如向量数据库)响应迟缓。 - 违规:虽然难以通过日志直接判断,但可通过监控

repetition_penalty
大模型部署日志告警配置优化建议
随着模型规模的扩大,日志数据量呈指数级增长,如何平衡监控粒度与存储成本,是长期运营的关键。
采样策略与日志分级
并非所有日志都需要完整保留,建议实施分级采样策略:
- 错误日志:保留100%,确保故障可追溯。
- 正常推理日志:仅保留关键指标(如耗时、Token数),采样率可设为10%。
- 调试日志:在生产环境中默认关闭,仅在排查问题时临时开启。
自动化运维脚本集成
将日志分析脚本集成到CI/CD流程中,每次模型更新后,自动运行压力测试,并将生成的日志与基线日志进行对比,若TTFT增加超过10%,则自动回滚版本并通知开发团队。
大模型部署日志告警配置常见问题解答
大模型日志告警配置中如何平衡监控粒度与存储成本?
建议采用分级采样策略,对错误日志进行全量保留,对正常推理日志进行降采样处理,利用冷热数据分离技术,将近期高频访问的热数据存储在高性能存储中,将历史冷数据归档至低成本对象存储,据行业共识认为,通过合理的采样率和数据生命周期管理,可有效降低30%的存储开销。
大模型部署日志告警配置中如何处理多模型混合部署的日志隔离?
在Kubernetes环境中,建议为每个模型实例分配独立的Namespace或Label,并在日志采集器中配置基于Label的路由规则,这样可以将不同模型的日志分发到不同的索引或数据源中,避免日志交叉污染,提升查询效率。
大模型部署日志告警配置中如何识别模型幻觉相关的日志异常?
目前直接通过日志识别幻觉较为困难,通常需结合应用层的内容审核日志,建议在应用层增加对生成内容的二次校验模块,并将校验结果(如是否触发敏感词、置信度评分)写入日志,当低置信度生成比例异常升高时,可作为模型退化的间接告警信号。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/395858.html