LM Studio 运行大模型的核心逻辑是本地部署开源模型,通过调用电脑硬件(CPU/GPU)进行推理,无需联网即可实现隐私安全的智能交互。
在2026年的今天,随着大语言模型能力的进一步下沉,本地化运行已成为许多开发者和极客的首选方案,相比依赖云端API,本地运行不仅规避了数据泄露风险,还彻底摆脱了网络延迟和月度订阅费用的束缚,LM Studio 之所以能成为主流选择,是因为它极大地降低了技术门槛,让复杂的模型加载过程变得像安装普通软件一样直观。

LM Studio 怎么运行大模型:核心原理与硬件准备
要理解如何运行,首先要明白它背后的机制,LM Studio 本质上是一个本地推理引擎,它读取经过量化处理的模型文件,并将其加载到内存中,利用你的处理器进行计算。
硬件配置的关键指标
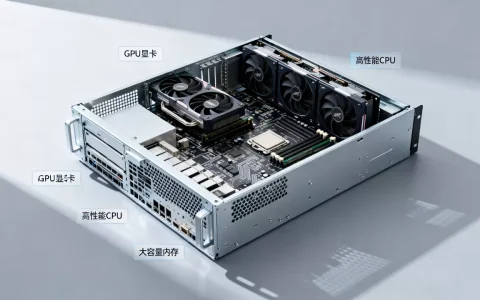
并非所有电脑都能流畅运行大型模型,业内专家指出,显存(VRAM)和内存(RAM)是决定能否加载以及加载多大模型的关键瓶颈。
- GPU(显卡):这是加速推理的核心,NVIDIA 显卡因支持 CUDA 技术,兼容性最好,如果你拥有 RTX 3060 或更高型号,且显存达到 12GB 以上,可以流畅运行 7B 至 13B 参数量的模型,显存越大,能加载的上下文窗口(Context Window)就越长,模型“记忆”的信息就越多。
- RAM(内存):当显存不足时,LM Studio 会自动将部分模型层卸载到系统内存中,这就是所谓的“CPU 推理”,虽然速度比 GPU 慢,但 32GB 或 64GB 的大内存足以让普通 CPU 运行中等规模的模型,对于苹果 M 系列芯片用户,统一内存架构使得内存带宽极高,运行效率甚至可能超过同价位的 PC 显卡。
- 存储空间:模型文件通常以 GGUF 格式存在,一个 7B 模型约 4-5GB,而 70B 模型可能超过 40GB,确保硬盘有充足的 SSD 空间,能显著提升加载速度。

软件环境的初始化
下载并安装 LM Studio 后,首次启动无需复杂配置,软件会自动检测本地硬件资源,并在设置中默认启用 GPU 加速,用户只需确认“CUDA”或“Metal”选项处于开启状态,即可进入模型搜索界面。
LM Studio 运行大模型详细步骤与实操指南
这是许多用户最关心的部分:具体怎么操作?整个过程可以拆解为搜索、下载、加载和交互四个环节。
第一步:精准搜索与模型选择
LM Studio 内置了 Hugging Face 模型库的索引,用户可以直接在搜索栏输入模型名称。
- 搜索技巧:建议搜索“Llama 3”或“Qwen 2.5”等热门开源模型,在结果列表中,优先选择带有“GGUF”标签的文件,这是专为本地推理优化的量化格式。
- 量化等级选择:你会看到 Q4_K_M、Q8_0 等不同后缀,Q4 是 4-bit 量化,体积最小,速度最快,适合显存紧张的设备;Q8 是 8-bit 量化,精度更高,但体积翻倍,对于大多数日常应用,Q4_K_M 是性价比最高的选择,业内共识认为其在智能表现与资源消耗之间取得了最佳平衡。
第二步:下载与加载模型
点击模型卡片右侧的下载箭头,文件将自动保存至本地,下载完成后,点击左侧边栏的“Open File”或“Local Server”图标,选择刚才下载的 .gguf 文件。

- 上下文长度设置:在右侧设置面板中,将“Context Length”调整为 4096 或 8192,这决定了模型能一次性处理多少文字,如果显存充足,可以调至更高,但需注意过高的设置可能导致推理速度下降。
- 系统提示词:在“System Prompt”中预设角色,你是一个专业的Python程序员”,能让模型在后续对话中保持特定风格。
第三步:启动本地服务与 API 调用
LM Studio 的强大之处在于它能将本地模型伪装成一个标准的 OpenAI 兼容服务器。
- 点击顶部的“Start Server”按钮。
- 记下显示的地址,通常是 http://localhost:1234/v1。
- 其他支持 OpenAI API 的工具(如 Chatbox、Dify 或自定义脚本)只需将 API Base URL 指向该地址,即可直接调用本地大模型。
LM Studio 与云端 API 对比及常见误区
选择本地运行还是云端 API,取决于具体场景。
性能与隐私的权衡
| 维度 | LM Studio 本地运行 | 云端 API 服务 |
|---|---|---|
| 数据隐私 | 数据完全留在本地,绝对安全 | 数据需上传至第三方服务器 |
| 运行成本 | 一次性硬件投入,无后续费用 | 按 Token 计费,长期成本高 |
| 响应速度 | 受限于本地硬件,离线可用 | 依赖网络,通常更快且稳定 |
| 模型上限 |
受限于硬件显存/内存 | 可调用千亿参数超大模型 |

常见操作误区
- 认为必须购买顶级显卡。通过量化技术,中端显卡甚至高性能 CPU 也能运行相当一部分模型,关键在于选择合适的量化版本。
- 忽略温度参数(Temperature)。在聊天界面右侧,调整 Temperature 值可以改变模型的创造性,设为 0.2 适合代码生成等逻辑任务,设为 0.8 适合创意写作。
LM Studio 常见问题解答
LM Studio 运行大模型卡顿怎么办?
卡顿通常源于显存溢出或 CPU 负载过高,首先检查任务管理器,确认 GPU 利用率是否饱和,如果显存已满,尝试加载更小参数量的模型(如从 13B 降至 7B),或降低上下文长度,确保在设置中已正确启用 GPU 加速,而非强制使用 CPU,对于苹果 M 系列芯片用户,请确认系统已授予 LM Studio 高性能权限。
LM Studio 支持哪些语言模型?
LM Studio 支持所有基于 Hugging Face 格式的开源模型,包括但不限于 Llama 3、Qwen 2.5、Mistral、Gemma 等,只要模型文件是 .gguf 格式,无论其原始训练数据如何,均可直接加载运行,它不直接支持闭源模型(如 GPT-4),但可以通过 API 网关间接调用。
LM Studio 运行大模型需要付费吗?
LM Studio 软件本身对个人用户免费,核心推理功能无限制,其商业模式主要面向企业级部署和高级功能订阅,对于绝大多数个人开发者,免费版已完全满足本地运行开源大模型的需求,无需额外购买许可证或支付模型使用费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/399091.html