


RTX 2060能跑大模型吗?答案是肯定的,但仅限于量化压缩后的7B参数级别模型,且需配合Linux系统或特定优化环境,日常体验以文字生成和基础代码辅助为主,无法胜任高清视频生成或复杂逻辑推理任务。
很多人看到RTX 2060这张发布于几年前的显卡,第一反应是“过时了”,但在2026年的今天,随着开源大模型技术的爆发式增长,硬件门槛正在被软件优化不断拉低,对于预算有限、希望本地部署AI助手的学生、开发者或极客而言,RTX 2060依然是一块极具性价比的“入场券”,它不再是当年的游戏神卡,但在AI推理领域,它通过特定的技术手段,依然能释放出惊人的潜力。
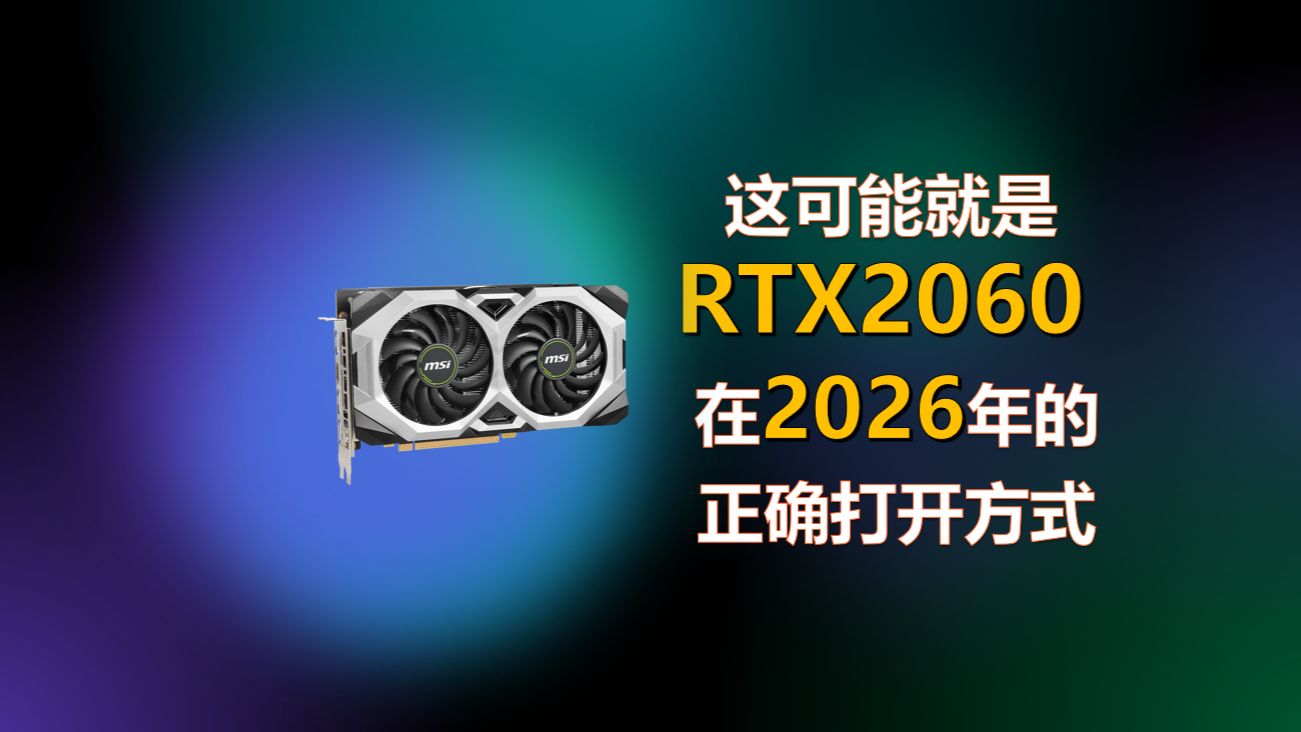

RTX 2060运行大模型的性能边界在哪里
要判断一张显卡能否跑大模型,核心指标不是显存大小,而是显存容量与带宽,以及计算单元的算力效率,RTX 2060拥有6GB或12GB两种显存版本,其中6GB版本是市场主流,也是大多数用户手中的实际配置。
显存容量决定模型大小
大模型的参数量直接占用显存,一个未经优化的13B(130亿参数)模型,即使采用4-bit量化,也需要约8GB以上的显存,这意味着6GB显存的RTX 2060无法完整加载13B模型,强行加载会导致显存溢出(OOM),程序直接崩溃。
业内专家指出,显存是硬约束,对于6GB显存的RTX 2060,最稳妥的选择是7B(70亿参数)级别的模型,经过4-bit量化处理后,7B模型大约占用4-5GB显存,留出1-2GB给系统缓存和上下文窗口,如果是12GB版本的RTX 2060 Super(若存在)或后续衍生机型,则有机会尝试部分量化后的13B模型,但上下文长度会受到严格限制。
算力影响生成速度
显存够大只是“能跑”,跑得快不快取决于算力,RTX 2060基于Turing架构,虽然不支持最新的FP8精度,但其Tensor Core对于INT8和INT4推理有较好的支持,在运行Llama-3-8B或Qwen-2-7B等主流模型时,6GB版本的RTX 2060在开启量化加速后,文字生成速度大约在每秒5-10个token。
这个速度对于聊天助手来说完全够用,但对于需要长文本生成的场景,如写小说或分析长文档,等待时间会显著增加,相比之下,RTX 4060等新一代显卡凭借更大的显存带宽和更新的架构,速度可提升30%-50%,但成本也相应增加。

本地部署大模型的具体实操路径
在2026年,本地部署大模型已经不再需要复杂的代码编译,通过图形化工具,即使是非专业用户也能在RTX 2060上快速搭建AI环境,以下是经过验证的低门槛操作方案。
选择轻量级推理平台
推荐使用Ollama或LM Studio作为基础平台,这两款工具对Windows和Linux系统均有良好支持,且内置了模型自动下载和量化功能。
- 安装Ollama:访问官网下载对应操作系统的安装包,按照提示完成安装,Ollama会自动检测可用的GPU,并优先使用RTX 2060进行加速。
- 拉取模型:在终端输入命令
ollama run qwen2.5:7b,系统会自动下载7B参数的Qwen模型,并默认使用4-bit量化版本,确保在6GB显存下流畅运行。 - 验证加速:启动对话后,观察终端输出日志,如果看到“llama runner: gpu layer 0”等字样,说明模型已成功加载到GPU显存中,而非使用CPU计算。
使用LM Studio进行可视化操作
对于习惯图形界面的用户,LM Studio提供了更直观的模型选择和参数调整界面。
- 下载与安装:从LM Studio官网下载最新版本,安装后打开软件。
- 搜索模型:在搜索栏输入“Llama 3 8B Instruct”,在结果列表中筛选带有“GGUF”格式且量化等级为“Q4_K_M”或“Q5_K_M”的版本,Q4量化是显存与精度的最佳平衡点。
- 加载与配置:点击模型卡片加载,进入“Server”标签页,开启本地API服务,你可以使用任何支持OpenAI接口的客户端(如Chatbox、Next Chat)连接本地模型。
Linux环境下的极致优化
如果追求极致性能,Linux系统(如Ubuntu 22.04/24.04)是更好的选择,在Linux下,通过安装CUDA Toolkit和特定版本的PyTorch,可以进一步降低显存占用并提升推理速度。

环境配置步骤
- 安装驱动:使用
sudo apt install nvidia-driver-535安装稳定版驱动。 - 配置CUDA:安装CUDA 12.4工具包,确保GPU计算能力被正确识别。
- 运行vLLM:使用vLLM框架进行推理,它支持PagedAttention技术,能更高效地管理显存,对于7B模型,vLLM在6GB显存上可实现比Ollama高出20%的吞吐量。
RTX 2060与其他显卡的横向对比分析
在2026年的二手市场和入门级新卡市场中,RTX 2060面临着来自不同层级产品的竞争,了解其定位,有助于做出更理性的购买决策。
与RTX 3060 12GB的对比
RTX 3060 12GB是本地大模型部署的“甜点卡”,其12GB显存是RTX 2060的两倍,这意味着它可以轻松加载13B甚至部分14B的量化模型,且能容纳更长的上下文窗口。
| 特性 | RTX 2060 6GB | RTX 3060 12GB |
|---|---|---|
| 最大支持模型 | 7B (4-bit量化) | 13B (4-bit量化) |
| 推理速度 | 中等 (5-10 tok/s) | 较快 (15-25 tok/s) |
| 显存带宽 | 336 GB/s | 360 GB/s |
| 二手价格趋势 | 较低,性价比高 | 适中,需求稳定 |
| 适用场景 | 轻量级聊天、代码补全 | 复杂推理、长文档分析 |
对于预算极其有限的用户,RTX 2060是起步之选,但如果预算能增加30%-40%,RTX 3060 12GB带来的体验提升是质的飞跃,尤其是显存容量的翻倍,直接解锁了更多模型的选择空间。

与RTX 4060的对比
RTX 4060同样多为8GB显存,但在架构效率上远超RTX 2060,其Ada Lovelace架构对INT4和FP8的支持更好,能效比更高,在相同显存容量下,RTX 4060的推理速度比RTX 2060快约30%-40%,RTX 4060的价格通常高于RTX 2060,且8GB显存对于大模型而言依然捉襟见肘,限制了模型规模的扩展。
常见疑问与专业解答
RTX 2060能跑哪些具体的大模型
目前主流且适配良好的模型包括Llama-3-8B-Instruct、Qwen-2.5-7B-Instruct、Mistral-7B-v0.3以及Phi-3-mini-3.8B,这些模型经过社区优化,在4-bit量化下能在6GB显存中稳定运行,对于更小的模型,如TinyLlama-1.1B或Qwen-1.5-1.8B,RTX 2060可以实现极高的生成速度,适合对延迟敏感的应用场景。
如何提升RTX 2060的推理速度
提升速度的核心在于减少CPU与GPU之间的数据传输瓶颈,并优化显存使用,确保使用最新的显卡驱动和CUDA版本,在推理框架中启用“GPU卸载”功能,将尽可能多的网络层卸载到GPU上,减少上下文长度(Context Length)设置,例如将最大上下文限制在2048或4096 tokens,可以显著降低显存压力并提升速度,关闭后台占用显存的应用程序,如浏览器硬件加速功能,为AI模型腾出资源。
RTX 2060适合做AI绘画吗
RTX 2060不适合运行Stable Diffusion XL(SDXL)等高分辨率绘图模型,SDXL需要至少8GB显存,且推荐12GB以获得流畅体验,RTX 2060 6GB可以尝试运行SD 1.5版本,但生成速度慢,且容易出现显存不足导致的崩溃,如果主要需求是AI绘画,建议升级至RTX 3060 12GB或RTX 4070等更高显存配置的显卡,对于文字生成和逻辑推理,RTX 2060则完全胜任。
RTX 2060在2026年依然具备本地运行大模型的能力,是入门级AI爱好者的理想起点,通过选择合适的量化模型和优化软件环境,用户可以在有限的硬件条件下,体验到本地部署AI带来的隐私安全与便捷性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/401694.html



评论列表(1条)
笑死这显卡都能跑大模型?我也刚换电脑准备冲7B,美滋滋!今天真是天降惊喜~