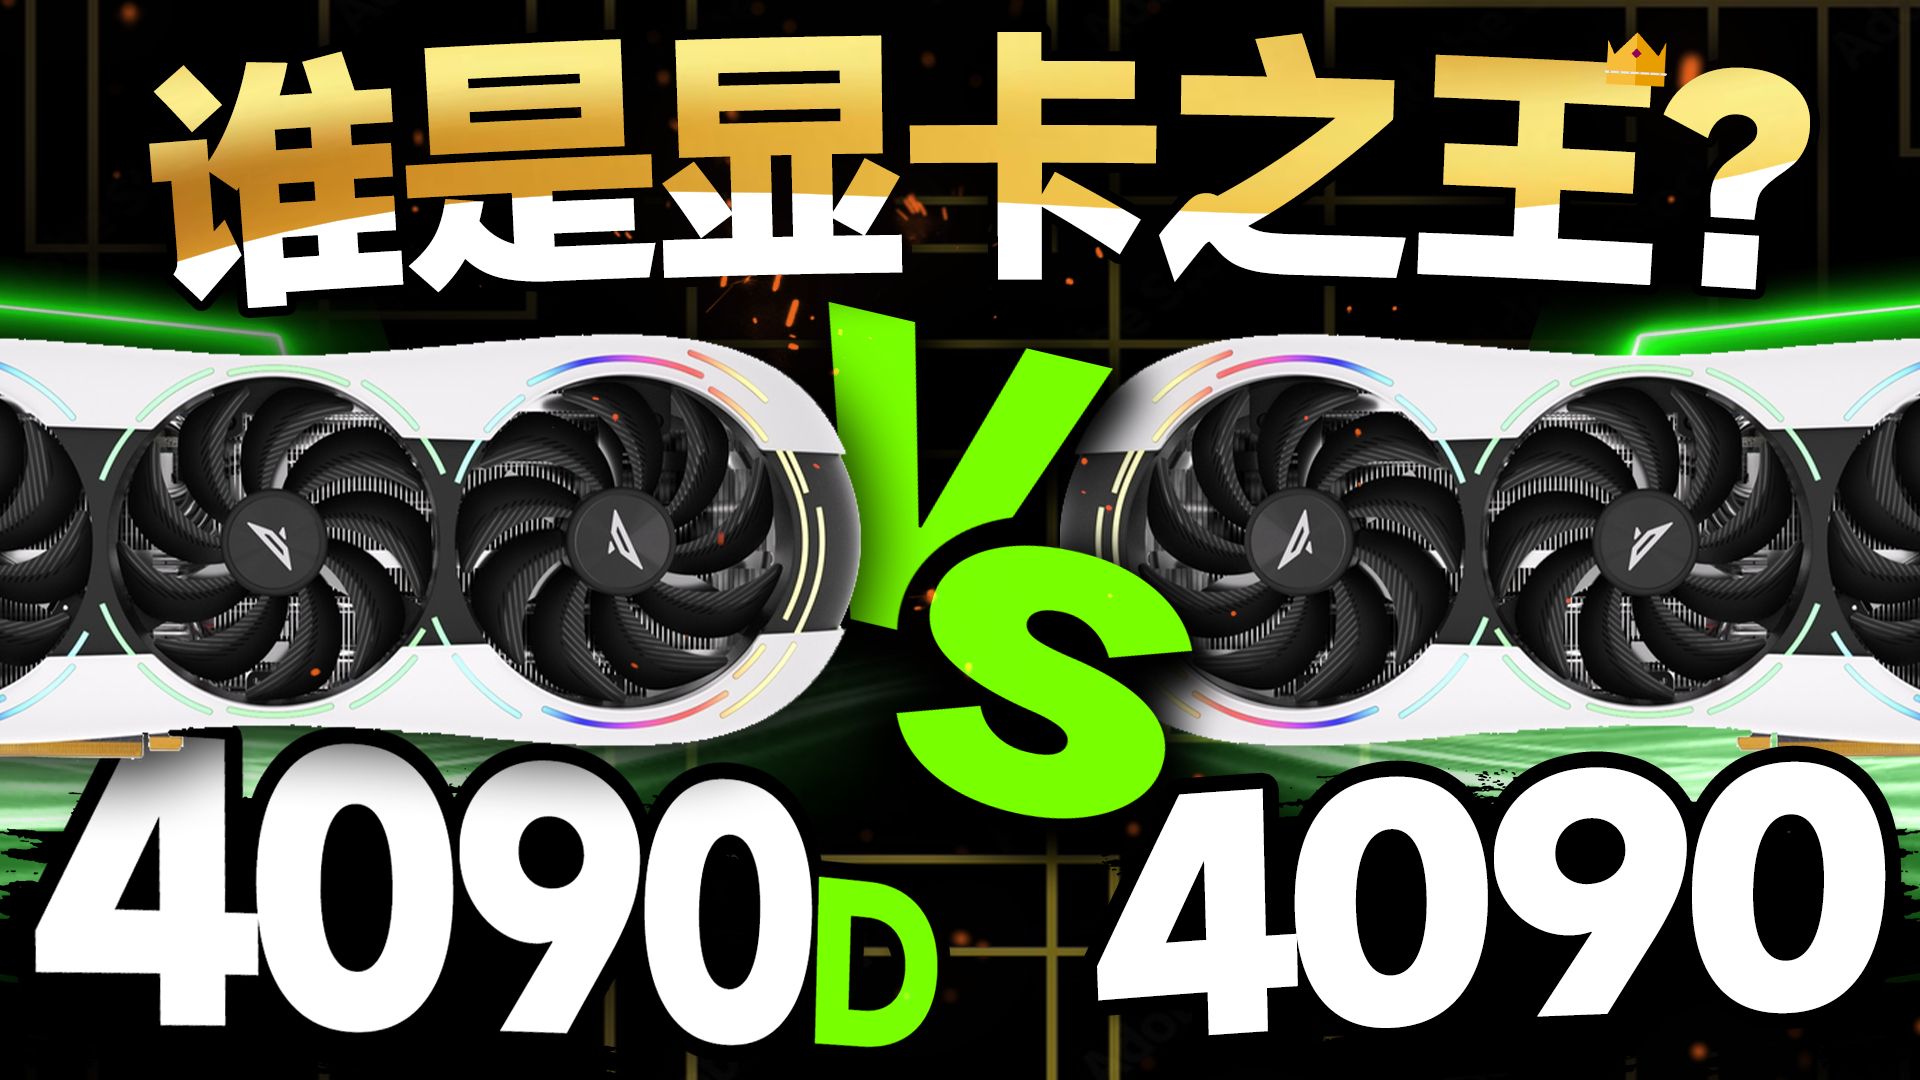
RTX 4090D与RTX 4090在跑大模型时的核心区别在于显存容量与合规性,前者因24GB显存限制在超大参数模型推理时面临瓶颈,而后者虽性能更强但受出口管制影响,国内用户主要依赖4090D进行主流7B至70B参数模型的微调与推理,两者在常规应用场景下体验差异显著减小。
RTX 4090和RTX 4090跑大模型区别:显存决定上限
在深度学习领域,显存(VRAM)是决定模型能否加载以及推理速度的最关键硬件指标,对于大多数国内开发者而言,理解这两款显卡的区别,首先要从显存架构入手。

24GB显存的物理限制
RTX 4090D作为符合中国出口管制规定的特供版,其核心规格与原版RTX 4090保持高度一致,拥有24GB GDDR6X显存,这一容量对于当前主流的大语言模型(LLM)是一个“够用但需精打细算”的门槛。
业内专家指出,显存大小直接决定了你能加载多大的模型权重,在24GB显存的限制下,你可以流畅运行量化后的7B、13B甚至部分70B参数模型(需使用INT4或INT8量化技术),如果你试图加载未经量化的FP16格式70B模型,或者进行全参数微调(Full Fine-tuning),显存会瞬间溢出,导致程序崩溃。
相比之下,原版RTX 4090虽然同样配备24GB显存,但其核心频率略高,理论算力更强,但在实际跑大模型时,算力提升带来的速度增益,往往被显存瓶颈所掩盖,也就是说,如果模型根本装不进显存,再快的核心也无济于事。
多卡并行与显存扩展
当单卡显存不足时,开发者通常会考虑多卡并行,RTX 4090D支持NVLink吗?答案是否定的,NVIDIA在RTX 40系列消费级显卡上彻底移除了NVLink接口,这意味着无论是4090还是4090D,都无法通过高速互联实现显存池化。

在这种情况下,多卡运行大模型主要依赖软件层面的张量并行(Tensor Parallelism)或数据并行(Data Parallelism)。
- 张量并行:将模型层拆分到多张卡上,每张卡持有模型的一部分权重,这需要显存总和大于模型大小,且通信开销较大。
- 数据并行:每张卡持有完整的模型副本,分别处理不同的数据批次,这种方式对显存要求极高,24GB显存通常仅适合小批量数据训练。
对于预算有限且使用24GB显存显卡的用户,优化模型量化等级(如使用GGUF格式的Q4_K_M量化)是提升可用性的最佳实操路径。
RTX 4090D和RTX 4090跑大模型区别:性能损耗与合规性权衡
很多用户关心,为了合规而推出的4090D,是否真的在性能上打了折扣?这种折扣在大模型任务中是否可感知?
算力对比:微乎其微的差距
RTX 4090D的核心CUDA核心数与RTX 4090相同,均为16384个,唯一的区别在于部分核心频率的略微下调,以符合美国商务部的出口规定,根据公开测试数据,4090D的理论浮点运算性能约为原版4090的95%-98%。
在跑大模型的具体场景中,这种差距几乎可以忽略不计。
- 推理速度:在相同模型、相同量化等级下,4090D的Token生成速度仅比4090慢1%-2%,对于人类用户而言,这种差异在感官上难以察觉。
- 训练速度:在进行LoRA微调等轻量级训练任务时,由于瓶颈往往在于显存带宽而非核心算力,两者的训练耗时差异也在1%左右。

价格与获取难度:现实考量
在国内市场,RTX 4090因禁令已处于“有价无市”或“高价黄牛”状态,而RTX 4090D则是唯一能正规渠道购买的高性能显卡。
据统计,4090D的市场价格相对稳定,且享有官方保修服务,对于企业用户或高校实验室而言,采购4090D不仅合规,还能避免法律风险,相比之下,原版4090虽然性能略强,但其高昂的溢价和潜在的售后缺失,使其性价比在大模型应用场景中大打折扣。
行业共识认为,对于绝大多数非超算级别的AI应用,4090D是比原版4090更务实的选择。
RTX 4090D跑大模型实操指南与优化策略
既然选择了RTX 4090D,如何最大化发挥其24GB显存的潜力?以下是经过验证的实操步骤。
模型量化与格式选择
不要盲目加载FP16模型,使用llama.cpp或Ollama等工具,将模型转换为GGUF格式,并选择适当的量化等级。
- Q4_K_M:平衡了速度与精度,适合7B-13B模型,显存占用约8-12GB。
- Q5_K_M:精度更高,适合对回答质量要求较高的场景,显存占用约10-14GB。
- Q8_0:接近FP16精度,但显存占用接近20GB,仅适合极小模型或作为推理极限测试。
推理框架配置
推荐使用vLLM或Text Generation Inference (TGI)作为推理后端,这些框架支持连续批处理(Continuous Batching),能显著提高吞吐量。
在配置时,务必设置合理的

max_num_seqs和gpu_memory_utilization参数,建议将GPU显存利用率设置为0.9,预留10%给系统开销和KV Cache,避免OOM(显存溢出)错误。
LoRA微调实战
对于希望定制模型的用户,LoRA微调是4090D的强项。
- 准备数据:将数据整理为JSONL格式,包含输入和输出字段。
- 选择基座模型:推荐使用Qwen2.5-7B或Llama-3.1-8B等开源模型。
- 配置参数:在LLaMA-Factory或Unsloth框架中,设置r=16, alpha=32, dropout=0.05。
- 启动训练:使用batch_size=4, gradient_accumulation_steps=4,确保显存占用在20GB以内。
通过这种方式,你可以在24GB显存上完成对主流模型的领域适配,无需全参数微调。
常见疑问解答
RTX 4090D和RTX 4090跑大模型区别是否影响推理速度?
在相同模型和量化等级下,RTX 4090D的推理速度仅比RTX 4090慢1%-2%,这种差异在实际应用中几乎不可感知,用户无需担心性能瓶颈。
RTX 4090D能否运行70B参数大模型?
可以,但必须使用INT4或INT8量化版本,未经量化的70B模型需要超过140GB显存,单张24GB显卡无法加载,通过量化技术,70B模型可压缩至30-40GB显存,单卡仍显不足,需双卡并行或更高规格显卡。
RTX 4090D适合进行大规模预训练吗?
不适合,RTX 4090D的24GB显存和缺乏NVLink支持,使其无法胜任大规模预训练任务,它仅适合小规模微调、推理及实验性研究,大规模预训练需依赖A100/H100等专业数据中心GPU集群。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/401886.html