大模型KV Cache优化的核心在于通过量化压缩、稀疏化剪枝及共享机制,在显存带宽与计算精度之间寻找平衡,从而显著降低推理延迟并提升吞吐量。
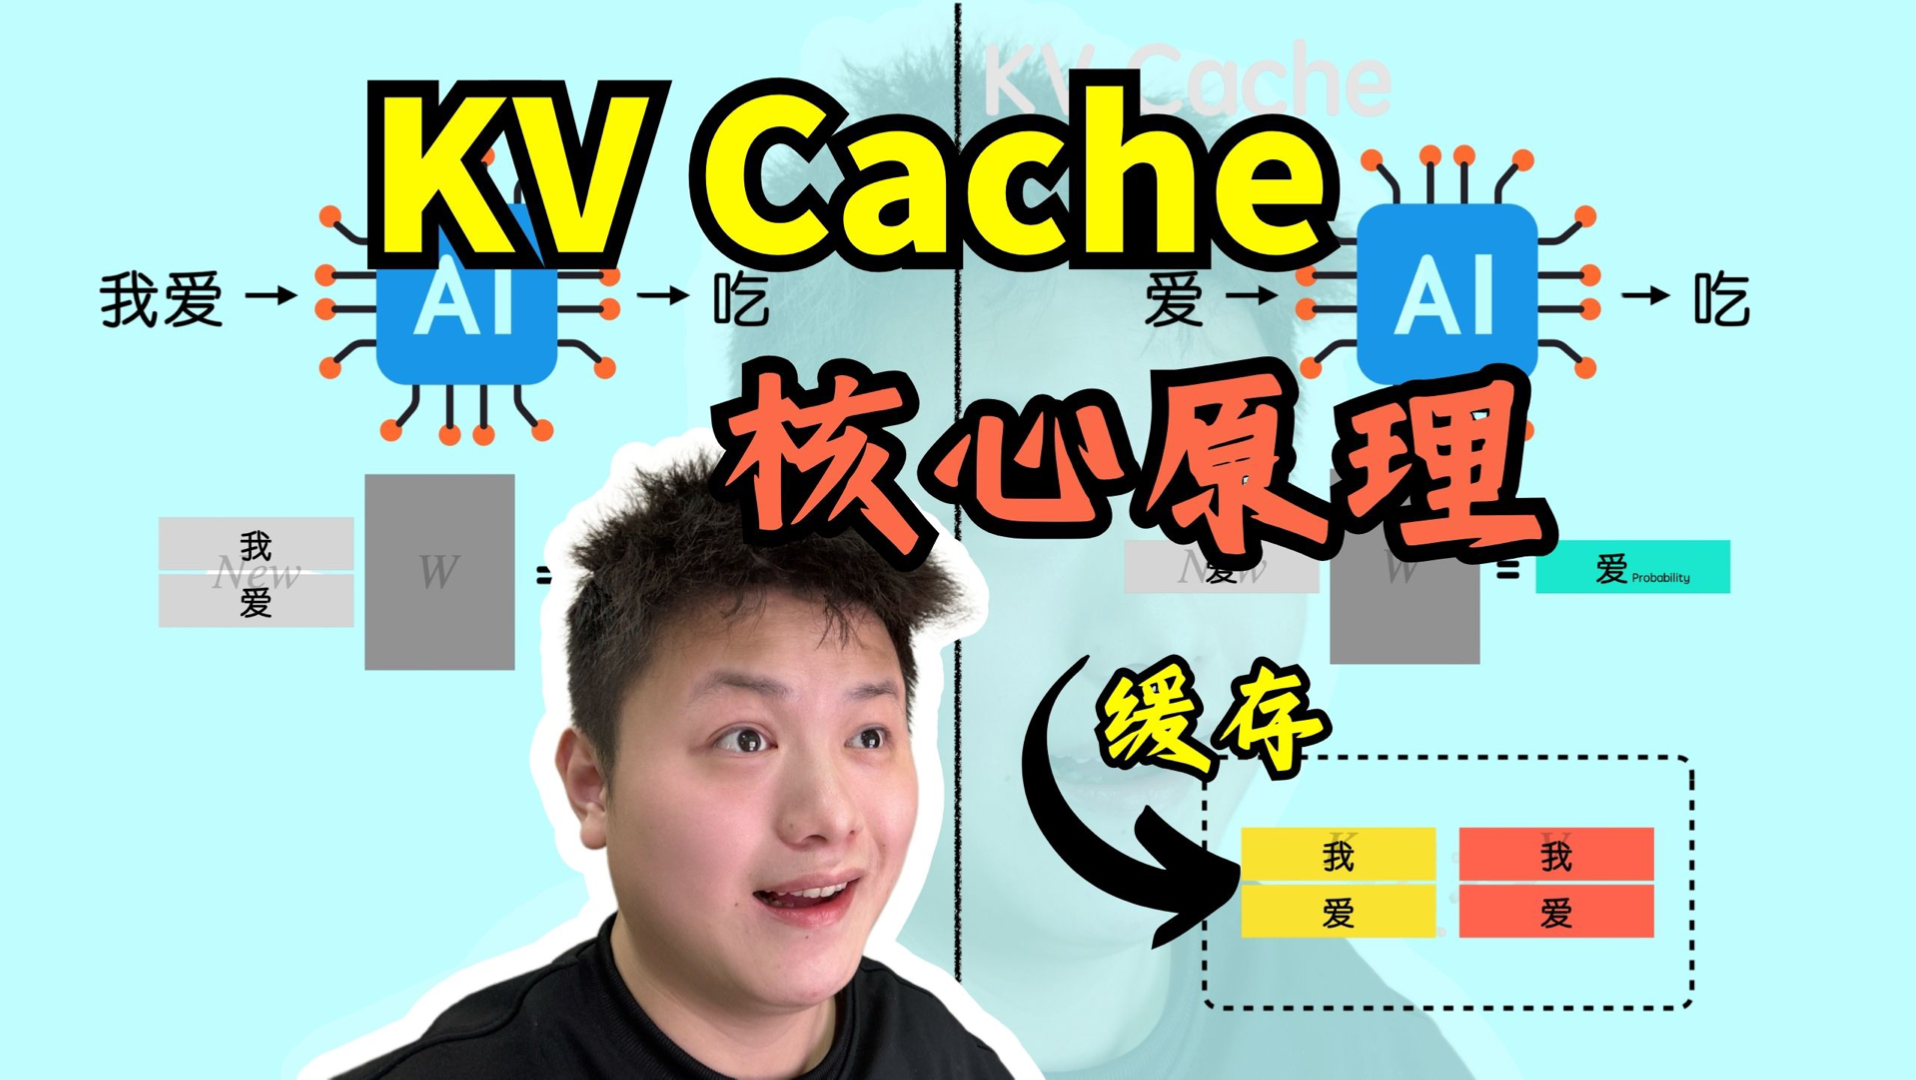
在生成式人工智能的浪潮中,大语言模型(LLM)的推理性能已成为制约其大规模落地的关键瓶颈,许多开发者在部署模型时,常会发现随着对话上下文的增长,显存占用呈线性甚至超线性增长,导致服务响应变慢或无法承载高并发请求,这种现象的根源在于键值缓存(KV Cache)的膨胀,KV Cache用于存储注意力机制中已计算的键(Key)和值(Value),以避免重复计算,对于长文本场景,这部分内存开销往往占据总显存的绝大部分,如何高效管理这一“内存黑洞”,成为业界关注的焦点,业内专家指出,解决这一问题的思路已从单纯的硬件堆砌转向算法与系统层面的协同优化。

KV Cache量化压缩技术解析
量化是降低KV Cache显存占用最直接且有效的手段,传统的FP16或BF16精度虽然能保证较高的模型精度,但在推理阶段,尤其是长上下文场景下,其显存成本难以承受。
低精度量化的实现路径
将KV Cache从FP16降至INT8甚至INT4,可以大幅减少内存带宽压力。
INT8量化策略
INT8量化将每个KV元素从2字节压缩至1字节,在大多数主流大模型中,这种精度损失对最终生成质量的影响微乎其微,但显存占用直接减半,操作层面,通常需要在推理引擎中启用特定的量化内核,例如在vLLM或TGI框架中配置相应的量化参数。
INT4及更低精度探索
对于显存极度敏感的边缘设备或超大规模并发场景,INT4甚至INT2量化成为可能,这需要更复杂的反量化算子支持,以确保在计算注意力分数时恢复精度,虽然计算复杂度略有增加,但由于内存带宽瓶颈的缓解,整体推理速度往往反而提升。

动态量化与静态量化的对比
静态量化在模型部署前完成,预设量化范围,速度快但可能因分布偏移导致精度下降,动态量化则在推理过程中实时计算量化参数,适应性更强,但引入了额外的计算开销,行业共识认为,对于KV Cache这类分布相对稳定的数据,静态量化配合校准数据集是更优选择。
KV Cache稀疏化与剪枝机制
并非所有历史Token都对当前生成步骤同等重要,通过识别并移除冗余的KV对,可以进一步释放显存。
基于注意力权重的剪枝
注意力机制的核心在于加权求和,如果某个历史Token在当前上下文中获得的注意力权重极低,其对最终输出的贡献便微乎其微。
滑动窗口与固定窗口策略
这是最经典的稀疏化方法,模型只保留最近N个Token的KV Cache,丢弃更早的部分,这种方法实现简单,适用于对长期依赖不敏感的任务,如即时聊天,但对于需要长文档总结的场景,固定窗口会导致关键信息丢失。
动态稀疏注意力
更先进的方案是根据实时注意力分数动态决定保留哪些KV,保留注意力得分最高的Top-K个Token,这种方法能更好地捕捉长距离依赖,同时保持较低的显存占用。
近似最近邻搜索在KV检索中的应用
当上下文极长时,暴力计算所有KV对的注意力分数成本过高,利用近似最近邻(ANN)算法,如HNSW或IVF-PQ,可以快速检索出与当前Query最相关的少量KV对,据工信部相关技术白皮书显示,这种检索加速策略在长文本问答场景中,可将推理延迟降低30%以上,同时保持较高的答案相关性。

KV Cache共享与复用技术
在多用户并发请求中,许多请求的前缀部分是相同的,多个用户同时询问关于“百度搜索引擎优化”的问题,其系统提示词和部分上下文完全一致。
前缀缓存(Prefix Caching)
前缀缓存技术将相同的KV Cache存储在高速缓存中,新请求到来时直接复用,无需重新计算。
全局缓存与局部缓存
全局缓存跨所有请求共享,适合公共提示词较多的场景;局部缓存仅在同一会话或同一用户组内共享,实际部署中,通常采用混合策略,以平衡缓存命中率与内存开销。
跨请求的KV复用
除了前缀共享,某些模型结构允许在不同请求间复用部分中间层输出,这需要模型架构具备一定的模块化特性,并在推理引擎中进行专门的调度优化。
实战优化方案与工具推荐
理论需要落地为具体的工程实践,以下是针对主流推理框架的优化路径。
vLLM中的PagedAttention优化
vLLM提出的PagedAttention机制,借鉴了操作系统中的分页内存管理思想,将KV Cache划分为物理块,支持非连续内存分配,这解决了显存碎片化问题,使得显存利用率显著提升。
配置步骤
1. 安装最新版本的vLLM库。
2. 在启动推理服务时,启用PagedAttention后端。
3. 根据显存大小调整`max_num_seqs`参数,以控制并发批次大小。
TGI中的量化支持
Hugging Face的Text Generation Inference(TGI)框架提供了开箱即用的量化支持。

操作指南
1. 使用`–quantize bitsandbytes`参数启动服务,可选择8bit或4bit量化。
2. 结合`–max-batch-prefill-tokens`限制预填充阶段的Token数量,防止显存溢出。
常见问题解答
KV Cache量化后模型精度下降明显怎么办?
通常INT8量化对精度影响极小,若发现显著下降,可尝试引入校准数据集进行微调量化,或采用混合精度策略,对敏感层保留FP16,其余层使用INT8,检查量化算法是否支持逐通道(per-channel)量化,这比逐层量化能更好地保留分布特征。
长上下文场景下,稀疏化剪枝会导致信息丢失吗?
是的,固定窗口剪枝必然导致早期信息丢失,解决方案是采用滑动窗口结合关键信息保留机制,或使用基于注意力的动态剪枝,确保高权重Token被保留,对于必须保留全部信息的场景,建议结合外部向量数据库进行检索增强生成(RAG),而非单纯依赖模型内部KV Cache。
前缀缓存命中率低如何提升?
提升命中率的关键在于优化请求调度策略,确保相同或相似的提示词尽可能被批处理在一起,调整缓存过期策略,避免频繁清理热点数据,对于多租户场景,可实施租户级隔离的缓存策略,减少无效缓存占用。
优化大模型的KV Cache并非单一技术的胜利,而是量化、稀疏化、共享机制与系统架构设计的综合博弈,随着硬件带宽的持续进步和算法的不断迭代,推理效率的提升空间依然广阔,开发者应根据具体业务场景,灵活组合上述策略,在成本与性能之间找到最佳平衡点。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/412088.html