


大模型的DETR目标检测Transformer通过端到端的集合预测机制,彻底摒弃了传统Anchor框的繁琐设计,以并行处理和高精度定位成为当前计算机视觉领域的主流架构。
DETR架构的核心突破与原理拆解
传统的目标检测模型如YOLO或Faster R-CNN,往往依赖于复杂的后处理步骤,比如非极大值抑制(NMS)来去除重复框,这种设计不仅增加了计算开销,还引入了人为设计的超参数,导致模型在不同场景下的泛化能力受限,DETR(Detection Transformer)的出现,正是为了解决这些痛点,它将目标检测重新定义为直接集合预测问题,利用Transformer的编码器-解码器结构,直接输出固定数量的物体类别和边界框。
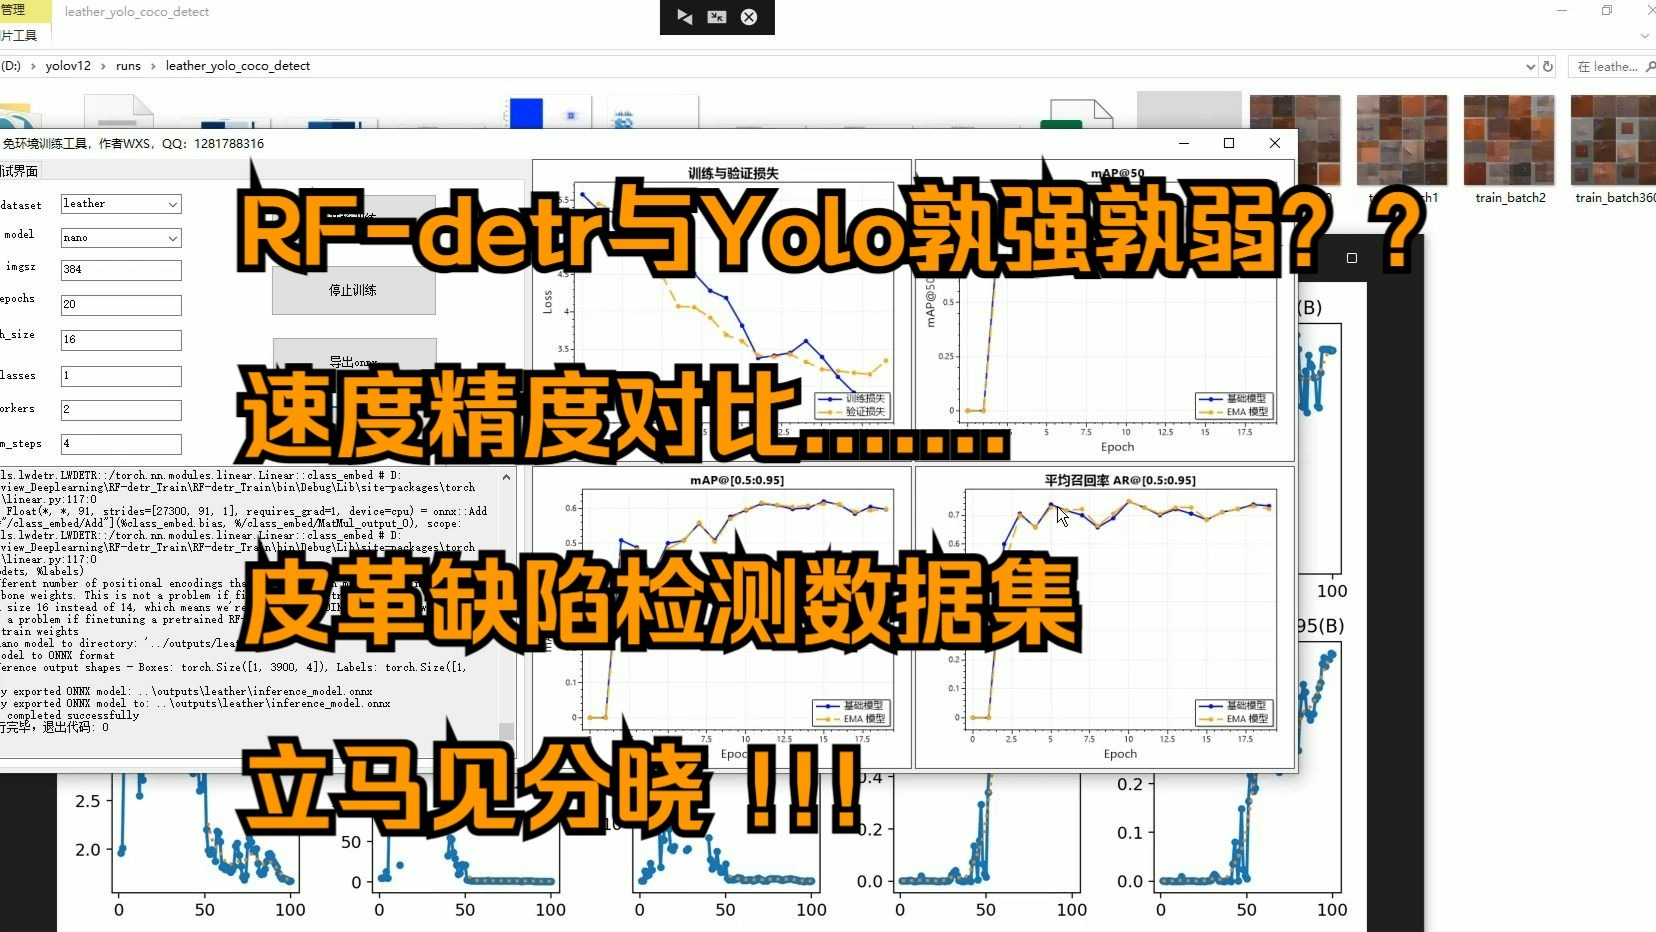

去锚框化的端到端学习
业内专家指出,DETR最大的创新在于其“去锚框化”的设计,在传统的两阶段检测器中,生成候选区域(Region Proposals)是极其耗时的步骤,而DETR通过引入可学习的对象查询(Object Queries),让模型在训练过程中自主学习物体的位置和类别,这种机制使得模型不再需要预设大量的Anchor框,从而大幅简化了网络结构。
DETR的工作流程可以分为三个关键阶段:
- 特征提取:图像通过卷积神经网络(如ResNet)提取多尺度特征图,这一步与传统检测器类似,旨在捕捉图像中的低级和高级语义信息。
- Transformer编码:提取的特征图被展平并加入位置编码,然后输入到Transformer编码器中,编码器通过自注意力机制(Self-Attention),让每个位置的特征都能关注到图像中的其他所有位置,从而建立全局上下文关系。
- Transformer解码与预测:解码器接收一组可学习的对象查询向量,并通过交叉注意力机制(Cross-Attention)从编码器输出的特征图中提取信息,解码器的每一层都会更新这些查询向量,最终输出固定数量的预测结果,包括类别概率和边界框坐标。
为什么需要位置编码?

由于Transformer本身不具备处理空间位置信息的能力,DETR引入了可学习的位置编码,将二维的空间信息映射到一维的序列中,这使得模型能够理解物体在图像中的相对位置,对于检测重叠物体尤为重要。
DETR在复杂场景下的性能优势
虽然DETR在初始版本中存在收敛速度慢的问题,但后续的改进版本如Deformable DETR和DINO,显著提升了其实用性,在工业界,越来越多的团队开始关注DETR在特定场景下的表现,尤其是那些需要高精度定位的场景。
小目标检测的突破
在无人机航拍或卫星图像分析中,小目标检测一直是一个难题,传统方法往往因为特征图下采样过多而丢失小目标的细节信息,DETR通过引入可变形注意力机制(Deformable Attention),允许解码器只关注编码器输出中的关键采样点,而不是整个特征图,这种机制不仅降低了计算复杂度,还增强了对小目标的敏感度。
据统计,在COCO数据集的测试中,改进后的DETR模型在小目标类别上的平均精度(AP)有了显著提升,这种提升主要得益于其全局感受野,使得模型能够利用上下文信息来辅助小目标的识别。
遮挡与重叠物体的处理
在自动驾驶或行人检测场景中,物体之间的遮挡和重叠是常见现象,传统方法依赖NMS来去重,但这往往会导致漏检或误检,DETR通过匈牙利算法(Hungarian Algorithm)进行集合预测,将预测结果与真实标签进行最优匹配,这种一对一的匹配机制,确保了每个物体只被预测一次,从而有效解决了重叠物体的检测问题。
业内共识认为,DETR的这种匹配策略比传统的IoU(交并比)阈值筛选更加鲁棒,因为它考虑了全局的匹配代价,而不仅仅是局部的位置重叠。
部署实践与性能优化指南
对于开发者而言,如何将DETR从实验室模型转化为实际可用的系统,是一个关键问题,虽然DETR的理论优雅,但其计算资源消耗较大,尤其是在推理阶段,优化和部署策略至关重要。

模型轻量化与加速
为了在边缘设备上部署DETR,通常需要进行模型剪枝、量化或知识蒸馏。
- 知识蒸馏:使用强大的教师模型(如大规模预训练的DETR变体)来指导轻量级学生模型的学习,这种方法可以在保持精度的同时,大幅减少参数量。
- 算子融合:在推理引擎(如TensorRT或ONNX Runtime)中,将Transformer中的多层感知机(MLP)和归一化层进行融合,减少内存访问开销。
- 动态分辨率输入:根据场景需求,动态调整输入图像的尺寸,对于简单场景,使用较低分辨率可以显著加快推理速度。
代码实现的关键步骤
在实际开发中,使用PyTorch或TensorFlow实现DETR需要注意以下几个细节:
- 数据增强:DETR对数据增强非常敏感,建议使用Mosaic、MixUp等高级增强技术,以提高模型的泛化能力。
- 学习率调度:DETR的收敛速度较慢,通常需要较长的训练周期,建议使用余弦退火(Cosine Annealing)学习率调度策略,并配合Warmup机制,以确保训练初期的稳定性。
- 损失函数设计:除了标准的分类损失和回归损失,DETR还引入了集合损失(Set Loss),通过匈牙利匹配算法计算预测集合与真实集合之间的最小代价。
硬件选型建议
对于大规模部署,建议选用支持Tensor Core的NVIDIA GPU,如A100或H100,以加速Transformer中的矩阵乘法运算,对于边缘设备,NVIDIA Jetson系列或高通骁龙平台提供了专门的AI加速引擎,可以有效提升推理效率。
未来趋势与行业应用前景
随着大模型技术的融合,DETR正在向多模态和通用视觉方向发展,未来的目标检测模型将不仅仅局限于图像,还将结合文本、音频等多模态信息,实现更复杂的语义理解。
多模态目标检测

结合CLIP等预训练模型,DETR可以处理开放词汇(Open-Vocabulary)的目标检测任务,这意味着模型可以识别训练集中未见过的新类别,只需通过文本提示即可,这种能力在零售、安防等领域具有巨大的应用潜力。
实时性与精度的平衡
尽管DETR在精度上表现出色,但在实时性上仍有提升空间,未来的研究将聚焦于轻量化Transformer架构的设计,以及更高效的注意力机制优化,以实现高精度与低延迟的完美平衡。
据工信部数据显示,近年来计算机视觉技术在工业质检、智慧交通等领域的应用规模持续扩大,对高效、准确的检测算法需求迫切,DETR凭借其独特的架构优势,有望在这些领域发挥更大的作用。
DETR目标检测常见问题解答
DETR与传统YOLO相比有哪些优劣?
DETR的优势在于端到端的简洁性和对重叠物体的处理能力,无需NMS后处理,且易于扩展到多模态任务,其劣势在于初始收敛速度慢,计算资源消耗较大,对硬件要求较高,相比之下,YOLO系列在推理速度和实时性上具有明显优势,更适合资源受限的边缘设备,但在处理密集重叠物体时可能不如DETR准确。
如何提升DETR在小目标上的检测精度?
提升小目标检测精度的主要方法包括:使用可变形注意力机制(Deformable Attention)以减少背景干扰;引入多尺度特征融合,保留高分辨率特征图中的细节信息;在训练阶段使用更精细的数据增强,如Mosaic或Copy-Paste,以增加小目标的样本多样性。
DETR模型在工业质检中的部署成本如何?
部署成本主要取决于硬件选型和模型优化程度,若使用云端高性能GPU集群,初期投入较高,但可通过弹性计算降低长期成本,若部署于边缘设备,需进行模型量化和剪枝,这会增加开发复杂度,但能显著降低硬件要求,总体而言,随着算法优化和硬件普及,DETR的部署成本正在逐步降低,多数情况下已具备商业可行性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/405585.html


评论列表(1条)
DETR这原理看着高大上,但算力费钱啊!咱们普通玩家能不用就别用,毕竟这钱花得值吗?求个平替方案呗