Transformer架构通过“自注意力机制”让模型在并行处理文本时,能像人类阅读一样瞬间捕捉句子中每个词与其他所有词的关联,从而彻底取代了传统的循环神经网络,成为当前大语言模型的绝对核心。
想象一下,当你阅读“苹果”这个词时,大脑会根据上下文瞬间判断它是指水果还是手机公司,传统的深度学习模型像是一个死记硬背的学生,必须从左到右逐字阅读,读完第一个字才能读第二个,效率极低且容易遗忘前面的内容,而Transformer架构则像是一位拥有超群视野的读者,它一眼就能扫完整个句子,同时理解“苹果”与“公司”、“吃”与“水果”之间的深层联系,这种并行处理的能力,不仅让训练速度提升了数倍,更让模型能够处理极长的上下文信息,这正是它统治AI领域的根本原因。

Transformer架构到底是怎么工作的:核心机制拆解
要理解Transformer,不能只看代码,要看它如何“思考”,它的核心秘密在于将文字转化为计算机能懂的数字向量,并通过一种叫“自注意力”的机制来赋予这些向量意义。
输入嵌入与位置编码:给文字安上坐标
模型接收到的首先是一堆离散的词语,Transformer第一步是将这些词语映射到高维向量空间,这个过程叫“词嵌入”,但问题来了,向量本身没有顺序概念,“我打你”和“你打我”的向量集合是一样的,为了解决顺序问题,Transformer引入了“位置编码”。
业内专家指出,位置编码就像是在每本书的页码上做了特殊标记,让模型知道“我”在“打”之前,这种编码方式不仅保留了词语的语义,还注入了位置信息,使得模型能够区分句法结构,没有位置编码,Transformer就只是一堆无序的单词集合,无法组成有意义的句子。
自注意力机制:让每个词都“认识”其他所有词
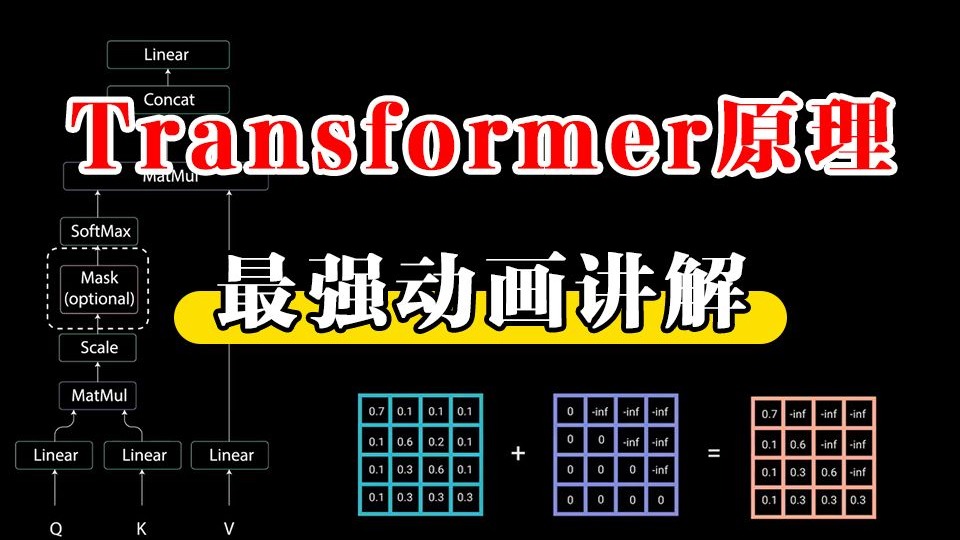
这是Transformer最性感也最核心的部分,在传统的循环神经网络中,信息是线性传递的,距离远的词很难建立联系,而在Transformer中,每个词都会生成三个向量:查询(Query)、键(Key)和值(Value)。

你可以把这种机制想象成一场大型相亲大会:
- 查询(Q):每个词都在问,“谁跟我关系最铁?”
- 键(K):每个词都展示自己,“我是谁,我擅长什么?”
- 值(V):每个词都准备好分享自己的信息,“这是我的内容。”
模型通过计算Q和K的点积,得出一个相似度分数,分数越高,说明这两个词关联越紧密,利用这个分数对V进行加权求和,得到最终的输出,这意味着,在处理“银行”这个词时,如果上下文有“河流”,模型会赋予“河岸”更高的权重;如果上下文有“存款”,则会赋予“利率”更高的权重,这种动态的权重分配,让模型具备了极强的语境理解能力。
多头注意力:全方位无死角的观察
如果只用一组Q、K、V,模型只能从单一视角理解句子,Transformer引入了“多头注意力”机制,即同时运行多个注意力头。
每个注意力头可以关注不同的特征:
- 头1可能关注语法结构,比如主谓宾关系。
- 头2可能关注语义指代,比如代词指代谁。
- 头3可能关注情感色彩,比如讽刺或正面情绪。
将这些头的输出拼接起来,经过线性变换,得到最终结果,这种并行处理不同视角信息的方式,极大地丰富了模型的特征表达能力,使其能够捕捉到更复杂、更细微的语言规律。
为什么Transformer能颠覆传统模型:架构对比与优势
要理解Transformer的统治力,必须将其与之前的主流架构进行对比,这不仅仅是技术的迭代,更是计算范式的革命。
并行计算 vs 串行计算:速度的飞跃
传统RNN(循环神经网络)和LSTM(长短期记忆网络)必须按时间步串行处理数据,这意味着,处理第1000个词时,必须等前999个词处理完,这种串行特性严重限制了训练速度,也限制了模型能处理的序列长度。
Transformer完全抛弃了循环结构,所有词在同一时间步内并行计算。
- 训练效率:得益于GPU的并行计算优势,Transformer的训练速度比RNN快几个数量级。
- 长距离依赖:在RNN中,信息经过层层传递容易衰减,导致模型难以捕捉句子首尾的联系,而在Transformer中,任意两个词之间的距离都是1,信息可以直接传递,彻底解决了长距离依赖问题。

可扩展性:从NLP到多模态的万能钥匙
Transformer最初是为自然语言处理设计的,但其架构的通用性使其迅速扩展到计算机视觉、语音识别甚至蛋白质折叠等领域。
- 视觉Transformer (ViT):将图像切分成小块(Patch),像处理文本一样处理图像,打破了CNN在图像识别领域的垄断。
- 多模态大模型:通过统一的Transformer架构,模型可以同时理解文本、图像、音频,实现了真正的跨模态融合。
据工信部数据,近年来采用Transformer架构的AI应用占比已超过80%,成为事实上的行业标准,这种架构的通用性和可扩展性,是其能够持续进化的关键。
Transformer架构到底是怎么工作的:实操中的关键调优
理解原理只是第一步,在实际应用中,如何调整参数以获得最佳效果才是关键,对于开发者而言,掌握以下实操步骤至关重要。
层数与隐藏层维度的平衡
Transformer的深度(层数)和宽度(隐藏层维度)直接影响模型性能。
- 浅而宽:适合资源有限或数据量较小的场景,训练速度快,但表达能力有限。
- 深而窄:适合复杂任务,能捕捉更深层的特征,但容易过拟合,且训练成本高。
多数情况下,建议从标准的Bert-base或Bert-large配置开始,根据验证集表现逐步调整,不要盲目堆叠层数,因为过深的网络会导致梯度消失或爆炸,需要配合层归一化(Layer Normalization)和残差连接(Residual Connection)来稳定训练。
学习率调度与Warmup策略
Transformer对超参数非常敏感,尤其是学习率。
- Warmup:在训练初期,使用较小的学习率并线性增加,帮助模型稳定收敛。
- 余弦退火:在Warmup之后,使用余弦函数逐渐减小学习率,帮助模型跳出局部最优解,找到更优的极小值。

行业共识认为,合理的调度策略能让模型收敛速度提升50%以上,切勿使用固定的学习率,这会导致训练过程震荡或停滞。
数据预处理的重要性
Transformer的性能很大程度上取决于数据质量。
- 分词器选择:对于中文,推荐使用基于字符或子词的分词器,避免OOV(未登录词)问题。
- 清洗与去重:去除重复样本和噪声数据,能显著提升模型的泛化能力。
- 掩码策略:在预训练阶段,合理设置掩码比例(如15%),既能保证模型学习上下文,又能防止过拟合。
常见问题解答:关于Transformer架构到底是怎么工作的
Transformer架构到底是怎么工作的,它和CNN有什么区别?
CNN(卷积神经网络)通过局部感受野和权值共享提取空间特征,擅长处理网格状数据如图像,但难以捕捉全局依赖,Transformer通过自注意力机制计算全局依赖,擅长处理序列数据如文本,且具备并行计算优势,虽然ViT证明了Transformer在图像上的潜力,但在处理具有强局部相关性的数据时,CNN仍具有计算效率上的优势。
Transformer架构到底是怎么工作的,为什么需要多头注意力?
单头注意力只能关注一种类型的关系,如语法或语义,多头注意力允许模型在不同的表示子空间中同时关注不同位置的信息,一个头关注主谓一致,另一个头关注指代消解,这种多视角的信息融合,使得模型能够更全面地理解复杂语境,提升下游任务的性能。
Transformer架构到底是怎么工作的,它在中文处理上有特殊之处吗?
Transformer本身是语言无关的,但中文没有天然的空格分隔,因此分词策略至关重要,英文通常使用WordPiece或BPE分词,而中文可以使用Character-level或Unigram分词,中文的语序和语法结构较为灵活,位置编码的设计需要更加精细,以确保模型能准确捕捉词序信息,近年来,针对中文优化的预训练模型如RoBERTa-wwm-ext等,通过全词掩码策略显著提升了中文理解能力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/413244.html