在Hive中选择数据库的核心方法是使用USE database_name;命令,或者在建表时通过database_name.table_name的全限定名直接指定,这是进行数据隔离和权限管理的基础操作。
很多刚接触大数据开发的朋友,面对Hive庞大的元数据体系,往往会在“选库”这一步卡壳,Hive的数据库(Database)概念和传统关系型数据库中的Schema或Namespace非常相似,它本质上是一个逻辑容器,用来组织表、视图和其他元数据对象,选对库,不仅能让你的SQL语句更清晰,还能有效避免命名冲突,提升团队协作效率。
为什么Hive需要显式选择数据库
在Hive中,默认情况下,所有的表操作都发生在default数据库下,如果你不显式指定库名,Hive就会去default里找表,随着项目复杂度增加,这种默认行为会带来巨大的维护风险。
业内专家指出,良好的元数据管理是大数据平台稳定运行的基石,如果不进行库的隔离,不同业务线的数据混在一起,会导致以下问题:
- 命名冲突:A团队和B团队都创建了一张名为
user_info的表,Hive无法区分,导致查询结果混乱。 - 权限失控:难以对特定业务数据进行细粒度的权限控制,容易引发数据泄露风险。
- 查询效率下降:全库扫描会增加NameNode和Metastore的压力,尤其是在数据量达到PB级别时。
养成“先选库,后操作”的习惯,是专业数据工程师的基本素养。
默认库default的局限性
虽然default库方便新手入门,但在生产环境中,它通常被视为“垃圾场”。
- 缺乏业务语义:
default库无法体现数据所属的业务部门或项目阶段。 - 清理困难:由于缺乏分类,删除测试数据时容易误删生产数据。
- 监控盲区:无法针对特定库设置独立的存储配额或计算资源限制。
建议新项目直接摒弃default库,为每个业务线或数据层级创建独立的数据库。
Hive选择数据库的实操方法
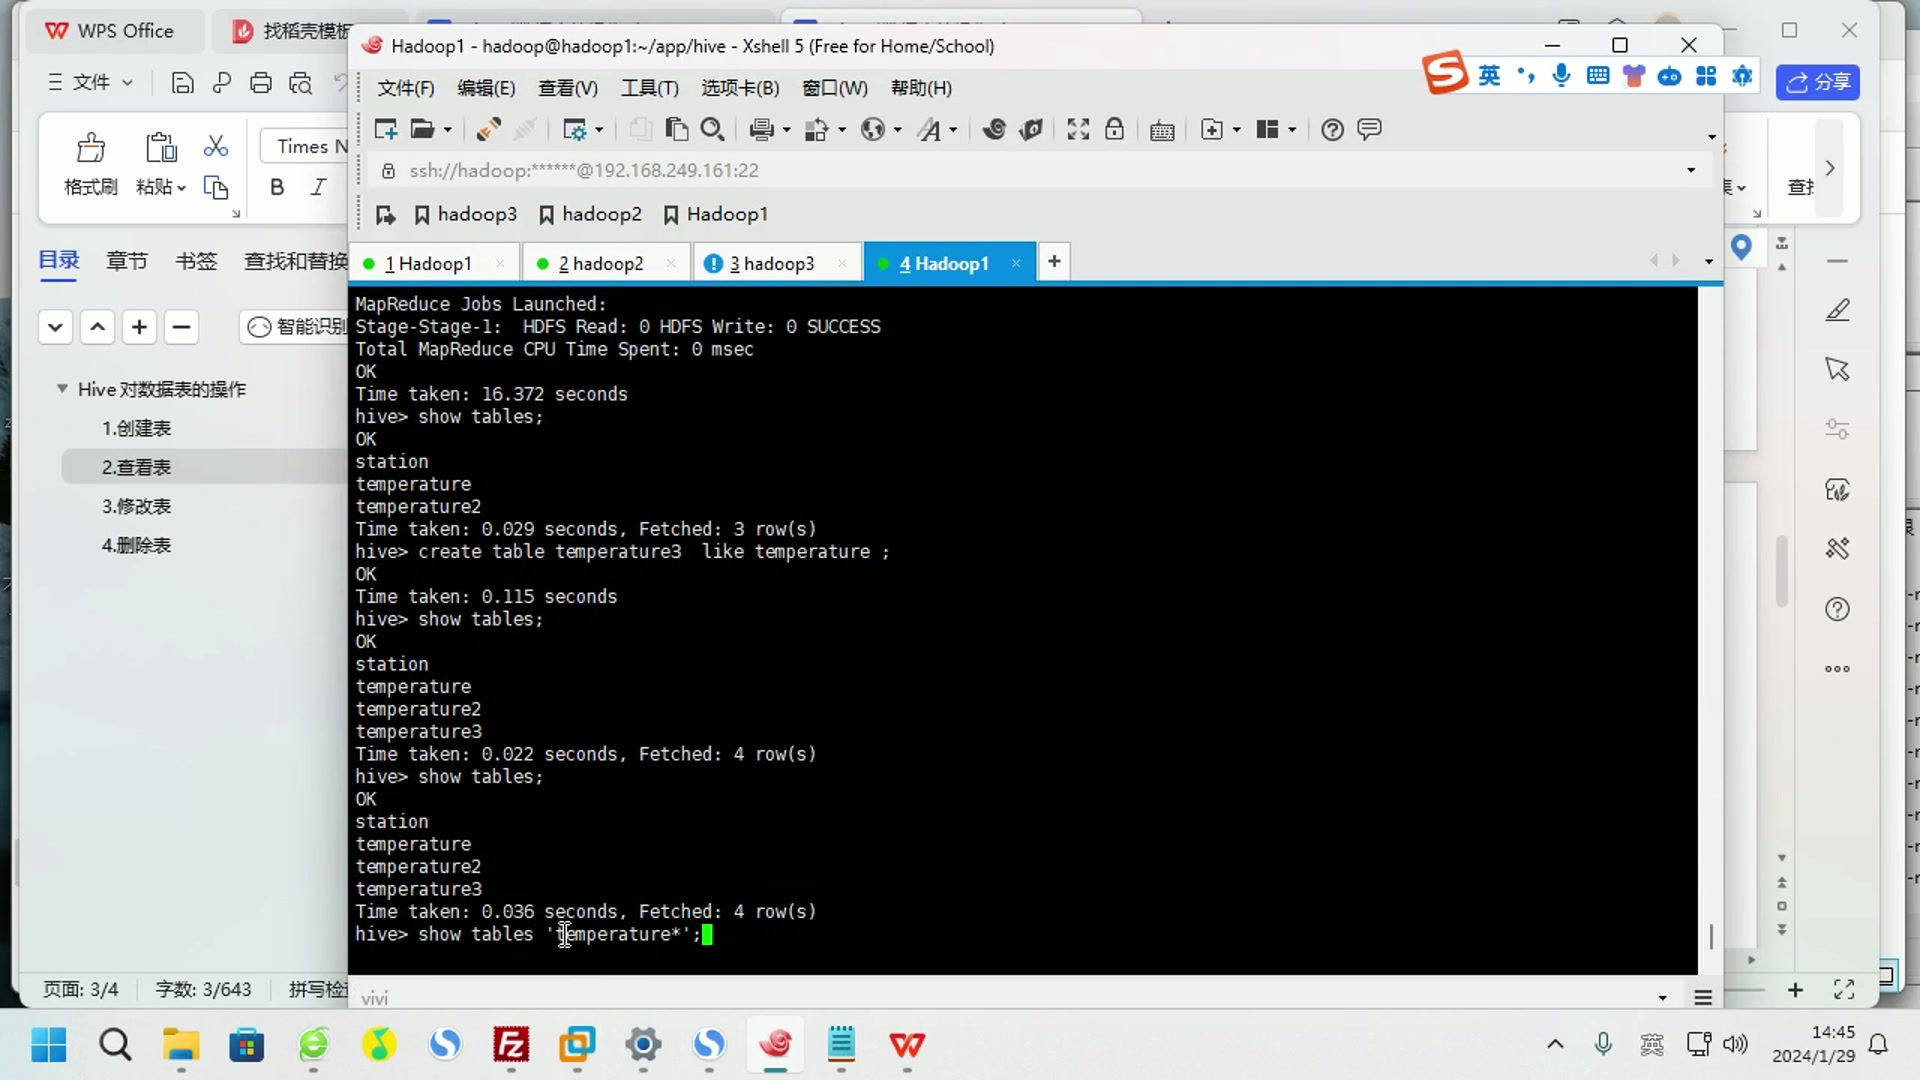
在实际工作中,我们有多种方式来指定目标数据库,根据使用场景的不同,选择最合适的方法至关重要。

使用USE命令切换上下文
这是最常用、最直观的方法,通过USE语句,你可以将当前的会话上下文切换到指定的数据库。
-
基本语法:
USE database_name; -
操作示例:
假设你有一个名为ods_sales的库,想在其中创建一张表:USE ods_sales; CREATE TABLE daily_revenue ( date STRING, revenue DOUBLE ) STORED AS ORC; -
注意事项:
USE命令只影响当前会话,如果你断开连接重新登录,默认会回到default库。- 如果指定的数据库不存在,Hive会报错,建议在执行前先用
SHOW DATABASES;确认库名。
使用全限定名直接引用
当你不想频繁切换上下文,或者在一条SQL中需要跨库关联表时,使用全限定名是最佳选择。
- 语法格式:
database_name.table_name - 适用场景:
- 多库JOIN操作。
- 脚本中需要保持上下文独立性,避免依赖之前的
USE命令。 - 临时查询或ETL脚本编写。
对比示例:
| 操作方式 | 语法示例 | 优点 | 缺点 |
|---|---|---|---|
| USE命令 | USE db1; SELECT FROM table1; |
代码简洁,可读性强 | 依赖上下文,易出错 |
| 全限定名 | SELECT FROM db1.table1; |
上下文无关,安全稳健 | 代码稍长,重复输入库名 |
跨库查询的最佳实践
在处理数据仓库分层架构(ODS/DWD/DWS/ADS)时,跨库查询非常常见。
- ODS层到DWD层

:通常建议将ODS和DWD放在同一个库中,通过分区隔离,减少跨库开销。
- DWD到DWS:如果DWS库独立,使用全限定名
dws_db.summary_table进行查询,确保逻辑清晰。 - 权限控制:通过全限定名,可以更精确地授予用户对特定库表的SELECT权限,实现最小权限原则。

数据库创建与管理的进阶技巧
选择数据库不仅仅是切换上下文,还包括如何创建和管理这些库,以适应不同的业务需求。
创建数据库时的参数配置
在创建数据库时,可以通过参数配置来定义其属性,这直接影响后续表的行为。
-
LOCATION:指定HDFS上的存储路径。
CREATE DATABASE my_db LOCATION '/user/hive/warehouse/my_db.db';
这有助于数据归档和存储成本控制。 -
COMMENT:添加描述信息。
CREATE DATABASE marketing_db COMMENT 'Marketing department data';
清晰的注释有助于团队协作,避免“黑盒”库的出现。 -
WITH DBPROPERTIES:设置自定义属性。
CREATE DATABASE test_db WITH DBPROPERTIES ('created_by'='data_team', 'env'='prod');
这些属性不会直接影响查询,但可用于元数据管理和审计。
常见误区与避坑指南
很多初学者在库管理上容易犯一些错误,导致后续维护困难。
-
库名不规范:
- 避免使用中文、特殊字符或空格。
- 建议采用小写字母+下划线的命名规范,如
dim_user_info。 - 库名应具有业务含义,避免使用
db1、test_db等无意义名称。
-
忽视权限隔离:
- 不同业务线的库应分配不同的Owner。
- 使用Ranger或Sentry等安全组件,对库进行细粒度权限控制。
-
过度拆分库:
- 虽然隔离很重要,但也不要为每个小项目都建一个库。
- 建议按业务域(如用户域、交易域)或数据层级(ODS/DWD)进行划分,保持层级扁平。
Hive数据库选择与性能优化
虽然选择数据库本身不直接提升查询性能,但合理的库结构设计能间接优化系统表现。

减少元数据压力
Hive的Metastore存储了所有的表和库信息,如果库和表数量过多,Metastore的查询压力会增大。
- 定期清理:删除不再使用的库和表。
- 归档历史数据:将冷数据移动到归档库,并从生产库中移除。
利用分区和桶优化查询
在选定的库中,进一步通过分区和桶来组织表数据,可以显著提升查询效率。
- 分区:按日期、地区等维度划分,减少扫描数据量。
- 桶:对数据进行哈希分桶,加速JOIN操作,特别是大表JOIN。
数据隔离与资源管理
在集群资源紧张的情况下,可以通过队列或资源组来限制特定库的查询资源。
- YARN队列隔离:为不同业务线的库分配不同的YARN队列。
- 查询超时设置:为特定库设置查询超时时间,防止长查询拖垮集群。
Q&A:Hive选择数据库常见问题
Hive中如何查看当前所在的数据库?
在Hive CLI或Beeline中,可以通过执行SELECT current_database();命令来查看当前会话所在的数据库名称,如果返回结果为null或default,则说明你处于默认数据库或未指定库,使用DESCRIBE DATABASE EXTENDED current_database();可以获取当前库的详细信息,包括位置、注释等。
切换数据库会影响已加载的数据吗?
不会。USE命令仅改变当前会话的上下文环境,即默认查找表的路径前缀,它不会移动、删除或修改任何实际存储在HDFS上的数据文件,数据仍然保留在原来的位置,只是你当前无法直接通过表名访问它们,必须使用全限定名或切换回原库才能访问。
能否在Hive中为数据库设置密码保护?
Hive原生不支持对数据库设置密码,Hive的权限控制主要依赖于外部组件,如Apache Ranger或Apache Sentry,通过这些组件,你可以配置基于角色的访问控制(RBAC),限制特定用户或组对特定数据库的访问权限,从而实现类似密码保护的安全隔离效果。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/443605.html