通过调用address/batchSave接口,开发者可以一次性将地图标记点及其对应的经纬度、描述等结构化数据持久化存储,从而彻底解决前端拖动位置后数据丢失的痛点,实现批量位置信息的精准同步与高效管理。
在地图应用开发中,用户交互的核心往往在于“位置”的获取与确认,当用户在移动端或PC端通过拖拽地图标记(Marker)来调整位置时,如果缺乏有效的后端存储机制,这些精心调整的数据就会随着页面刷新或会话结束而消失,这不仅破坏了用户体验,更导致业务数据的断层,address/batchSave接口正是为了解决这一核心痛点而生,它允许后端接收来自前端的批量位置变更请求,并将这些变动实时、准确地写入数据库。

为什么需要批量保存位置信息而非单条保存
在实际的业务场景中,如物流配送、外卖骑手调度或资产追踪,用户往往需要同时处理多个标记点,如果采用传统的单条保存方式,每调整一个位置就需要发起一次HTTP请求,这种高频次的网络交互会带来显著的性能瓶颈。
业内专家指出,网络延迟和服务器负载是制约大规模地图应用流畅度的关键因素,当同时存在50个标记点需要更新时,单条保存将产生50次请求,而批量保存仅需1次,这种差异在弱网环境下尤为明显,批量接口能显著降低请求失败率,提升系统的整体稳定性。
批量保存与单条保存的性能对比
为了更直观地理解两者的差异,我们可以通过以下维度进行对比:
- 网络请求次数:单条保存随数据量线性增长,批量保存始终为1次。
- 服务器CPU负载:批量处理减少了数据库事务的开启与关闭次数,降低了I/O开销。
- 前端响应速度:减少等待时间,用户操作感知更流畅,无明显卡顿。
-

代码复杂度
:虽然批量接口参数结构稍复杂,但前端逻辑只需遍历一次数组即可,维护成本更低。

address/batchSave接口的核心优势
该接口不仅提升了效率,还增强了数据的一致性,在批量操作中,要么全部保存成功,要么全部失败并回滚,避免了部分成功、部分失败导致的数据状态不一致问题,这对于金融、物流等对数据准确性要求极高的行业至关重要。
address/batchSave接口的实操指南
要正确使用address/batchSave接口,开发者需要理解其参数结构、请求方式以及错误处理机制,以下是一个标准的调用流程。
请求参数结构解析
接口通常接受一个JSON格式的请求体,主要包含以下关键字段:
基础信息字段
userId:用户唯一标识,用于权限校验。
sessionId:会话ID,确保数据归属的正确性。
位置数据数组
这是核心部分,通常命名为`locations`或`markers`,是一个对象数组,每个对象应包含:
id:标记点的唯一标识,用于后端匹配更新。
lng:经度,浮点数,精度建议保留6位小数。
lat:纬度,浮点数,精度建议保留6位小数。
address:可选字段,用户自定义的描述或备注信息。
timestamp:操作时间戳,用于并发冲突检测。
具体调用步骤
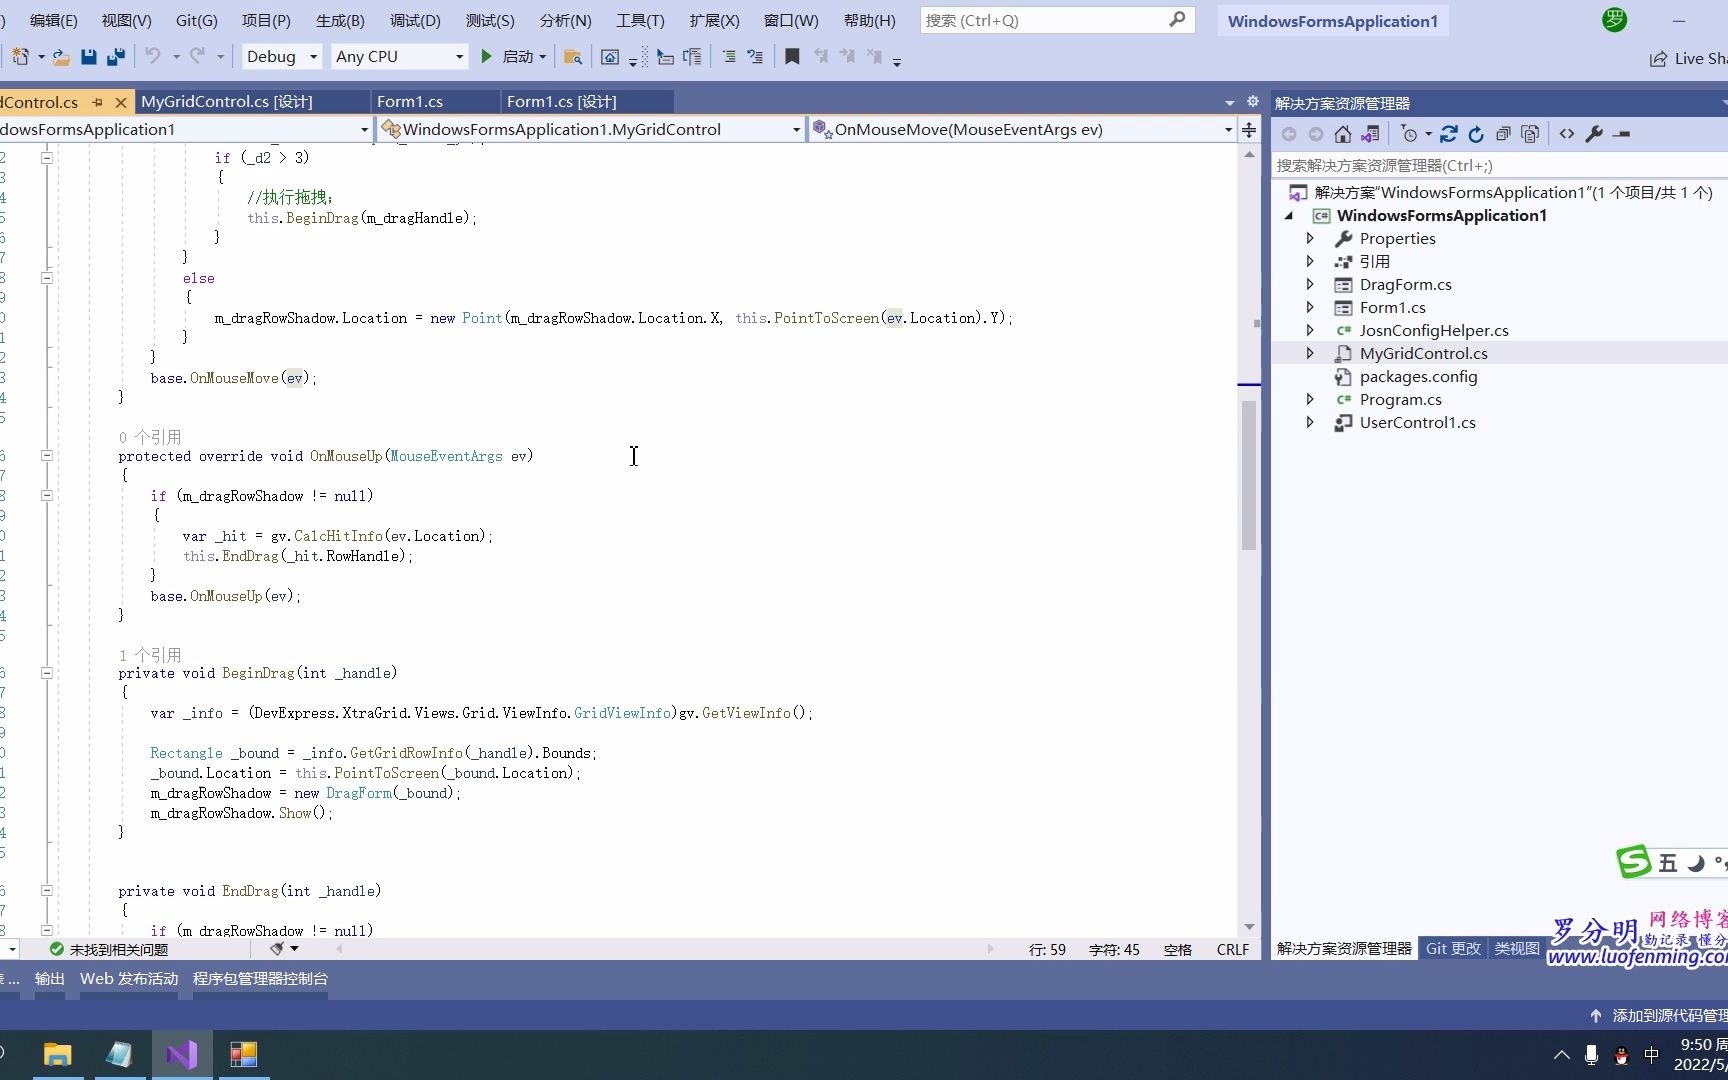
- 前端监听拖拽事件:在地图SDK中监听
dragend事件,获取最新的经纬度。 - 构建数据队列:将当前页面上所有被修改过的标记点信息收集到一个数组中。
- 组装请求体:将用户信息和位置数组封装成JSON对象。
- 发起POST请求:调用
/api/address/batchSave接口,设置正确的Content-Type为application/json。 - 处理响应结果:根据返回的状态码(200成功,400参数错误,500服务器错误)进行相应的UI反馈。

代码示例片段
const batchData = {
  userId: 'user_12345',
  locations: [
    { id: 'm1', lng: 116.404, lat: 39.915, address: '新位置A' },
    { id: 'm2', lng: 116.405, lat: 39.916, address: '新位置B' }
  ]
};
fetch('/api/address/batchSave', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify(batchData)
})
.then(response => response.json())
.then(data => console.log('保存成功', data));
常见问题与解决方案
在实际应用中,开发者可能会遇到各种边界情况,以下是关于地址批量保存位置信息时常见问题的专业解答。
address/batchSave接口并发冲突如何处理?
当多个用户同时编辑同一组标记点时,可能会发生数据覆盖,解决方案是采用乐观锁机制,在请求参数中加入version字段,后端在更新前检查数据库中的版本号,如果版本号不一致,则返回冲突错误,前端提示用户刷新页面或合并数据。
如何处理大量数据导致的超时问题?
如果单次批量保存的数据量过大(如超过1000条),可能会导致网关超时,建议在前端进行分页或分片处理,每次发送50-100条数据,通过循环或Promise.all并发执行多个批量请求,既保证了速度,又避免了单次请求过大。
地址解析失败怎么办?
如果传入的经纬度无法解析为具体地址,或者地址格式不规范,接口应返回明确的错误码,前端应捕获这些错误,并允许用户手动修正地址信息,而不是直接阻断整个批量保存流程。
最佳实践与优化建议
为了确保address/batchSave接口在生产环境中的稳定运行,建议遵循以下最佳实践。
数据校验前置

在前端发起请求前,务必对经纬度范围、数据格式进行严格校验,无效的经纬度(如经度超过180度)应在前端直接拦截,避免无效请求消耗服务器资源。
日志监控与告警
建立完善的日志系统,记录每次批量保存的请求参数、响应时间和错误信息,当失败率超过一定阈值时,触发告警通知运维人员,以便及时发现潜在的系统问题。
缓存策略优化
对于不频繁变动的标记点数据,可以考虑引入Redis缓存,在批量保存成功后,同步更新缓存,确保后续读取操作的高速响应。
address/batchSave接口是现代地图应用开发中不可或缺的工具,它通过批量处理机制,显著提升了位置数据同步的效率和稳定性,开发者只需遵循标准的调用流程,做好数据校验和异常处理,即可轻松实现高效的位置信息管理。
Q&A:address/batchSave接口相关问题
address/batchSave接口支持的最大数据量是多少?
不同服务商的配置略有差异,但通常建议单次请求不超过500条记录,若业务场景需要处理更多数据,应采用分批次策略,将大数据集拆分为多个小批次依次提交,以确保系统的稳定性和响应速度。
如果部分位置保存成功,部分失败,接口会返回什么?
标准的批量接口通常采用“全有或全无”的策略,如果其中任何一条数据校验失败或保存出错,整个请求将返回错误,所有数据都不会被持久化,这种设计保证了数据的一致性,避免了部分成功导致的数据混乱。
address/batchSave接口是否支持异步处理?
对于超大数据量的场景,接口可配置为异步处理模式,前端发起请求后立即获得“已接收”的响应,后端在后台队列中逐步处理数据,处理完成后通过WebSocket或回调通知前端最终结果,从而避免前端长时间等待导致的超时问题。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/450482.html