


通过Hive导出数据到MySQL的核心方案是利用Sqoop工具或编写Spark SQL脚本,前者适合大规模离线同步,后者适合实时或轻量级处理,关键在于解决数据类型映射与性能瓶颈。
将Hive中的海量数据迁移至MySQL,是许多数据团队在构建数据仓库或报表系统时的必经之路,Hive擅长处理PB级的离线分析,而MySQL则是业务应用层最熟悉的OLTP数据库,两者之间的数据流转,不仅仅是简单的复制粘贴,更是一场关于性能、稳定性和数据一致性的技术博弈,很多初学者容易陷入“直接查询导出”的误区,导致集群资源耗尽或MySQL连接超时,掌握正确的工具链和操作路径,是确保数据流转顺畅的关键。

为什么不能直接导出?常见误区解析
在讨论具体操作之前,我们需要先厘清一个核心概念:Hive和MySQL的底层架构截然不同,Hive基于Hadoop生态,采用MapReduce或Tez引擎,适合高吞吐量的批处理;MySQL则是关系型数据库,强调事务处理和低延迟查询,如果直接在Hive中执行SELECT FROM table并将结果拉取到本地,再通过客户端导入MySQL,这种做法在数据量超过百万行时就会显得捉襟见肘。
业内专家指出,这种“拉取式”迁移存在三大致命缺陷:一是网络IO瓶颈,大量数据穿越网络传输极易造成带宽拥堵;二是内存溢出风险,客户端或中间件难以承载巨大的结果集;三是缺乏断点续传机制,一旦中断需从头开始,效率极低,必须采用专门的ETL工具或分布式计算框架来实现数据的高效搬运。
主流方案对比:Sqoop与Spark SQL
目前业界主流的解决方案主要有两种:Apache Sqoop和Spark SQL,选择哪种方案,取决于你的数据规模、实时性要求以及现有基础设施。
Sqoop:专为Hadoop设计的迁移利器
Sqoop(SQL-to-Hadoop)是Apache基金会下的一个项目,旨在在Hadoop和结构化数据存储(如关系型数据库)之间高效传输数据,它是Hive导出MySQL最经典的选择,尤其适合处理TB级别的历史数据。

Sqoop的优势与适用场景
- 并行度高:Sqoop会自动将导入任务拆分为多个Map任务,充分利用集群资源,速度极快。
- 类型映射自动:它能自动识别Hive和MySQL的数据类型,并进行合理的转换,减少手动配置成本。
- 增量导入支持:支持基于时间戳或自增ID的增量导入,非常适合每日全量或增量同步的场景。
Sqoop的局限性
- 学习曲线:需要熟悉Hadoop生态,配置相对复杂。
- 实时性差:本质上是批处理工具,不适合毫秒级的实时同步需求。
- 依赖环境:必须在Hadoop集群上运行,对单机环境不友好。
Spark SQL:灵活高效的现代方案
随着Spark成为大数据事实标准,越来越多的团队选择使用Spark SQL进行数据迁移,Spark基于内存计算,速度比传统的MapReduce快得多,且API更加友好。
Spark SQL的操作逻辑
使用Spark SQL导出MySQL,通常涉及两个步骤:首先从Hive读取数据生成DataFrame,然后利用jdbc写入MySQL,这种方式代码简洁,易于集成到现有的Spark作业中。
- 读取Hive数据:通过
spark.sql("SELECT FROM hive_table")获取数据。 - 写入MySQL:配置JDBC URL、用户名、密码,并指定表名和写入模式(如Append或Overwrite)。
Spark SQL的优势
- 统一引擎:无需额外部署Sqoop,利用现有的Spark集群即可完成。
- 灵活性强:可以在写入前进行复杂的数据清洗和转换。
- 容错性好:Spark的RDD机制提供了强大的容错能力,任务失败可自动重试。
实操指南:Sqoop导出命令详解
对于大多数需要处理大规模历史数据的场景,Sqoop依然是首选,以下是使用Sqoop将Hive表数据导出到MySQL的标准操作流程。
前置准备

在运行命令前,请确保以下环境已就绪:
- Hadoop集群正常运行。
- MySQL数据库已创建目标表,且表结构与Hive表字段对应。
- MySQL的JDBC驱动jar包已放置在Hadoop集群各节点的
$HADOOP_HOME/lib目录下。 - 拥有MySQL数据库的写入权限。
核心命令示例
假设我们要将Hive数据库dw下的表user_behavior导出到MySQL数据库bi下的表user_behavior_mysql。
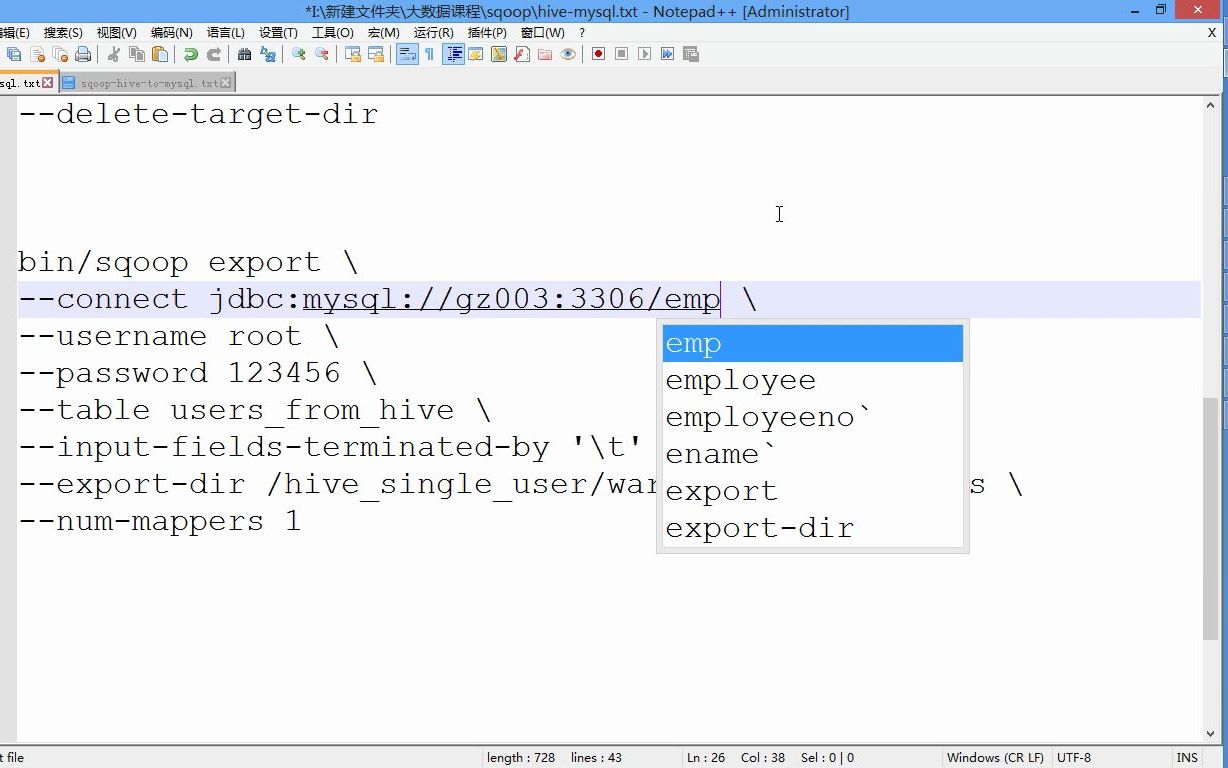
sqoop export
--connect jdbc:mysql://mysql-host:3306/bi
--username root
--password your_password
--table user_behavior_mysql
--export-dir /user/hive/warehouse/dw.db/user_behavior
--input-fields-terminated-by '01'
--input-lines-terminated-by 'n'
-m 5
参数解析
--connect:指定MySQL的连接字符串,注意IP地址和端口。--table:指定MySQL中的目标表名。--export-dir:指定Hive中数据的HDFS路径,注意不要带引号内的通配符,直接指向目录。--input-fields-terminated-by:指定Hive数据文件中的字段分隔符,默认为01(Ctrl+A),需与Hive表定义一致。-m 5:指定并行度,即启动5个Map任务,根据数据量和集群资源调整,一般建议不超过10,以免压垮MySQL。
性能优化与避坑指南
数据导出不仅仅是命令的执行,更是对系统资源的精细管理,在实际生产环境中,以下几个细节往往决定了任务的成败。
MySQL端优化
MySQL在处理大批量插入时,性能瓶颈通常在于磁盘IO和事务日志。
- 关闭索引:在导入前,如果数据量极大,可以考虑暂时禁用目标表的索引,导入完成后再重建,虽然这增加了导入时间,但能显著减少磁盘随机写。
- 调整事务:将
autocommit设置为false,并适当增大innodb_buffer_pool_size,以减少事务刷盘频率。 - 批量提交:Sqoop默认会批量提交数据,可通过
--batch参数启用JDBC批量模式,大幅提升写入效率。

Hive端优化
- 数据倾斜处理:如果Hive表存在严重的数据倾斜,Sqoop的并行导入可能导致某些节点负载过高,建议在导出前对数据进行预聚合或重新分区。
- 小文件合并:Hive中可能存在大量小文件,这会拖慢Map任务启动速度,建议在导出前执行
MSCK REPAIR TABLE或使用concatenate命令合并小文件。
网络与防火墙
确保Hadoop集群节点与MySQL服务器之间的网络畅通,防火墙规则需开放MySQL端口(默认3306),如果集群跨机房,需评估网络带宽,必要时使用专线或压缩传输。
常见问题解答
Hive导出MySQL时出现中文乱码怎么办?
乱码通常由字符集不一致引起,Hive默认使用UTF-8,而MySQL默认可能是Latin1,解决方法是在MySQL建表时明确指定CHARSET=utf8mb4,并在Sqoop连接字符串中添加?useUnicode=true&characterEncoding=UTF-8,检查Hive表的存储格式是否为TextFile或ORC,确保编码统一。
Sqoop导出速度慢,如何提升?
提升Sqoop导出速度的核心在于增加并行度-m,但需监控MySQL负载,如果MySQL已成为瓶颈,可尝试以下措施:1. 增加--batch参数启用批量插入;2. 临时关闭MySQL的Binlog(仅限测试环境);3. 将数据先导出到HDFS的Parquet格式,再通过Spark SQL写入MySQL,利用Spark的内存计算优势。
如何实现增量导出?
Sqoop支持基于时间戳或自增ID的增量导入,使用--incremental append参数,并指定--check-column(检查列,如create_time)和--last-value(上次同步的最大值),每次任务执行后,需手动更新last-value为当前最大值,或编写脚本自动获取,这种方式能避免重复导入,节省资源。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/453563.html



评论列表(1条)
笑死,又来这套“核心方案是Sqoop或Spark”——你管这叫核心?Sqoop连decimal精度都搞不定,上次导个hi