处理规则引擎大批量数据的核心在于将“实时计算”与“批量批处理”解耦,通过预计算、异步队列和分布式架构,在毫秒级响应与高吞吐量之间找到平衡点,避免系统因数据洪峰而崩溃。
在数字化业务飞速发展的今天,企业面临的挑战不再是缺乏数据,而是如何高效处理海量数据,当规则引擎需要面对百万级甚至亿级的数据流时,传统的串行处理模式往往力不从心,业内专家指出,构建高可用的大批量数据处理体系,关键在于架构设计的合理性与技术选型的精准度。
规则引擎大批量数据处理的核心痛点
许多企业在初期搭建规则引擎时,往往忽视了数据规模带来的性能瓶颈,当数据量从千级跃升至百万级时,系统延迟会呈指数级增长,这种性能衰减主要体现在以下几个方面:
- 内存溢出风险:规则匹配过程需要加载大量上下文数据,若未进行有效的内存管理,极易导致JVM堆内存溢出。
- CPU资源争抢:复杂的逻辑判断和正则表达式匹配会消耗大量CPU周期,导致其他业务线程阻塞。
- I/O读写瓶颈:频繁的数据查询和状态更新会导致磁盘I/O成为系统短板,尤其是在关系型数据库中直接进行复杂规则运算时。
实时流与批量批处理的界限模糊
在实际场景中,用户常混淆实时流处理与批量批处理的适用场景,实时流处理侧重于低延迟,适合风控、即时推荐等场景;而批量批处理侧重于高吞吐,适合账单生成、报表统计等场景,混淆两者会导致资源浪费或性能不足。
典型场景对比分析
| 场景类型 | 数据特征 | 延迟要求 | 推荐架构 |
|---|---|---|---|
| 实时风控 | 单条独立,高频触发 | < 100ms | 内存缓存+轻量级规则引擎 |
| 批量营销 | 百万级并发,逻辑复杂 | 分钟/小时级 | 分布式计算框架+异步队列 |
| 对账清算 | 数据量大,一致性要求高 | T+1或实时 | 分布式数据库+并行处理引擎 |

优化大批量数据处理的架构策略
要解决规则引擎在大批量数据下的性能问题,必须从架构层面进行重构,核心思路是将计算逻辑与数据访问分离,利用分布式能力分摊压力。
引入预计算与缓存机制
预计算是提升批量处理效率最有效的手段之一,对于相对静态的规则或数据,可以在非高峰时段提前完成计算,并将结果存入高速缓存。
- 规则静态化:将不频繁变化的规则配置编译为字节码或中间表示形式,避免每次运行时重新解析。
- 热点数据缓存:利用Redis或本地缓存存储高频访问的基础数据,减少数据库查询次数。
- 结果集复用:对于相同条件的多次查询,缓存结果集,避免重复计算。
异步化与削峰填谷
面对突发的大批量数据请求,同步处理会导致系统雪崩,引入消息队列(如Kafka、RabbitMQ)可以实现异步解耦。
- 数据接入层:接收前端或上游系统的数据请求,快速写入消息队列后立即返回响应。
- 消费处理层:后台服务从队列中拉取数据,按照批次进行规则匹配和处理。
- 结果回写层:处理完成后,将结果异步写回数据库或推送给前端。
这种模式虽然增加了系统的复杂度,但显著提升了系统的吞吐量和稳定性,据统计,采用异步架构后,多数企业的系统吞吐量提升了数倍。

分布式并行计算
单节点的性能上限是有限的,分布式并行计算是突破瓶颈的必经之路。
- 数据分片:将大批量数据按照特定键值(如用户ID、订单号)进行分片,不同分片由不同的节点独立处理。
- 规则广播:将规则配置广播到所有计算节点,确保每个节点都能执行完整的规则逻辑。
- 结果聚合:各节点处理完成后,将结果汇总至主节点或存储层。
技术选型与落地实操指南
选择合适的技术栈是落地大批量数据处理的关键,不同的场景适合不同的工具组合。
规则引擎选型对比
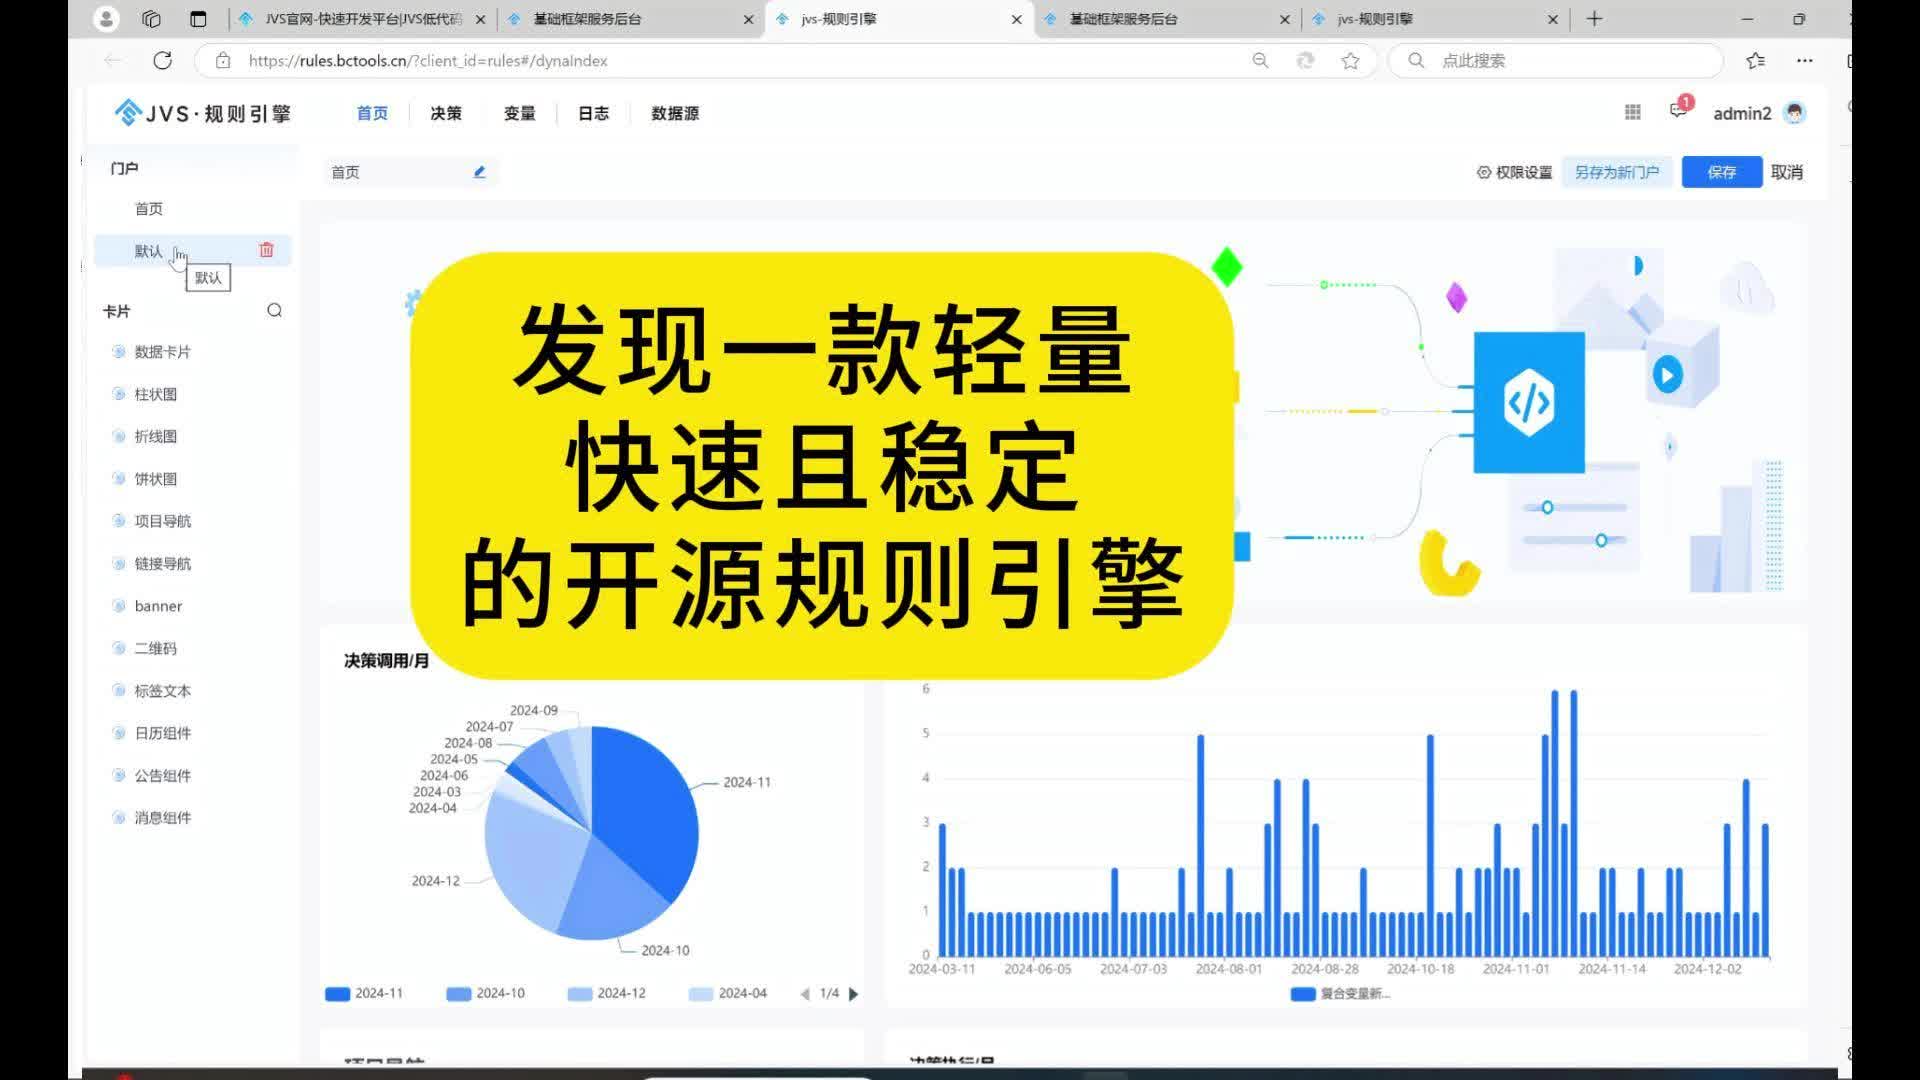
市面上常见的规则引擎包括Drools、EasyRules、Aviator等,在大批量数据场景下,选型需重点关注执行效率和资源消耗。
- Drools:功能强大,支持复杂规则建模,但启动慢、内存占用高,适合规则复杂且数据量中等的场景。
- EasyRules:基于注解,轻量级,启动快,适合规则简单、追求快速迭代的场景。
- Aviator:高性能表达式引擎,执行速度快,内存占用低,适合对性能要求极高的实时计算场景。
业内共识认为,对于纯表达式计算,Aviator等轻量级引擎表现更佳;而对于涉及复杂对象关系和状态管理的场景,Drools仍是主流选择。
大数据处理框架集成
当数据量达到TB级别时,单纯依靠规则引擎已无法胜任,需集成大数据处理框架。
- Spark:适合离线批量处理,支持复杂的迭代计算,可通过Spark SQL或DataFrame API集成规则逻辑。
- Flink:适合流批一体处理,支持低延迟的实时规则计算,适合需要实时反馈的场景。
- Hive/Impala:适合基于SQL的规则过滤,适合数据仓库中的批量数据清洗和转换。
实操步骤:基于Spark的规则批量处理
- 数据加载:使用Spark SQL从HDFS或Hive表中加载数据。
- UDF注册:将规则逻辑封装为Spark UDF(用户自定义函数)。
- 规则应用:在DataFrame API中调用UDF进行列计算或行过滤。
- 结果保存:将处理后的结果保存至目标存储系统。

常见误区与避坑指南
在实施过程中,许多团队容易陷入一些常见误区,导致项目失败或性能不达标。
过度依赖数据库
将复杂的规则逻辑写在SQL中,导致数据库CPU飙升,查询缓慢,规则引擎应专注于逻辑判断,而非数据存取。
忽视监控与告警
大批量处理任务往往运行时间长,缺乏有效的监控会导致故障发现滞后,必须建立完善的监控体系,包括任务进度、错误率、资源使用率等指标。
规则版本管理混乱
规则频繁变更且缺乏版本控制,导致线上故障难以追溯,应建立规则版本管理机制,确保每次变更可回滚、可审计。
规则引擎大批量数据Q&A
规则引擎大批量数据处理的成本如何控制?
控制成本的核心在于资源利用率优化,通过弹性伸缩技术,在高峰时段自动增加计算节点,低谷时段释放资源,可显著降低云服务器成本,采用开源规则引擎和大数据框架,可避免高昂的商业软件授权费用,据行业数据显示,合理架构设计可使基础设施成本降低30%以上。
如何处理规则引擎大批量数据中的脏数据?
脏数据会导致规则匹配失败或结果错误,应在数据接入层建立清洗机制,包括格式校验、空值处理、异常值过滤等,对于无法清洗的数据,应建立死信队列进行隔离和人工复核,确保主流程不受影响。
规则引擎大批量数据与实时数据混合处理可行吗?
可行,但需采用流批一体架构,利用Flink等支持流批一体的引擎,可将实时数据流和批量数据源统一接入,通过时间窗口和状态管理实现混合处理,这种架构既保证了实时性,又兼顾了批量处理的效率,是当前大数据架构的主流趋势。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/458249.html