Hive实时写入数据库的核心方案是通过Spark Streaming或Flink将Hive数据流式抽取,经清洗后通过JDBC或Kafka Connect实时同步至MySQL、PostgreSQL等关系型数据库,从而打破离线数仓的延迟瓶颈,实现分钟级甚至秒级的数据一致性。
传统Hive作为基于HDFS的离线数仓,其核心优势在于处理PB级历史数据的批量计算,但面对需要即时决策的业务场景,如实时风控、动态库存扣减或用户行为即时分析,Hive原本的T+1或小时级延迟成为了明显的短板,业内专家指出,随着实时计算引擎的成熟,将Hive中的高价值数据实时“推”出去,已成为构建现代数据架构的关键一环,这并非简单的数据搬运,而是一场关于数据时效性与系统稳定性的技术博弈。

为什么需要打破Hive的离线边界?
在许多企业的实际业务中,数据产生与数据使用之间存在巨大的时间差,电商平台的订单数据在Hive中完成T+1汇总后,运营团队看到的昨日销售报表往往无法指导当天的即时促销策略,这种滞后性导致了两个主要痛点:一是业务响应速度慢,错失市场机会;二是数据孤岛效应加剧,实时流数据与离线批数据难以融合。
实时同步的典型应用场景
为了更直观地理解需求,我们可以看几个具体的业务场景:
- 实时大屏展示:管理层需要看到当前时刻的GMV(商品交易总额)、活跃用户数等核心指标,这些数据源往往来自Hive中经过复杂ETL清洗后的宽表。
- 精准营销推送:当用户在Hive中被标记为“高潜流失用户”时,系统需要立即触发短信或APP推送,这要求用户标签数据能实时同步至营销系统的数据库。
- 跨库数据一致性:在微服务架构下,核心交易数据存储在MySQL中,而历史分析数据在Hive中,当需要对历史订单进行实时关联分析时,双向或单向的实时同步成为必要手段。
主流技术架构对比与选型
实现Hive数据实时写入关系型数据库,目前业界主要有三种主流技术路径,每种路径都有其适用的边界,选择时需结合数据量级、延迟要求及运维成本综合考量。
基于Spark Streaming/Flink的自研管道
这是灵活性最高、可控性最强的方案,通过编写Spark Structured Streaming或Flink SQL作业,直接读取Hive表(通常借助Hive Metastore或Iceberg/Hudi等现代数据湖格式),在内存中进行实时计算和转换,最后通过JDBC Sink写入目标数据库。

- 优势:逻辑完全自定义,可处理复杂的业务规则清洗;延迟可控制在秒级甚至毫秒级。
- 劣势:开发和维护成本高,需要团队具备较强的Java/Scala或SQL编程能力;需自行处理背压(Backpressure)、Exactly-Once语义及故障恢复。
- 适用场景:数据逻辑复杂、对延迟极度敏感、且拥有成熟数据工程团队的企业。
基于Kafka Connect的CDC与批量混合方案
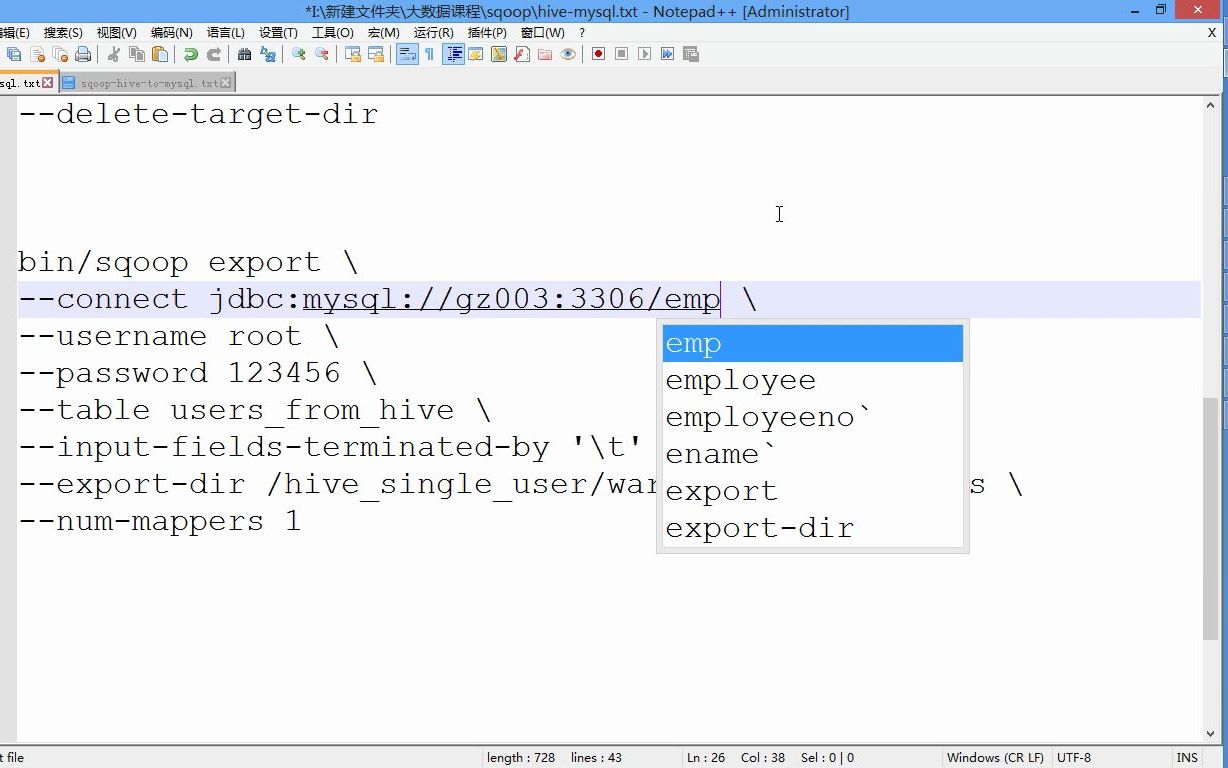
此方案通常结合Kafka作为消息缓冲层,对于Hive,由于原生不支持类似MySQL Binlog的变更数据捕获(CDC),通常采用“增量导出+Kafka”的模式,使用Sqoop或DataX定期将Hive增量数据导出为JSON/CSV文件,上传至对象存储,再由Flink实时消费这些文件并写入Kafka,最后通过Kafka Connect的JDBC Sink写入数据库。
- 优势:解耦性强,Kafka作为缓冲层可应对流量峰值;生态丰富,组件成熟稳定。
- 劣势:架构链路较长,端到端延迟通常在分钟级;配置复杂,需维护多个组件的健康状态。
- 适用场景:数据量巨大、允许分钟级延迟、追求系统高可用性的中大型平台。
使用商业数据集成工具
如阿里云DataWorks、酷番云DTS或Informatica等商业平台,提供了可视化的实时同步任务配置界面,这些工具底层封装了复杂的引擎逻辑,用户只需配置源端(Hive)和目标端(MySQL/Oracle)即可。
- 优势:上手极快,运维成本低,提供监控告警和数据质量校验功能。
- 劣势:费用较高,按数据流量或实例规格收费;灵活性受限,复杂转换逻辑支持不如自研方案。
- 适用场景:预算充足、缺乏专职开发人力、追求快速上线的中小型企业。
实操中的关键挑战与解决方案
无论选择哪种方案,在将Hive数据实时写入数据库的过程中,都会遇到几个共性的技术难题,解决这些问题是确保系统稳定运行的关键。
数据格式兼容与类型映射
Hive支持的数据类型(如Array、Map、Struct)与关系型数据库(如MySQL)存在巨大差异,直接写入会导致报错。
- 解决方案:在ETL层进行扁平化处理,将Hive中的

Array<String>
"a,b,c"存入MySQL的VARCHAR字段;将Map转换为JSON字符串存入TEXT字段,务必在写入前进行类型强校验,避免脏数据导致数据库事务回滚。

幂等性设计与重复数据问题
实时流处理中,网络抖动或重启可能导致消息重复消费,如果直接执行INSERT,会导致目标数据库出现重复记录。
- 解决方案:采用
INSERT INTO ... ON DUPLICATE KEY UPDATE(MySQL)或MERGE INTO(Oracle/SQL Server)语句,确保目标表有唯一主键,通过主键冲突更新而非插入,保证数据的最终一致性。
写入性能与数据库瓶颈
关系型数据库在处理高并发写入时,I/O和锁竞争是主要瓶颈,如果Hive数据量极大,直接实时写入可能导致目标库CPU飙升甚至宕机。
- 解决方案:
- 批量提交:不要逐条写入,而是积攒一定数量(如1000条)或时间间隔(如1秒)后批量提交事务。
- 异步写入:在应用层使用线程池异步执行JDBC写入,避免阻塞主处理流。
- 分库分表:对于超大规模数据,目标库应提前规划好分片策略,根据业务ID哈希分散写入压力。
成本评估与长期维护建议
在决定实施Hive实时同步方案前,必须对TCO(总拥有成本)有清晰认知,这不仅包括服务器资源成本,还涉及人力维护成本。
资源成本对比
| 方案类型 | 硬件资源需求 | 人力维护成本 | 数据延迟 | 适用数据规模 |
|---|---|---|---|---|
| 自研Spark/Flink | 高(需独立集群) | 高(需专业开发) | 秒级 | 千万级/天 |
| Kafka Connect | 中高(需Kafka集群) | 中(需运维支持) | 分钟级 |
亿级/天 |
| 商业工具 | 低(托管服务) | 低(配置即可) | 分钟级 | 千万级/天 |

据工信部及相关行业数据显示,近年来超过半数的中大型企业开始从纯离线架构向流批一体架构转型,其中实时数据同步模块的投入占比逐年上升。
长期维护建议
- 监控告警:建立完善的监控体系,关注延迟时间(Lag)、错误率、吞吐量等核心指标,一旦延迟超过阈值(如5分钟),应立即触发告警。
- 数据质量校验:定期比对源端Hive表与目标库的数据总量和关键字段哈希值,确保数据在传输过程中未丢失、未篡改。
- 版本升级:Hive、Spark、JDBC驱动等组件版本迭代较快,需定期评估升级风险,避免兼容性问题导致同步中断。
Q&A:Hive实时写入数据库常见疑问
Hive实时写入数据库的价格大概是多少?
成本因方案而异,自研方案主要涉及云服务器或物理机租赁费用,初期投入较低但人力成本高;商业工具通常按数据流量(GB/TB)或实例规格收费,每月费用可能在数百至数万元不等,具体取决于数据量和并发要求,对于初创团队,建议先使用开源方案验证可行性,再根据规模迁移至商业服务。
如何解决Hive数据实时同步到MySQL的延迟问题?
延迟主要来源于Hive本身的查询性能、网络传输及数据库写入速度,优化建议包括:使用Hive on Tez或Spark SQL替代MR引擎加速查询;启用Kafka作为缓冲层平滑流量峰值;在MySQL端优化索引,避免全表扫描;采用批量插入而非单条插入,通过端到端调优,通常可将延迟控制在1-5分钟内,若需秒级延迟,需引入Flink等流式引擎并优化SQL逻辑。
Hive实时写入数据库与直接查询Hive相比有何优劣?
直接查询Hive适合离线分析,延迟高但成本低,适合T+1报表;实时写入数据库适合在线业务,延迟低但成本高,适合实时交互,若业务场景既需要实时性又需要复杂分析,建议采用“双写”策略或构建数据湖仓一体架构(如Hudi/Iceberg),在Hive层直接支持ACID事务和实时查询,从而避免冗余的数据同步链路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/458876.html