在Python中,将文件行数据转换为列表最标准且高效的方法是使用列表推导式配合open()函数读取文件,这能避免全量加载内存并支持逐行处理大文件。
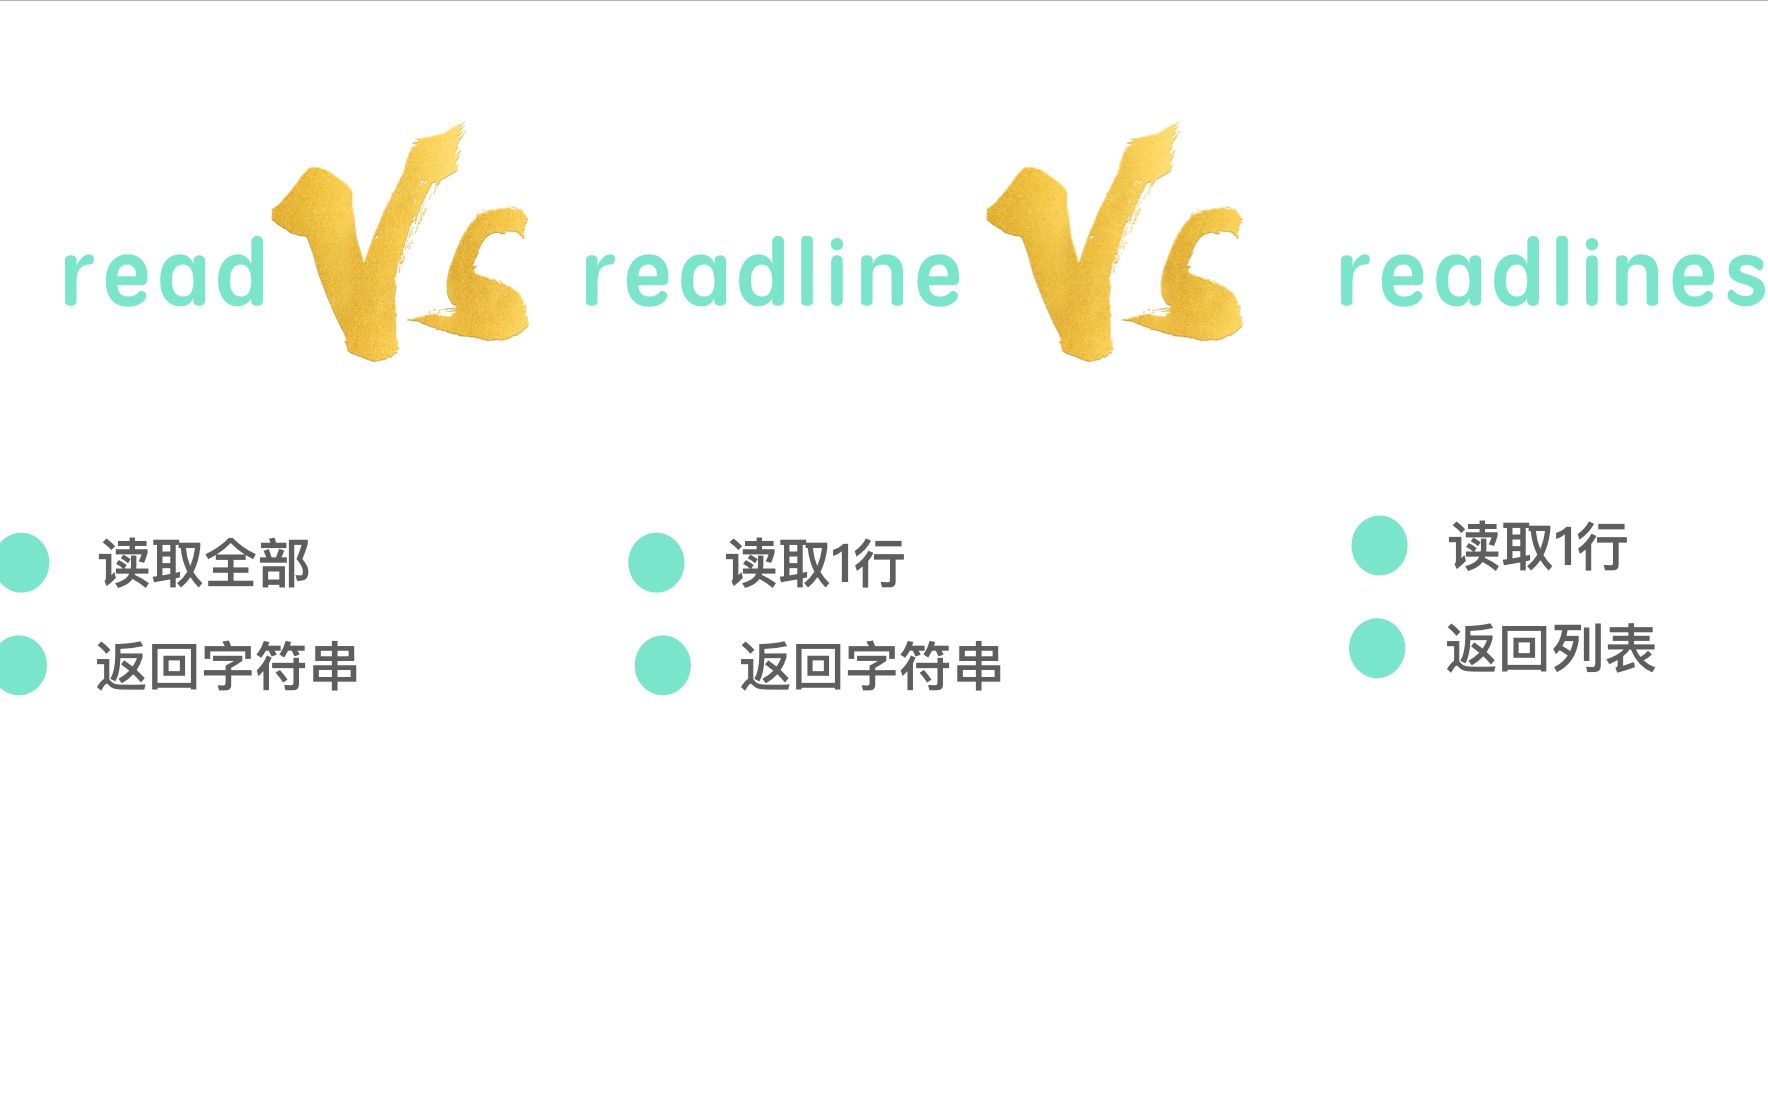
处理文本数据是Python开发中的高频场景,无论是日志分析、数据清洗还是简单的配置读取,把每一行文本变成列表元素都是基础操作,很多初学者习惯用readlines(),但在处理GB级别的大文件时,这种做法极易导致内存溢出,业内专家指出,采用迭代器方式读取文件不仅节省内存,还能显著提升IO效率,下面我们将深入探讨几种主流方案,并对比它们的适用场景。
python listfromline 核心实现方案解析
基础方法:readlines与strip清洗
这是最直观的方法,适合处理小型文本文件,代码逻辑简单,但存在明显的性能瓶颈。
with open('data.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()
    # 去除每行末尾的换行符
    clean_lines = [line.strip() for line in lines if line.strip()]
这种方法的问题在于readlines()会一次性将整个文件内容加载到内存中,如果文件只有几KB,这完全没问题,但一旦文件达到几百MB,程序可能会直接崩溃。strip()操作虽然能清理空白字符,但如果文件中包含大量空行,还需要额外的过滤逻辑。
进阶方案:列表推导式直接迭代
文件对象本身就是一个迭代器,这意味着我们可以直接遍历它,而不需要中间步骤,这种方式是Pythonic风格的典型代表。
with open('data.txt', 'r', encoding='utf-8') as f:
    # 直接遍历文件对象,每次只读取一行
    clean_lines = [line.strip() for line in f if line.strip()]
这种写法在内存占用上几乎可以忽略不计,因为它遵循惰性求值原则,只有当列表推导式执行时,才会逐行读取并处理数据,对于大多数日常脚本,这是首选方案。
处理复杂分隔符的情况
如果文件中的每一行包含多个字段,且需要用特定符号(如逗号、制表符)分割,单纯使用

strip()是不够的,此时需要结合split()方法。
with open('config.txt', 'r', encoding='utf-8') as f:
    # 假设每行格式为 key=value
    config_dict = {line.strip().split('=')[0]: line.strip().split('=')[1]
                   for line in f if '=' in line}
这种场景下,逻辑变得更加复杂,但核心思想不变:逐行读取,即时处理。
python listfromline 性能对比与选型指南
在实际项目中,选择哪种方法取决于数据量和后续处理需求,下表对比了三种常见方法的性能特征。
| 方法 | 内存占用 | 读取速度 | 适用场景 | 缺点 |
|---|---|---|---|---|
readlines() |
高 | 快 | 小文件 (<10MB) | 大文件易OOM |
| 迭代器+列表推导 | 低 | 中等 | 中等文件 (10MB-1GB) | 需构建完整列表 |
| 生成器表达式 | 极低 | 快 | 超大文件 (>1GB) | 只能遍历一次,不能索引 |
行业共识认为,对于超过1GB的文件,不应尝试将其全部加载到列表中,此时应使用生成器或逐行处理逻辑。
大文件处理的最佳实践
当面对海量数据时,构建完整的列表不仅浪费内存,还会增加GC(垃圾回收)的压力,正确的做法是使用生成器,或者在循环中直接处理每一行。

def process_large_file(filename):
    with open(filename, 'r', encoding='utf-8') as f:
        for line in f:
            # 在这里直接处理每一行,例如写入数据库或进行计算
            yield line.strip()
# 使用示例
for item in process_large_file('huge_log.txt'):
    if 'ERROR' in item:
        print(item)
这种模式在ETL(提取、转换、加载)流程中非常常见,它允许数据流式处理,无需等待整个文件读取完毕。
python listfromline 常见陷阱与优化技巧
编码问题导致的乱码
在处理来自不同来源的文件时,编码格式不一致是常见问题,Windows默认使用GBK,而Linux和现代编辑器多用UTF-8,如果在读取时未指定编码,可能会抛出UnicodeDecodeError。
# 推荐写法:始终显式指定编码
with open('data.txt', 'r', encoding='utf-8', errors='ignore') as f:
    lines = [line.strip() for line in f]
errors='ignore'参数可以在遇到无法解码的字符时跳过,而不是中断程序,这在处理脏数据时非常有用。
空行与特殊字符处理
原始数据中往往包含大量不可见字符,如rn、t等,单纯使用strip()可能无法完全清理所有空白。
import re
def clean_line(line):
    # 去除首尾空白,并将内部多个连续空格合并为一个
    return re.sub(r's+', ' ', line.strip())
with open('data.txt', 'r', encoding='utf-8') as f:
    clean_lines = [clean_line(line) for line in f if line.strip()]
这种预处理步骤在数据清洗阶段至关重要,能确保后续分析的准确性。
python listfromline 在特定框架中的应用
与Pandas结合使用
虽然Pandas有专门的read_csv或read_table函数,但在某些非标准格式文件中,手动解析行数据可能更灵活。
import pandas as pd
raw_data = []
with open('custom_data.txt', 'r', encoding='utf-8') as f:
    for line in f:
        parts = line.strip().split('|')
        if len(parts) == 3:
            raw_data.append({'col1': parts[0], 'col2': parts[1], 'col3': parts[2]})
df = pd.DataFrame(raw_data)

这种方法虽然比直接调用Pandas函数慢,但提供了极大的灵活性,特别是在处理格式混乱或非结构化数据时。
与异步IO结合
对于I/O密集型任务,结合aiofiles库可以实现异步读取,进一步提升吞吐量。
import aiofiles
async def read_lines_async(filename):
    async with aiofiles.open(filename, 'r', encoding='utf-8') as f:
        lines = [line async for line in f]
    return lines
这在Web服务器日志分析等场景下尤为有效,能够并发处理多个文件流。
python listfromline 相关问题解答
如何高效地将大文件行转为列表而不占用内存?
不要使用列表推导式构建完整列表,而应使用生成器表达式或直接在循环中处理,使用for line in f:逐行迭代,并在处理完每一行后立即释放引用,如果需要多次访问数据,建议将处理结果写入数据库或磁盘文件,而非保留在内存列表中。
Python读取文件行时遇到编码错误怎么办?
首先检查文件实际编码,可使用chardet库检测,在open()函数中指定正确的encoding参数,如utf-8或gbk,若仍报错,可添加errors='ignore'或errors='replace'参数,忽略或替换无法解码的字符,确保程序不中断。
listfromline操作在Windows和Linux下有何差异?
主要差异在于换行符的处理,Windows使用rn,Linux使用n,Python的open()函数默认以文本模式打开,会自动处理换行符转换,因此代码通常具有跨平台兼容性,但在处理二进制文件或特定格式文件时,需显式指定newline=''参数,以防止换行符被自动转换,确保数据一致性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/459327.html