Hive数据仓库的核心原理是将SQL查询转化为MapReduce、Tez或Spark等分布式计算任务,通过HDFS存储数据,实现海量数据的离线批处理分析。
很多人初次接触大数据时,都会产生一个疑问:明明Hadoop是分布式文件系统,为什么我们非要加一层Hive?Hive的本质并不是一个传统的关系型数据库,而是一个构建在Hadoop之上的数据仓库工具,它最大的价值在于提供了一套类似SQL的语言(HiveQL),让那些熟悉SQL但不精通Java或MapReduce编程的数据分析师,也能轻松对存储在HDFS上的海量数据进行查询和分析。

Hive架构与核心组件解析
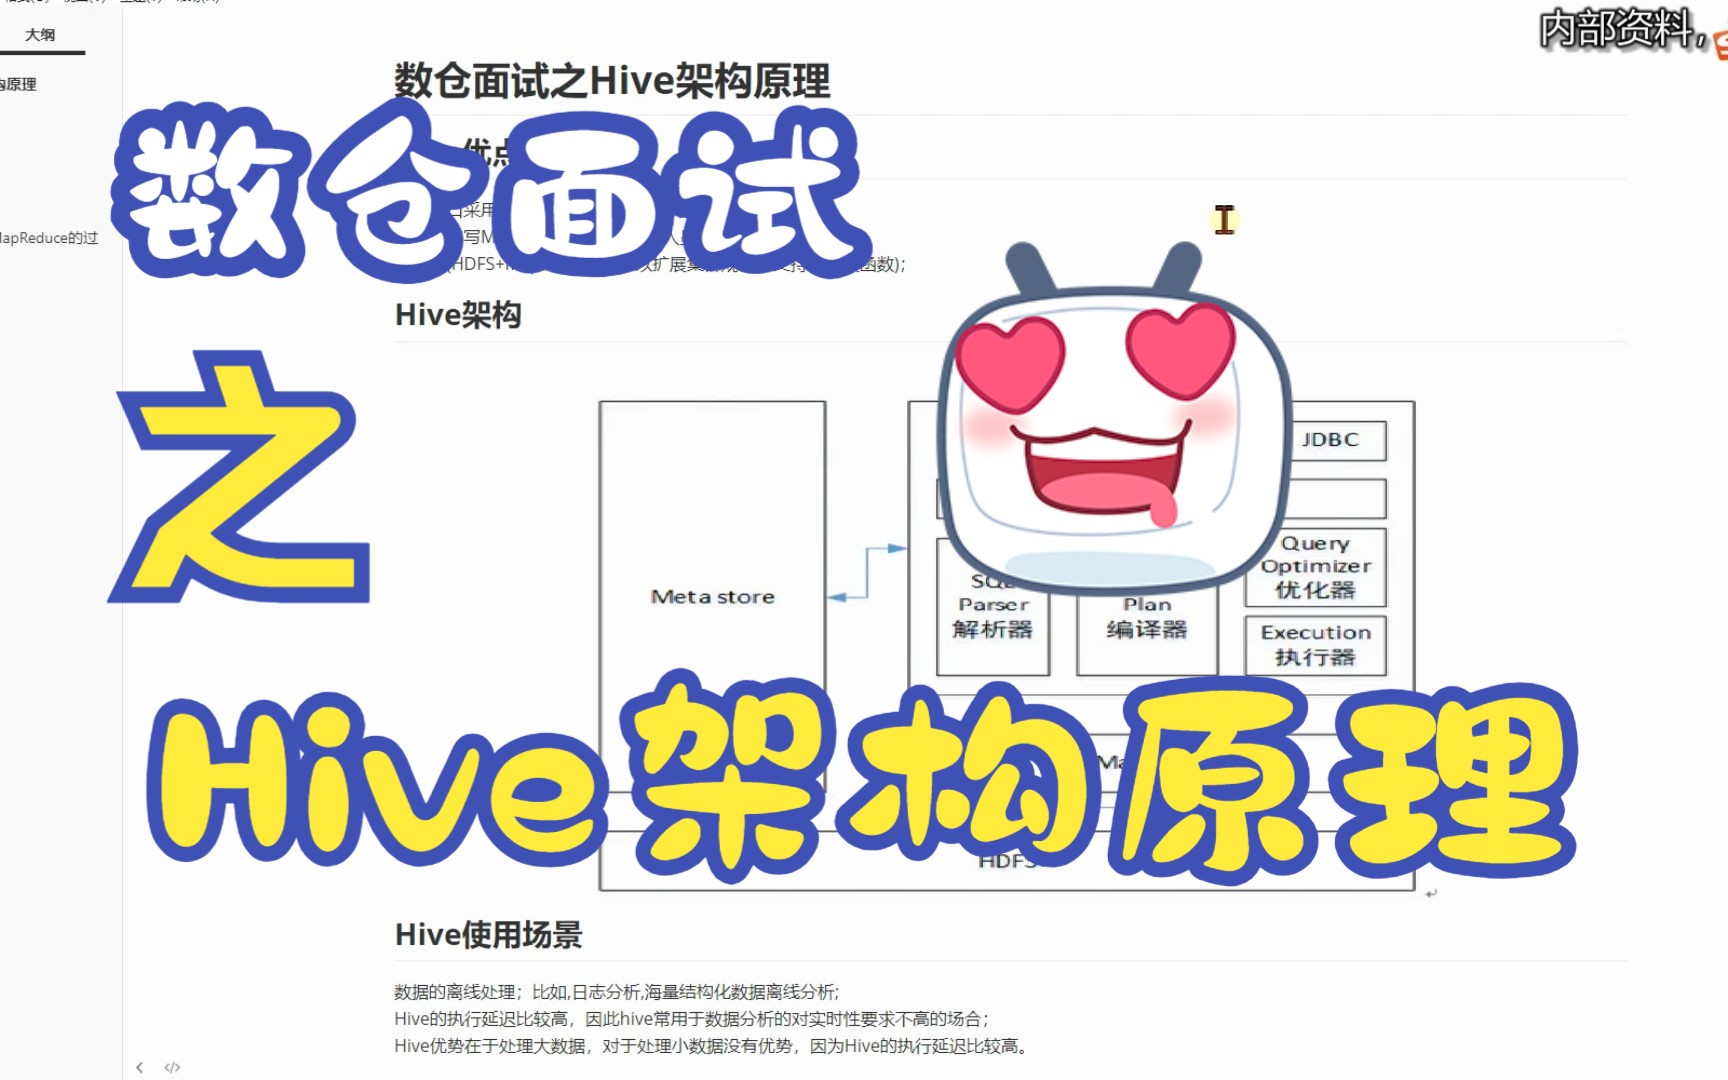
要理解Hive的工作原理,首先得看清它的“身体构造”,Hive的架构设计非常清晰,主要可以分为用户接口、驱动器(Driver)和元数据存储(Metastore)几个关键部分。
用户接口层:连接人与数据的桥梁
用户通过不同的接口与Hive进行交互,这些接口决定了你如何向Hive下达指令。
- CLI(命令行接口):这是最基础的交互方式,适合脚本自动化操作和简单的调试。
- Web UI:早期的Hue或Hive Web Interface,提供可视化的查询界面,方便非技术人员查看结果。
- JDBC/ODBC驱动:这是企业级应用中最常用的方式,BI工具(如Tableau、FineBI)或Java应用程序通过驱动连接Hive,实现数据可视化或报表生成。
驱动器(Driver):任务的调度中心
当用户提交一个HQL查询时,Driver是真正的“大脑”,它负责处理整个查询的生命周期,具体包括以下四个步骤:
- 语法分析:检查SQL语句是否符合HiveQL语法规范。
- 编译:将HQL语句转换为一个逻辑执行计划。
- 优化:这是关键步骤,Hive会对逻辑计划进行优化,比如谓词下推、列裁剪等,以减少后续计算的数据量。
- 生成执行计划:将优化后的逻辑计划转化为物理执行计划,通常是MapReduce、Tez或Spark作业。

元数据存储(Metastore):数据的目录索引
Metastore是Hive的“图书馆管理员”,它存储了表的结构信息(Schema)、分区信息、列类型等元数据,默认情况下,Metastore使用Derby数据库存储,但在生产环境中,几乎都会配置为MySQL或PostgreSQL,以支持多用户并发访问和高可用性。
数据执行流程:从SQL到分布式计算
理解了架构,我们再来看看一条SQL语句在Hive内部是如何“跑”起来的,这个过程是Hive实现“SQL-on-Hadoop”的核心机制。
解析与编译
当你输入SELECT FROM user_info WHERE age > 20;时,Hive编译器首先会将这段SQL解析成语法树,然后生成一个逻辑执行计划,Hive已经知道了需要从哪个表读取哪些列,以及过滤条件是什么。
优化与物理计划生成
在生成物理计划前,Hive会进行一系列优化,如果查询中只使用了age字段,Hive会进行列裁剪,只读取HDFS上age对应的文件块,而不是读取整行数据,如果查询涉及多个表的Join,Hive会根据数据倾斜情况和连接类型,选择最优的Join策略(如Map Join或Reduce Join)。
任务提交与执行
优化后的物理执行计划被提交给Hadoop集群的执行引擎,这里需要特别注意,Hive本身不执行计算,它只是生成任务,目前主流的三种执行引擎各有优劣:
- MapReduce:Hive最初支持的引擎,稳定性高,但磁盘I/O开销大,执行速度慢。
- Tez:专为Hive设计的图执行引擎,减少了中间结果的落盘,速度比MapReduce快数倍,适合交互式查询。
- Spark:基于内存的计算引擎,速度极快,适合复杂的多轮迭代计算,是目前大数据生态中最流行的选择。

存储与计算分离:HDFS的角色
Hive的数据并不存储在Hive内部,而是存储在HDFS(Hadoop Distributed File System)上,这种“存算分离”的设计带来了极大的灵活性。
文件格式的选择
在HDFS上,Hive支持多种文件格式,不同的格式适用于不同的场景,业内专家指出,选择合适的文件格式可以显著提升查询性能。
- TextFile:默认格式,存储占用空间大,解析速度慢,但兼容性最好。
- SequenceFile:二进制格式,支持压缩,适合存储大量小文件,但不支持按行分割。
- Parquet:列式存储格式,支持高效的压缩和编码,在Hive数据仓库的工作原理中,Parquet是OLAP分析场景的首选,因为它能大幅减少I/O开销。
- ORC:Optimized Row Columnar,是Parquet的改进版,由Apache Hive团队开发,性能更优,支持更复杂的索引。
分区与分桶:加速查询的利器
面对PB级数据,全表扫描是灾难性的,Hive通过分区和分桶来优化查询效率。
- 分区(Partition):类似于文件系统的目录,将数据按
dt=20260101进行分区,查询时只需扫描特定分区,避免全表扫描。 - 分桶(Bucket):对数据进行哈希取模,将数据分散到固定数量的文件中,分桶主要用于提高Join效率和支持采样查询。
常见应用场景与最佳实践
Hive主要应用于离线数据分析、ETL处理和报表生成,对于hive数据仓库优化技巧,以下几点是业内共识认为必须遵守的最佳实践。
数据倾斜处理
数据倾斜是指某些Reduce任务处理的数据量远大于其他任务,导致整体作业卡顿,常见解决方案包括:
- 开启Map端聚合:通过设置
hive.map.aggr=true
,在Map端预先进行局部聚合,减少Shuffle数据量。
- 空值过滤:如果Join键中存在大量NULL值,会导致所有NULL值被发送到同一个Reduce,可以通过给NULL值添加随机前缀,将其分散到不同的Reduce。
- 使用Map Join:对于小表Join大表的场景,将小表加载到内存中,避免Shuffle。

小文件合并
HDFS不适合存储大量小文件,因为NameNode的内存消耗巨大,在ETL过程中,应定期合并小文件,可以通过设置hive.merge.mapfiles和hive.merge.mapredfiles参数,在Map或Reduce任务结束后自动合并输出文件。
Q&A:关于Hive数据仓库工作原理的常见疑问
Hive与传统关系型数据库(RDBMS)有什么区别?
Hive和RDBMS在设计目标上完全不同,RDBMS强调ACID事务、低延迟查询和在线事务处理(OLTP),适合高频短查询,而Hive强调高吞吐、离线批处理和可扩展性,适合海量数据的复杂分析,Hive不支持行级更新和删除,事务支持也较为有限(仅在某些配置下支持),Hive通常用于数据仓库的底层存储和分析层,而非在线业务系统。
Hive在2026年的技术演进趋势是什么?
随着实时性需求的提升,纯离线的Hive正逐渐与流式计算框架融合,Apache Iceberg和Hudi等表格格式的出现,使得Hive能够支持ACID事务、时间旅行和数据更新,弥补了传统Hive的短板,Serverless架构的引入,使得Hive的启动速度更快,资源弹性更好,进一步降低了使用门槛。
如何判断我的查询是否触发了数据倾斜?
在YARN或Tez UI中,如果某个作业的执行时间远长于其他作业,且进度条卡在99%左右,通常意味着发生了数据倾斜,观察Reduce任务的TaskTracker,如果发现少数几个Task处理的数据量远超平均水平,即可确认为数据倾斜,此时应检查Join键的分布情况,并应用上述优化策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/459389.html