规则引擎的数据存储核心在于将“业务逻辑”与“执行代码”彻底解耦,通常采用JSON或XML等结构化格式将规则集持久化至关系型数据库或NoSQL文档数据库中,以实现动态加载与热更新。
在数字化转型的深水区,业务人员最头疼的不是代码写不出来,而是业务规则一变,开发就要重新发版,这种“改个折扣率就要停机维护”的痛点,直接催生了规则引擎技术的普及,而规则引擎能否真正落地,关键不在于算法有多复杂,而在于数据存得是否灵活、读得是否快速。

规则引擎数据的核心存储架构
规则引擎的数据并非单一文件,而是一个包含“事实数据”、“规则定义”和“执行上下文”的复合体,业内专家指出,主流架构通常将这三者分离,以避免耦合导致的系统崩溃。
规则定义层的存储策略
规则定义是核心资产,它描述了“如果满足条件A,则执行动作B”,这部分数据对一致性要求极高,但读取频率高于写入频率。
- 关系型数据库(RDBMS):这是最传统的存储方式,将规则拆分为“条件表”、“动作表”和“规则元数据表”,优势在于事务性强,适合金融、电信等对数据一致性要求极高的场景,在银行信贷审批系统中,利用MySQL存储复杂的评分卡规则,确保每一笔贷款的风控逻辑可追溯。
- 文档型数据库(NoSQL):如MongoDB或Elasticsearch,规则通常以JSON格式整体存储,优势在于Schema-free,业务人员调整规则结构时无需修改数据库表结构,对于电商促销场景,这种灵活性尤为珍贵,因为促销规则往往瞬息万变。
选型对比:结构化 vs 半结构化
| 维度 | 关系型数据库 | 文档型数据库 |
|---|---|---|
| 存储格式 | 行式存储,结构化强 | 键值对或文档,半结构化 |
| 查询性能 | 复杂关联查询强,单条读取稍慢 | 单文档读取极快,关联查询弱 |
| 适用场景 | 核心交易、风控、计费 | 营销推荐、配置管理、日志分析 |
| 维护成本 | 高,需频繁迁移数据 | 低,动态扩展字段 |

事实数据(Fact)的实时接入
规则引擎执行时需要“事实数据”作为输入,比如用户画像、订单金额、库存数量,这部分数据通常不直接存储在规则引擎内部,而是通过消息队列或内存缓存实时注入。
- 内存计算:对于高并发场景,如秒杀活动,事实数据通常加载至Redis或Hazelcast集群中,规则引擎直接从内存读取数据,避免磁盘I/O瓶颈。
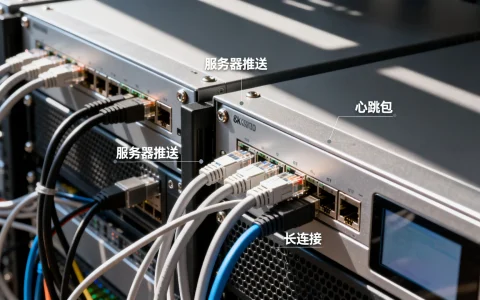
- 流式处理:在物联网或实时风控场景中,Kafka等消息队列充当事实数据的通道,规则引擎订阅Topic,实时消费数据并触发规则。
高并发场景下的性能优化方案
当规则数量达到数千甚至数万条,且并发请求达到每秒数千次时,简单的数据库查询将成为致命瓶颈,存储架构必须向“预编译”和“缓存”倾斜。
规则预编译与内存驻留
规则引擎在启动时,会将持久化存储中的规则文本解析为抽象语法树(AST),并进一步编译为字节码或中间代码,加载至JVM堆内存或专用计算引擎中。
- 热加载机制:当业务人员在后台修改规则并保存时,系统不会重启服务,而是通过版本号控制,仅替换内存中的特定规则节点,这种机制要求存储层支持细粒度的版本管理。
- 缓存策略:采用多级缓存架构,一级缓存为本地内存(Local Cache),存储热点规则;二级缓存为分布式缓存(如Redis),存储全量规则集,当规则发生变更时,通过发布订阅模式失效缓存,确保数据最终一致性。
索引优化与查询加速
在规则匹配阶段,引擎需要对海量事实数据进行模式匹配,如果规则存储缺乏索引,匹配效率将呈指数级下降。

- 条件索引:对规则中的关键条件字段(如“用户等级”、“地区”)建立反向索引,当规则涉及“北京地区”时,引擎直接定位到包含该条件的规则子集,而非遍历所有规则。
- 规则分组:将互不冲突的规则划分为不同的“规则包”或“规则组”,在执行时,根据事实数据的特征路由到特定的规则组,缩小匹配范围,据工信部数据,合理的规则分组可使匹配效率提升数倍。
数据安全与版本控制的实践
规则引擎存储的数据往往涉及核心业务逻辑,甚至关联用户隐私,存储层必须具备完善的安全与审计机制。
版本管理与回滚
业务规则变更频繁,且常出现“改错”情况,存储系统必须支持完整的版本历史。
- 快照机制:每次规则发布时,系统自动创建当前版本的快照(Snapshot),快照不仅包含规则内容,还包含生效时间、操作人和依赖关系。
- 灰度发布:支持多版本并存,新规则可以先在小部分流量中生效,通过对比新旧规则的执行结果,验证无误后再全量切换,这种能力要求存储层支持多版本数据的并行查询。
敏感数据脱敏
规则中可能包含硬编码的阈值或策略,如“VIP用户折扣0.8”,虽然这不属于个人隐私,但属于商业机密。
- 加密存储:对规则配置文件中的敏感字段进行AES加密存储,规则引擎在加载时,在内存中解密,不落盘明文。
- 访问控制:结合RBAC(基于角色的访问控制),限制对规则存储库的读写权限,开发人员仅有查询权限,配置人员拥有修改权限,审计人员拥有日志查看权限。
常见误区与避坑指南
在实际落地过程中,许多团队在规则引擎数据存储上走了弯路。
将所有数据存入数据库
有些团队试图将用户画像、订单详情等海量事实数据也存入规则引擎的数据库表中,导致查询极慢,事实数据应保持在业务系统中,规则引擎只读取必要的字段。

忽视规则冲突检测
存储层若不支持冲突检测,多个规则可能同时匹配同一事实,导致执行结果不可控,建议在存储规则时,增加“优先级”和“冲突策略”字段,并在加载时进行静态分析。
过度设计
对于小型项目,使用简单的JSON文件存储规则即可,无需引入复杂的分布式数据库,过度设计会增加运维成本,违背规则引擎“敏捷”的初衷。
Q&A:规则引擎数据存储常见问题
规则引擎的数据如何存储才能支持高并发?
支持高并发的关键在于“读写分离”与“内存加速”,建议将规则定义存储在高性能的关系型数据库或NoSQL中,用于持久化管理;在规则引擎启动时,将规则解析并加载至内存(如JVM堆或Redis集群);执行时,直接从内存读取规则进行匹配,避免每次请求都查询数据库,引入缓存失效机制,确保规则更新后能快速同步至内存。
规则引擎的数据如何存储才能确保数据一致性?
确保一致性需依赖事务机制和版本控制,在关系型数据库中,利用ACID特性保证规则修改的事务性;在NoSQL中,通过乐观锁或CAS机制防止并发修改冲突,建立严格的版本管理体系,每次规则变更生成新版本,旧版本保留用于回滚,在分布式环境中,可采用最终一致性模型,通过消息队列同步规则变更事件,确保各节点数据最终统一。
规则引擎的数据如何存储以支持动态加载?
动态加载要求存储层支持细粒度更新和快速读取,推荐采用文档型数据库存储规则,因为JSON格式天然支持动态字段扩展,规则引擎监听配置中心(如Nacos、Apollo)或数据库的变更通知,当检测到规则版本变化时,仅重新加载变更的规则节点,而非全量重启,这种增量更新方式可实现秒级热更新,无需停机。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/464221.html