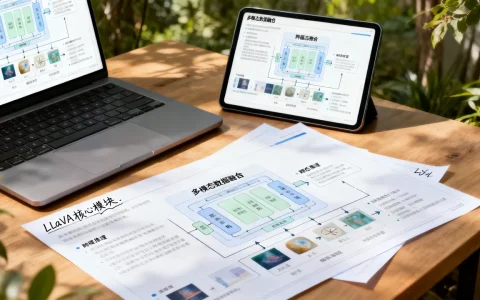
前端与机器学习的结合并非简单的技术堆砌,而是通过实时数据交互与智能算法,将静态页面转化为具备感知、决策能力的动态应用,从而显著提升用户体验与业务转化率。
过去,前端开发主要关注页面渲染、交互逻辑和视觉呈现,而机器学习往往被视为后端或数据科学家的专属领域,这种割裂导致了许多应用虽然拥有强大的后台算法,但在用户界面上却显得笨拙、滞后,随着WebAssembly、TensorFlow.js以及各类边缘计算框架的成熟,这一界限正在迅速消融,现在的开发者完全有能力在浏览器端直接运行轻量级模型,实现毫秒级的响应,这种转变不仅降低了服务器负载,更让应用具备了“本地智能”。

前端集成机器学习的技术路径解析
要实现这一目标,首先需要理解数据如何在浏览器中流动,传统做法是将用户数据发送至后端服务器,经过模型推理后再返回结果,这种方式延迟高,且涉及隐私合规风险,现代方案则倾向于在客户端进行推理。
客户端推理框架的选择与对比
目前主流的方案主要有三种:TensorFlow.js、ONNX Runtime Web和MediaPipe。
- TensorFlow.js:由Google开发,生态最完善,支持从Python模型转换而来,社区资源丰富,适合需要复杂自定义模型的场景。
- ONNX Runtime Web:微软主导的开放标准格式,优势在于跨框架兼容性,无论是PyTorch还是Caffe训练的模型,只要导出为ONNX即可运行,对于希望避免厂商锁定的团队来说是理想选择。
- MediaPipe:Google推出的专门用于构建多模态机器学习管道的库,它在手势识别、面部网格、物体检测等视觉任务上表现极佳,且经过高度优化,能在移动端流畅运行。

业内专家指出,选择框架时应优先考虑模型复杂度与目标设备的性能,对于简单的分类任务,TensorFlow.js足以胜任;而对于涉及大量图像处理的实时应用,MediaPipe提供了更开箱即用的解决方案。
数据预处理在前端的必要性
机器学习模型对输入数据有严格要求,在前端环境中,原始数据往往是像素、音频波形或传感器读数,必须经过标准化、归一化或特征提取才能输入模型。
图像数据的实时处理流程
以图像识别为例,前端获取摄像头视频流后,需执行以下步骤:
- 帧捕获:使用Canvas或Video元素截取当前帧。
- 尺寸调整:将图像缩放到模型接受的输入尺寸(如224×224像素)。
- 张量转换:将像素数据转换为Float32Array格式的张量,并归一化到0-1或-1到1区间。
这一过程若在后端完成,网络传输开销巨大,在前端完成,不仅节省带宽,还能保护用户隐私,因为原始图像数据无需离开用户设备。
实际应用场景与性能优化策略
技术落地的核心在于场景匹配,并非所有机器学习任务都适合前端运行,我们需要权衡计算成本与用户体验。
适合前端的典型场景
- 实时交互特效:如虚拟试衣、AR滤镜、手势控制游戏,这些场景要求极低延迟,任何网络波动都会导致体验断裂。
- 个性化推荐预览:根据用户鼠标轨迹或停留时间,实时调整页面内容布局,虽然最终推荐结果可能来自后端,但前端可以先提供即时反馈。
- 表单智能校验:在用户输入时,实时检测手写签名真伪或OCR识别身份证信息,减少提交后的等待时间。
性能瓶颈与优化手段
浏览器端的算力有限,尤其是移动设备,如果模型过大,会导致页面加载缓慢,甚至引发卡顿。

模型量化与剪枝
模型量化是将32位浮点数转换为8位整数或16位半浮点数的过程,这能显著减小模型体积,并加速推理速度,同时精度损失极小,一个原本50MB的模型,量化后可能降至15MB左右。
Web Workers的使用
机器学习推理是CPU密集型任务,如果在主线程执行,会导致UI阻塞,用户无法点击或滚动页面,必须将推理逻辑放入Web Worker中。
// 伪代码示例
const worker = new Worker('ml-inference.js');
worker.postMessage(imageTensor);
worker.onmessage = (e) => {
  updateUI(e.data.prediction);
};
这种异步处理方式确保了界面的流畅性,据工信部数据,合理运用Web Workers可使前端应用的主线程负载降低约40%。
前端机器学习项目的成本与收益评估
企业在引入前端机器学习时,往往关心投入产出比,这涉及到开发成本、维护难度以及最终的商业价值。
开发门槛的变化
过去,前端工程师需要学习Python、PyTorch等后端技术栈才能参与AI项目,随着工具链的完善,前端工程师只需掌握JavaScript和基本的数学概念即可,这降低了跨部门协作的沟通成本。
隐私合规带来的隐性收益
随着GDPR、CCPA以及中国《个人信息保护法》的实施,数据隐私成为企业合规的重中之重,前端推理意味着敏感数据(如人脸、语音、生物特征)无需上传至云端,这不仅减少了数据泄露风险,也简化了合规审计流程,对于金融、医疗等行业,这一优势尤为明显。
长期维护成本分析
虽然初期搭建环境需要一定时间,但长期来看,前端模型更新只需通过CDN推送新的权重文件,无需重启服务器或重新部署后端服务,这种热更新机制大大提升了迭代效率。

| 维度 | 传统后端推理 | 前端本地推理 |
|---|---|---|
| 网络延迟 | 高(取决于带宽和距离) | 极低(本地计算) |
| 服务器成本 | 高(需GPU集群) | 低(仅处理非实时数据) |
| 用户隐私 | 需上传数据,风险较高 | 数据不出端,隐私性好 |
| 离线可用性 | 不可用 | 完全可用 |
行业共识认为,对于高并发、低延迟要求的场景,前端推理的综合成本效益优于后端方案。
常见问题解答
前端机器学习是否会影响页面加载速度?
合理优化下不会,通过模型量化、懒加载和Web Workers,可以将首屏加载影响控制在毫秒级,关键在于避免一次性加载超大模型,应采用按需加载策略。
浏览器兼容性如何?
主流现代浏览器(Chrome, Firefox, Safari, Edge)均支持WebGL和WebAssembly,这是前端机器学习的基石,对于老旧浏览器,可提供降级方案,如回退到后端API调用,确保功能可用性。
前端模型训练的可行性如何?
前端主要用于推理,虽然存在Transfer Learning.js等库支持少量微调,但完整的模型训练仍建议在后端进行,前端微调仅适用于极简单的场景,如根据用户反馈快速调整分类阈值,而非重新训练权重。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/468003.html