Flume通过自定义Source组件或JDBC Sink反向拉取外部数据库数据,是实现结构化数据实时采集的主流方案,其核心优势在于与Hadoop生态的无缝集成及低延迟传输。
在大数据架构中,将传统关系型数据库(如MySQL、Oracle)中的数据迁移至HDFS或Hive仓库,是数据仓库建设的必经之路,Flume作为Apache旗下的日志采集系统,原本擅长处理非结构化日志,但通过扩展其Source或Sink模块,它也能高效处理结构化数据库数据,这种能力解决了传统ETL工具在实时性上的不足,特别是在需要近实时同步业务数据到数据湖的场景下,Flume展现出了独特的灵活性。


Flume采集数据库的核心架构与原理
理解Flume如何从数据库“拉”取数据,首先要明确其数据流向模型,Flume遵循Source-Channel-Sink的三段式架构,对于数据库采集,通常有两种主流实现路径:一是使用JDBC Source从数据库轮询增量数据;二是通过自定义Source连接数据库,将结果集转化为Event推入Channel。
业内专家指出,选择哪种路径取决于数据变更的频率和系统负载能力,大多数情况下,采用轮询机制(Polling)是最稳妥的方案,因为它不依赖数据库的Binlog解析,兼容性更强。
数据流向的关键组件解析
在配置Flume采集数据库时,每个组件都承担着特定的职责。
Source:数据的入口
Source负责连接外部数据库,常见的实现包括:
- JDBC Source:内置支持,需配置查询语句和增量字段。
- Custom Source:通过Java代码自定义连接逻辑,灵活性最高,适合复杂业务逻辑。
- Spooling Directory:虽主要用于文件,但可配合脚本将数据库导出为CSV后监控目录,适合离线批量场景。
Channel:数据的缓冲
Channel作为Source和Sink之间的桥梁,确保数据不丢失,对于数据库采集,推荐使用

Memory Channel以提升吞吐量,或在数据量大时使用File Channel以保证事务安全性。
Sink:数据的出口
Sink决定数据去向,若目标是HDFS,使用HDFS Sink;若目标是Hive,使用Hive Sink;若需写入其他数据库,则使用JDBC Sink进行反向写入。
实操指南:配置Flume JDBC Source
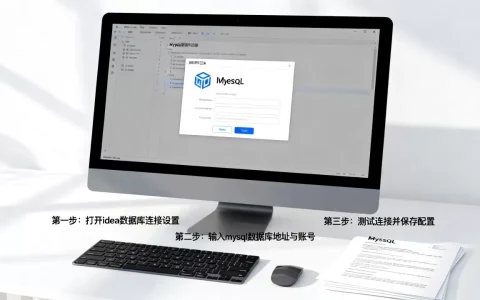
配置Flume采集MySQL数据是许多数据工程师面临的第一个技术挑战,以下以MySQL为例,展示标准配置流程。
环境准备与依赖安装
在开始之前,必须确保Flume环境已就绪。
- 下载并解压Flume安装包。
- 下载对应数据库版本的JDBC驱动jar包(如mysql-connector-java.jar)。
- 将jar包放入Flume的lib目录下,确保类路径正确加载。
配置文件编写详解
创建一个名为mysql-flume.conf的配置文件,内容如下:
# 定义组件名称
a1.sources = r1
a1.channels = c1
a1.sinks = k1
# 配置Source:JDBC Source
a1.sources.r1.type = org.apache.flume.source.jdbc.JdbcSource
a1.sources.r1.connection.url = jdbc:mysql://localhost:3306/mydb
a1.sources.r1.user = username
a1.sources.r1.password = password
a1.sources.r1.batch.size = 1000
a1.sources.r1.run.query.delay = 5000
a1.sources.r1.custom.query = SELECT id, name, create_time FROM users WHERE id > ${last.id}
a1.sources.r1.incremental.column.name = id
a1.sources.r1.start.from = 0
a1.sources.r1.custom.columns = id
# 配置Channel:Memory Channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 10000
a1.channels.c1.transactionCapacity = 1000
# 配置Sink:Console Sink(用于测试)
a1.sinks.k1.type = logger
# 绑定组件
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
关键参数解读
- custom.query:这是核心SQL语句,注意使用
${last.id}变量,Flume会自动跟踪并更新该变量,实现增量采集。 - incremental.column.name:指定用于判断增量的列,通常是自增ID或时间戳。
- run.query.delay:两次查询之间的等待时间,避免对数据库造成过高压力。
- batch.size:每次查询返回的最大行数,平衡内存占用与网络开销。

性能优化与常见问题排查
在实际生产环境中,直接套用模板往往会导致性能瓶颈或数据丢失,针对Flume采集外部数据库的性能调优,需要关注以下几个维度。
数据库端压力控制
频繁的全表扫描或复杂查询会拖垮源数据库。
- 索引优化:确保增量列(如ID或时间戳)上有索引。
- 分页查询:避免一次性加载百万级数据,合理设置
batch.size。 - 错峰执行:在业务低峰期进行大规模历史数据同步。
Flume端调优策略
- Channel选择:若数据量极大,Memory Channel可能因OOM崩溃,此时应切换为File Channel,虽然牺牲了部分吞吐量,但保障了数据可靠性。
- Sink批处理:对于HDFS Sink,适当增大
hdfs.batchSize可以减少NameNode的请求次数,提升写入效率。 - 多Source并行:对于高并发场景,可启动多个Flume Agent实例,分别采集不同表的数据,通过负载均衡器汇总。
常见错误与解决方案
| 错误现象 | 可能原因 | 解决方案 |
|---|---|---|
| 数据重复采集 | Flume重启后未正确记录offset | 使用File Channel持久化状态,或自定义Source实现断点续传 |
| 查询超时 | SQL语句复杂或缺少索引 | 优化SQL,添加索引,增加timeout配置 |
|
内存溢出 | batch.size设置过大 | 减小batch.size,增加JVM堆内存 |

Flume与其他采集工具对比分析
在选择数据采集方案时,开发者常纠结于Flume、Canal和Kafka Connect,了解它们的适用场景有助于做出正确决策。
Flume vs Canal
Canal基于MySQL Binlog解析,能够实现真正的实时同步,延迟极低,Canal仅支持MySQL,且需要解析Binlog,对数据库配置有要求,相比之下,Flume通过JDBC轮询,支持多种数据库,但存在秒级延迟,若对实时性要求极高且使用MySQL,Canal是更优选择;若需支持多源异构数据库,Flume更具通用性。
Flume vs Kafka Connect
Kafka Connect拥有更丰富的连接器生态,且与Kafka集成紧密,Flume则在Hadoop生态中拥有更深厚的根基,若数据最终目标是HDFS/Hive,Flume的配置更为简洁;若数据需经过Kafka进行解耦和缓冲,Kafka Connect的Debezium连接器可能是更好的起点。
Flume采集外部数据库的Q&A
Flume采集数据库支持哪些类型的数据库?
Flume通过JDBC Source支持任何提供标准JDBC驱动的数据库,包括MySQL、Oracle、PostgreSQL、SQL Server等,对于不支持JDBC的数据库,可通过编写自定义Source组件实现连接。
如何保证Flume采集数据的Exactly-Once语义?
Flume本身提供At-Least-Once(至少一次)语义,要实现Exactly-Once(精确一次),需结合使用File Channel持久化事务状态,并在Sink端实现幂等写入逻辑,在写入Hive时,使用INSERT OVERWRITE分区而非INSERT INTO,确保相同数据不会重复累积。
Flume采集数据库的延迟通常是多少?
延迟主要取决于run.query.delay配置和数据库查询耗时,默认配置下,延迟通常在几秒到几十秒之间,通过优化SQL查询、增加索引以及调整轮询间隔,可以将延迟控制在秒级以内,满足大多数近实时数据同步需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/473972.html