Hive处理日志的核心在于利用其列式存储和批处理能力,将非结构化或半结构化的日志数据转化为可查询的结构化表,从而实现高效的大规模数据分析。
为什么Hive是处理海量日志的首选方案
在大数据生态系统中,面对TB甚至PB级别的日志数据,传统的关系型数据库往往显得力不从心,Hive凭借其建立在Hadoop之上的数据仓库基础,提供了SQL风格的查询语言HiveQL,让熟悉SQL的分析师能够无缝接入大数据平台,业内专家指出,Hive通过MapReduce、Tez或Spark等执行引擎,将SQL语句转化为分布式计算任务,这种架构天然适合离线批处理场景。
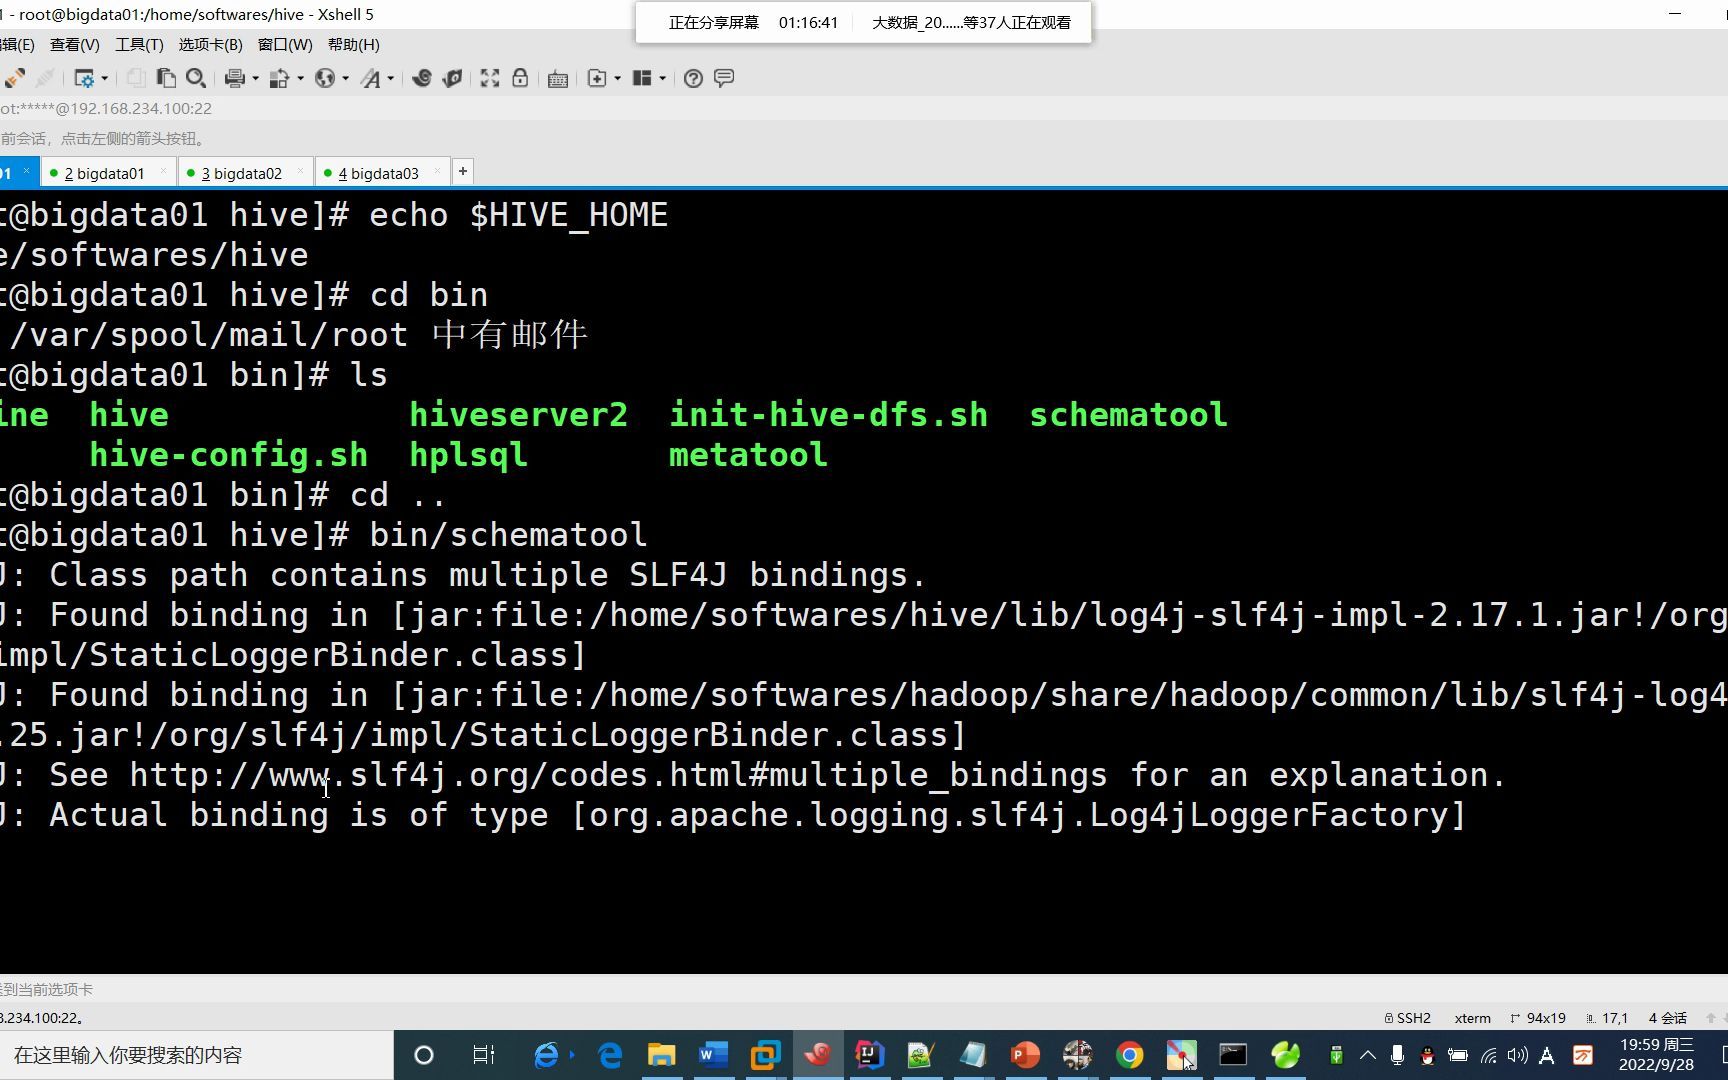
日志数据通常具有写入频繁、读取相对低频、结构复杂且数据量巨大的特点,Hive的列式存储格式(如ORC或Parquet)在读取特定字段时,只需扫描相关列而非整行数据,极大地减少了I/O开销,Hive支持多种压缩编码,进一步降低了存储成本并提升了网络传输效率,对于需要定期生成报表、进行用户行为分析或系统监控告警的场景,Hive提供了稳定且可扩展的解决方案。
对比传统数据库与Hive的性能差异
在选择技术方案时,明确Hive与传统数据库(如MySQL、Oracle)的边界至关重要,传统数据库擅长高并发、低延迟的事务处理(OLTP),而Hive专注于高吞吐量的联机分析处理(OLAP)。
- 查询延迟:传统数据库毫秒级响应,适合实时交互;Hive由于涉及分布式计算,查询延迟通常在分钟级甚至小时级,不适合实时性要求极高的场景。
- 数据更新:传统数据库支持高效的增删改操作;Hive对数据更新支持较差,通常采用追加写入或全表替换的方式,适合“写一次,读多次”的日志归档模式。
- 扩展性:

传统数据库垂直扩展成本高,水平扩展复杂;Hive基于Hadoop生态,可轻松横向扩展至数千台节点,处理海量数据。

Hive处理日志的核心操作流程
将原始日志接入Hive并非简单的复制粘贴,而是一个涉及数据清洗、格式转换和表结构设计的系统工程,以下是标准化的处理路径,帮助数据工程师快速上手。
第一步:数据接入与原始存储
原始日志通常以文本文件形式存在于HDFS或对象存储中,建议保留一份原始数据副本,命名为ods_log_raw,采用TextFile格式,不进行任何压缩或转换,以确保数据可追溯性,这一步是数据治理的基础,防止因清洗错误导致数据丢失。
第二步:数据清洗与ETL处理
原始日志往往包含大量噪声,如空行、特殊字符或格式错误,利用Hive的内置函数或自定义UDF(用户自定义函数)进行清洗,使用regexp_extract提取日志中的时间戳、IP地址和请求URL。
具体操作示例
假设日志格式为IP - - [time] "request" status size,可以通过以下SQL创建清洗后的中间表:
CREATE TABLE dwd_log_clean AS
SELECT
    ip,
    from_unixtime(unix_timestamp(time, 'dd/MMM/yyyy:HH:mm:ss'), 'yyyy-MM-dd HH:mm:ss') as log_time,
    request_url,
    status_code,
    response_size
FROM ods_log_raw
WHERE ip IS NOT NULL AND request_url IS NOT NULL;
第三步:选择高效的存储格式
为了提升后续查询性能,清洗后的数据应存储为列式格式,ORC(Optimized Row Columnar)是Hive推荐的格式,它结合了行存储和列存储的优点,支持谓词下推和索引,特别适合日志分析场景。
- ORC格式:压缩率高,查询速度快,支持事务,是大多数场景的首选。
- Parquet格式:与Spark生态兼容性更好,适合混合负载场景。
- 避免使用TextFile:除非为了保留原始数据,否则不要在分析层使用TextFile,其查询性能远低于列式格式。

优化Hive日志查询性能的实战技巧
随着日志数据量的增长,查询速度可能成为瓶颈,通过合理的分区、分桶和索引优化,可以显著提升查询效率。
分区策略:缩小扫描范围
日志数据通常具有明确的时间属性,按天或按月进行分区是最佳实践,创建表时指定PARTITIONED BY (dt STRING),在查询时始终带上WHERE dt = '2026-01-01'条件,Hive只会扫描对应分区的数据,避免全表扫描。
分桶策略:加速连接操作
如果日志表需要与其他维度表(如用户信息表)进行Join操作,且Join键分布均匀,可以考虑对日志表进行分桶,分桶数据在物理存储上是有序的,可以启用Map-side Join,减少Shuffle阶段的网络传输。
索引与缓存:提升交互体验
虽然Hive索引不如传统数据库灵活,但对于高频查询的字段,可以创建位图索引或哈希索引,对于热点数据,可以使用Hive缓存机制,将常用结果集存储在内存中,避免重复计算。
常见场景下的Hive日志分析实践
不同的业务场景对日志分析的需求各异,以下是几种典型场景的处理思路。
用户行为路径分析
通过分析用户点击流日志,还原用户访问路径,需要利用Hive的窗口函数(如LAG、LEAD)对同一用户的多次访问记录进行排序和拼接,进而计算转化率、跳出率等关键指标。
系统故障排查
当系统出现异常时,快速定位错误日志,可以通过正则表达式过滤包含

ERROR或Exception关键字的日志,并结合时间戳和堆栈信息,快速定位问题根源。
实时日志的离线补充
虽然Hive不适合实时处理,但可以与Kafka、Flume等实时采集工具结合,Flume将日志实时写入HDFS,Hive定期(如每小时)对新增数据进行处理和聚合,实现近实时的监控报表。
Q&A:Hive处理日志常见问题解答
Hive处理日志时如何处理JSON格式数据?
Hive内置了get_json_object函数,可以直接从JSON字符串中提取字段,对于复杂的JSON结构,建议使用json_tuple函数,它能一次性提取多个字段,性能优于多次调用get_json_object,Hive 2.2.0及以上版本支持原生JSON SerDe,可以直接将JSON文件作为Hive表的数据源,无需预先解析。
Hive处理日志的存储成本如何控制?
控制存储成本的关键在于压缩和生命周期管理,使用ORC格式并启用Snappy或Zlib压缩,通常能将数据体积缩小60%-80%,实施数据分层策略,将热数据(最近7天)存储在高性能存储介质,温数据(1-3个月)存储在标准存储,冷数据(3个月以上)迁移至低成本存储或归档,定期清理过期日志,避免无效数据占用资源。
Hive处理日志与Spark SQL相比哪个更适合?
两者各有优劣,选择取决于具体需求,Spark SQL基于内存计算,查询速度通常比Hive快数倍,适合交互式分析和迭代式算法,Spark SQL对集群资源要求较高,且缺乏Hive成熟的元数据管理和权限控制体系,Hive在数据仓库构建、复杂ETL流程和大规模离线批处理方面更具优势,且与Hadoop生态集成更紧密,多数情况下,企业会采用Hive作为底层数据仓库,Spark SQL作为上层加速引擎,两者互补使用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/474151.html