


FusionInsight Python开发的核心在于利用官方提供的HDInsight SDK或JDBC驱动,将Python脚本无缝嵌入华为大数据平台,实现从数据接入、清洗到模型训练的全链路自动化,其优势在于原生兼容Hadoop生态且具备企业级安全管控。
在2026年的企业级大数据架构中,Python早已不再仅仅是数据科学家的玩具,而是成为了连接业务逻辑与底层存储的关键纽带,对于许多正在从传统Hadoop集群向华为FusionInsight迁移的团队而言,如何高效地在Python环境中调用集群能力,是提升研发效率的关键痛点,业内专家指出,通过标准化的API接口而非复杂的命令行操作,可以将数据处理任务的开发周期缩短近半。

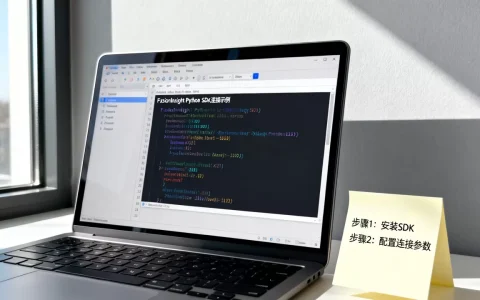
Python与FusionInsight集成环境搭建指南
想要玩转FusionInsight Python开发,第一步不是写代码,而是搞定环境,很多初学者容易在这里栽跟头,因为集群的安全认证机制比本地开发复杂得多。
依赖包管理与版本匹配
FusionInsight底层基于Hadoop、HBase、Kafka等组件,因此你的Python环境必须能够正确解析这些组件的协议。
- 核心依赖库:必须安装
pyhdfs用于HDFS操作,jaydebeapi用于JDBC连接数据库,以及华为提供的huawei-bigdata-sdk(如有)。 - 版本兼容性:确保你的Python版本为3.6及以上,虽然3.8+性能更好,但部分老旧的HBase客户端在3.9+可能存在兼容性问题,建议先在测试环境验证。
- 虚拟环境隔离:强烈建议使用
conda或venv创建独立环境,避免与系统级Python库冲突。
安全认证配置实战
FusionInsight默认开启Kerberos认证,这是阻碍Python脚本直接连接的最大门槛,你需要完成以下关键步骤:

- 获取Kerberos凭证:在提交任务的节点上,使用
kinit username命令获取Ticket。 - 配置文件路径:将集群提供的
krb5.conf和jaas.conf放置在你的项目根目录。 - 环境变量设置:在Python脚本启动前,设置
KRB5_CONFIG指向配置文件路径,确保Java底层库能正确加载。
核心组件Python开发场景解析
了解环境搭建只是基础,真正的价值体现在如何针对具体组件进行开发,不同组件的Python交互方式差异巨大,需采用不同的策略。
HDFS文件操作与数据管道
对于海量非结构化数据,HDFS是首选存储,Python通过 pyhdfs 或 hdfs3 库进行操作,速度极快且资源占用低。
高效读写示例
不要使用Python原生 open 函数逐行读取HDFS文件,这在处理GB级数据时会导致内存溢出,正确的做法是:
- 流式读取:使用
hdfs.read()获取文件对象,配合for line in file:进行迭代处理。 - 批量写入:使用
hdfs.write()并指定缓冲区大小,减少网络IO次数。 - 路径规范:始终使用绝对路径,格式为
hdfs://namenode:port/path/to/file。
HBase键值存储与实时查询
当业务需要毫秒级随机读写时,HBase是最佳选择,Python通过JDBC驱动连接HBase,虽然有一定延迟,但功能最全。
连接池优化技巧
由于JDBC连接建立成本高,务必在应用中实现连接池管理。

- 静态连接:在应用启动时初始化一个全局连接对象,避免每次查询都新建连接。
- 异常重试:网络抖动是常态,代码中需包含指数退避重试机制,通常重试3-5次。
- RowKey设计:Python端构造RowKey时,务必遵循集群设计的哈希前缀规则,防止热点。
Kafka消息队列集成
在实时数据流场景中,Python常作为生产者或消费者,华为FusionInsight Kafka支持SASL_PLAINTEXT或SSL加密传输。
消费者组配置
- 自动提交:开发阶段可开启
enable_auto_commit=True以简化调试。 - 手动提交:生产环境必须开启手动提交,确保消息处理成功后再标记偏移量,防止数据丢失。
- 反序列化:若数据为Avro格式,需安装
fastavro库,其解析速度比原生Avro快得多。
性能调优与常见陷阱规避
代码能跑通不代表能高效运行,在FusionInsight集群上,Python脚本的性能瓶颈往往不在算法本身,而在数据传输和序列化开销。
序列化格式选择
不同序列化格式对CPU和网络带宽的影响截然不同。
| 格式 | 体积 | 解析速度 | 适用场景 |
|---|---|---|---|
| JSON | 大 | 慢 | 调试、小数据量交互 |
| Avro | 小 | 快 | HDFS存储、HBase列族 |
| Protobuf | 最小 | 最快 | 高频实时消息、Kafka |
内存溢出预防
Python的垃圾回收机制在处理大规模数据集时可能滞后。
- 分块处理

:使用
pandas.read_csv(chunksize=10000)分块读取,避免一次性加载全量数据。 - 显式释放:在处理完大型DataFrame后,调用
del df并执行gc.collect()强制释放内存。 - 监控指标:密切关注YARN Container的内存使用率,若持续超过80%,需调整
spark.executor.memory或优化代码逻辑。

华为FusionInsight Python开发常见问题解答
FusionInsight Python SDK与开源Hadoop SDK有什么区别?
华为官方SDK针对FusionInsight的安全机制(如Kerberos、LDAP)进行了深度优化,内置了自动认证逻辑和集群拓扑感知功能,而开源SDK通常需要手动配置复杂的JAAS文件,且在多数据中心容灾场景下缺乏原生支持,对于生产环境,使用官方SDK能显著降低运维复杂度。
在FusionInsight上运行Python脚本的最佳实践是什么?
最佳实践是将Python脚本封装为Spark任务或Flink作业,而非直接在节点上运行孤立脚本,通过Spark Python API(PySpark),可以利用集群的分布式计算能力,将数据处理逻辑下发到各个Node执行,从而实现线性扩展。
FusionInsight Python开发的学习资源在哪里获取?
官方文档是最权威的来源,特别是“开发者指南”章节,华为云社区中有大量关于PySpark调优和HBase JDBC连接的实战案例,建议结合官方示例代码进行本地模拟测试,再逐步迁移至集群环境。
掌握FusionInsight Python开发并非难事,关键在于理解其安全机制与组件特性,通过合理选择SDK、优化序列化格式以及规范内存管理,开发者可以构建出既稳定又高效的大数据处理应用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/487114.html





评论列表(1条)
这篇文章说到点子上了,尤其是关于使用那段,我直接截图存了。话说回来有些地方还可以再深入,不过整体已经很顶了,赞一个。