服务器端PhysX的核心价值在于通过GPU加速实现高精度物理模拟,同时释放CPU资源处理其他逻辑,但部署时需根据场景权衡配置与成本。
服务器端物理引擎选型:PhysX与其他方案如何对比?
选择服务器端物理引擎时,你首先会面对PhysX、Havok、Bullet等选项,行业共识认为,PhysX在GPU加速方面走得最远,尤其适合大规模粒子、刚体碰撞和软体模拟。参考2

PhysX的GPU加速架构优势
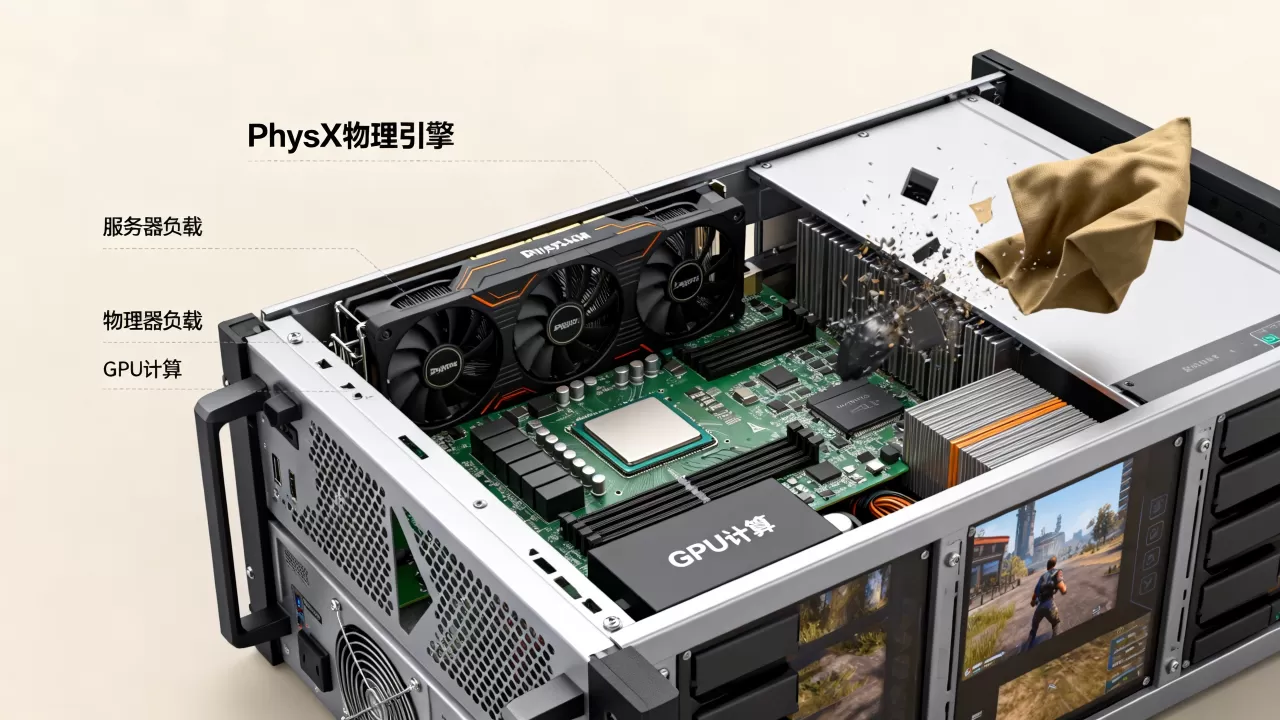
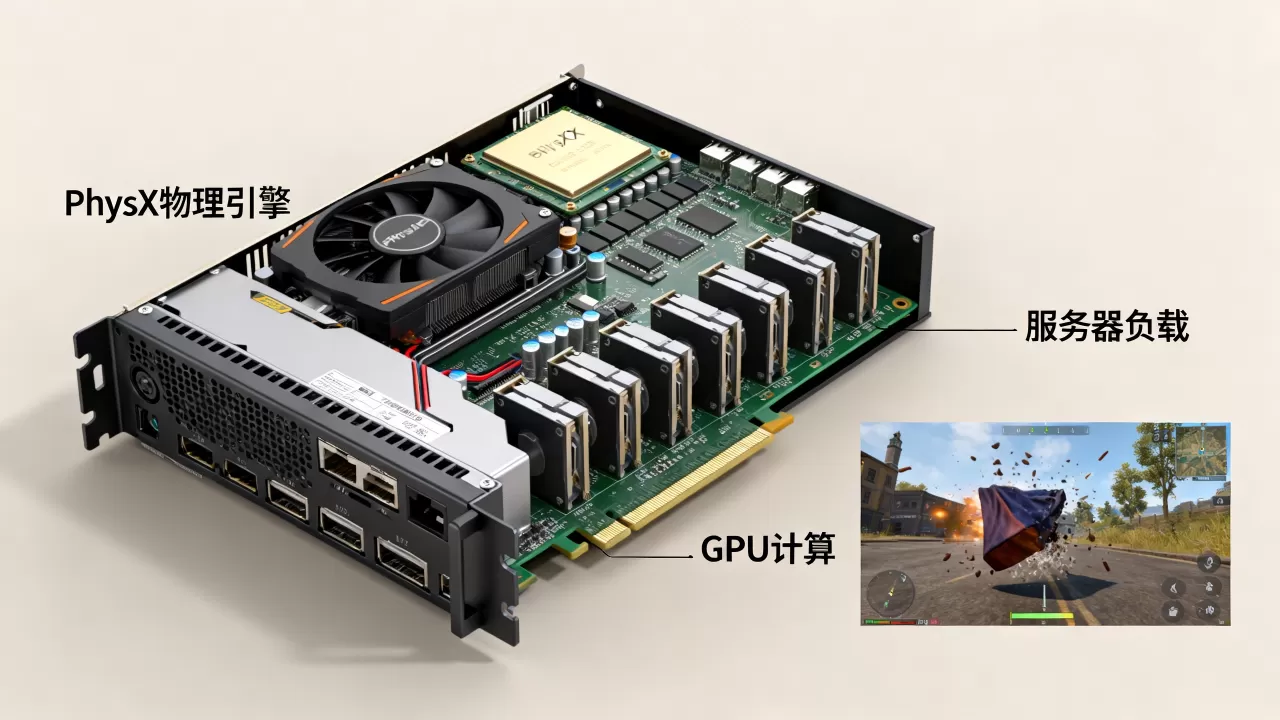
- 专用硬件支持:PhysX深度绑定NVIDIA GPU,利用CUDA核心处理物理计算,CPU负载极低,多数情况下,一块中端GPU可替代多核CPU完成物理任务。
- 场景扩展性:支持动态场景划分、连续碰撞检测,适合开放世界或高并发模拟,上千个碎片的实时破碎效果,CPU方案通常难以承受。
- 生态成熟度:PhysX SDK提供完整API,文档和社区资源丰富,调试工具齐全,Havok虽在CPU端表现稳定,但GPU加速能力有限;Bullet开源但缺乏官方优化,尤其在服务器端稳定性和性能上存在差距。
主流服务器端物理引擎对比概览
| 特性 | PhysX | Havok | Bullet |
|---|---|---|---|
| GPU加速 | 原生支持,效率高 | 有限,需额外扩展 | 第三方支持,不稳定 |
| 跨平台 | Windows、Linux、部分嵌入式 | 主机为主,PC次之 | 全平台,但优化不足 |
| 精度与稳定性 | 高,工业级验证 | 中高,游戏常用 | 中等,依赖使用者 |
| 社区与支持 | NVIDIA官方维护,更新频繁 | 商业授权,支持有限 | 开源社区,更新慢 |
如果你的服务器端需要实时物理模拟且GPU资源充足,PhysX是当前最成熟的选择,若CPU密集且预算有限,可考虑Havok或Bullet,但需接受性能上限。
服务器端PhysX性能优化:从硬件配置到代码调优
部署PhysX后,性能调优是关键,不合理的硬件或参数可能导致GPU利用率低下或物理卡顿,以下从硬件和软件两个层面给出具体建议。
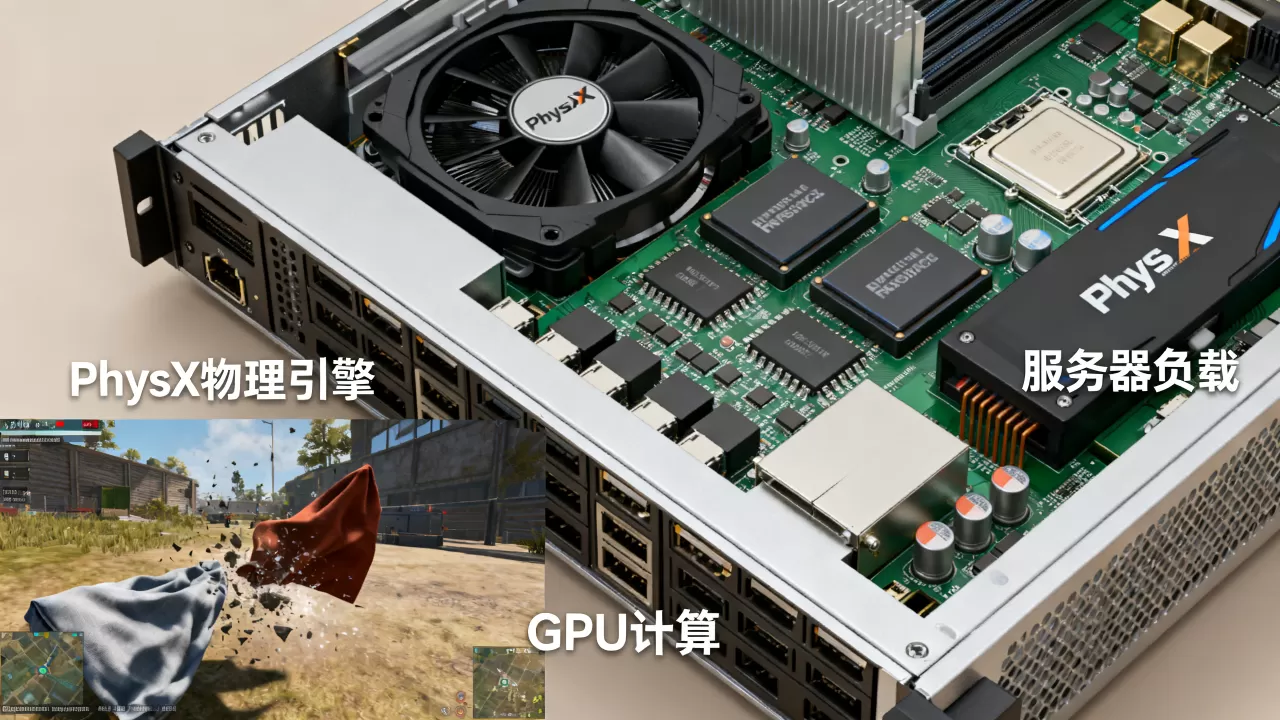
硬件配置要点:GPU型号与内存带宽
- GPU选型:优先考虑NVIDIA Quadro RTX、A系列或Tesla卡,RTX A6000在显存带宽和CUDA核心数上具有优势,适合大规模粒子模拟,消费级RTX 4090性价比高,但显存和ECC支持不如专业卡。
- 显存需求:单场景物理数据量通常在1-8GB之间,高精度模拟(如布料、流体)可能超过12GB,建议预留至少16GB显存,避免频繁换页。
- CPU与内存:物理场景的准备工作(如场景构建、碰撞对筛选)需要CPU配合,多核CPU(如AMD EPYC或Intel Xeon)可加速这些阶段,内存频率建议3200MHz以上,降低数据传输延迟。
软件调优技巧:场景划分与碰撞检测
- 场景空间划分:使用PhysX SDK中的
PxScene的setDynamicTreeRebuildRate和setNumThreads参数,将静态与动态物体分区域管理,减少碰撞检测范围。 - 碰撞检测优化:设置合理的碰撞组(
PxFilterData),避免无关物体之间产生碰撞计算,粒子与背景墙之间启用碰撞,但粒子之间可以忽略,除非需要粘性效果。 - GPU工作负载调整:通过
PxSceneDesc设置gpuDynamicsParticles和gpuCollision开关,如果场景中粒子数量少,可以关闭GPU碰撞,完全用CPU处理,减少传输开销。 - 异步执行:将物理模拟与渲染或逻辑处理分离,使用
PxScene::fetchResults和PxScene::simulate的异步模式,避免阻塞主循环。
典型场景下的性能参考
据业内专家指出,在4K粒子数量下,使用RTX A6000可以稳定在60fps以上,而CPU方案(如i9-13900K)仅能维持30fps,且CPU占用率超80%,实际生产中,建议对场景进行压力测试,逐步增加粒子数量或碰撞频率,找到GPU利用率接近80%的阈值。
云端物理模拟解决方案:成本与性能如何平衡?
如果服务器端使用云平台,你需要考虑GPU实例的选型与成本,云端物理模拟解决方案通常要求按需付费,但长期运行可以通过预留实例降低成本。
GPU云实例选型推荐
- NVIDIA GPU实例系列:AWS的G4dn(Tesla T4)、G5(A10G)、P4d(A100);简米云的gn6i(T4)、gn7i(A10);酷番云的GN10Xp(A100),T4适合中小规模场景,A10和A100适合高精度模拟。
- 显存与带宽:A10G显存24GB,带宽600GB/s,可应对复杂粒子系统,A100显存40GB,带宽更高,适合数千个刚体同时碰撞。
- 成本对比:G4dn实例每小时成本约0.5美元,G5为1.2美元,P4d超过3美元,如果你需要长期运行,预留实例(1年或3年)可节省30%-60%。
按需使用与预留实例的成本考量
- 按需实例:适合短期测试或流量波动大的场景,物理模拟只在高峰期调用,可以开自动缩放,成本可控。
- 预留实例:适合7×24小时运行的服务器,如大型多人在线游戏或仿真平台,预留实例需要预付部分费用,但总成本更低。
- 竞价实例:成本更低,但可能被中断,适合对实时性要求不高的离线批量物理计算。
国内主流云平台支持情况
国内简米云、酷番云、华为云均提供NVIDIA GPU实例,其中简米云gn7i支持A10G,性价比高,适合中小型物理模拟。酷番云GN10Xp使用A100,适合高端应用,实际部署时,建议先申请免费试用,测试物理场景在对应实例上的性能,再决定机型。参考2
物理加速服务器配置实操指南
以下步骤帮助你在Ubuntu 22.04上快速搭建PhysX服务器环境,并运行一个简单粒子示例。
环境准备与SDK安装
- 安装NVIDIA驱动和CUDA 12.x:从NVIDIA官网下载runfile,或使用包管理器,确保
nvidia-smi显示正确驱动版本。 - 安装PhysX SDK:从NVIDIA GitHub下载PhysX 5.0.0或更高版本,解压后,进入
physx/compiler目录,运行./generate_projects.sh生成Makefile。 - 编译SDK:
make -j$(nproc) release,编译完成后,库文件在physx/bin/linux.x86_64.profile。
配置物理场景参数
创建一个控制台应用,包含
PxFoundation、PxPhysics、PxPvd(用于调试),示例代码段:
PxDefaultErrorCallback errorCallback;
PxDefaultAllocator allocator;
PxFoundation foundation = PxCreateFoundation(PX_PHYSICS_VERSION, allocator, errorCallback);
PxPhysics physics = PxCreatePhysics(PX_PHYSICS_VERSION, foundation, PxTolerancesScale());
PxSceneDesc sceneDesc(physics->getTolerancesScale());
sceneDesc.gravity = PxVec3(0.0f, -9.81f, 0.0f);
sceneDesc.cpuDispatcher = PxDefaultCpuDispatcherCreate(2);
sceneDesc.filterShader = PxDefaultSimulationFilterShader;
PxScene scene = physics->createScene(sceneDesc);
设置PxSceneDesc的gpuDispatcher若需GPU加速,在GPU模式下,需要创建PxCudaContextManager并传入cudaContextManager。参考2
测试与性能调优
运行你的物理模拟循环,用PxScene::simulate和fetchResults,使用NVIDIA Nsight Systems或Nsight Compute分析GPU利用率,如果发现GPU占用低,增加粒子碰撞数量或启用PxSceneFlag::eENABLE_GPU_DYNAMICS标志,若CPU瓶颈,提高cpuDispatcher线程数或优化碰撞筛选。
服务器端PhysX常见问题解答
服务器端PhysX支持CPU回退吗?
支持,在PxSceneDesc中设置gpuDispatcher为nullptr,即可完全使用CPU模拟,但性能会显著下降,尤其当粒子数量超过数千时,建议在GPU不可用时启用CPU回退,并降低场景复杂度。
多GPU场景如何配置?
PhysX SDK本身不支持多GPU自动负载均衡,你需要手动划分场景到多个PxScene,每个场景绑定不同GPU,通过PxCudaContextManager选择特定设备,然后分场景执行模拟,最后合并结果,这种方式适合每个GPU处理独立物理区域,如分割世界地图。
物理模拟延迟是否会影响实时性?
是的,物理模拟本身需要时间,但通过异步执行和场景简化可以降低延迟,多数情况下,物理帧时间控制在8ms以内即可满足60fps需求,如果延迟过高,检查碰撞检测复杂度或场景粒子数量,尝试降低时间步长(如1/120秒)并启用子步功能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/527039.html