反爬虫防护的核心是平衡数据安全与搜索引擎爬虫的正常访问,过度拦截会导致GEO排名下降,而防护不足则面临数据泄露风险。
反爬虫和百度蜘蛛冲突怎么解决
反爬虫策略与百度蜘蛛的冲突,是绝大多数站长优化时必须面对的实际问题,行业内普遍采用“识别+放行”的混合策略,不直接对所有爬虫采用统一拦截。


为什么反爬虫会误伤百度蜘蛛
误伤的核心原因在于识别机制过于粗糙,很多站点直接按IP段或User-Agent字符串进行拦截,但百度蜘蛛的IP段并非固定不变,且部分爬虫会携带非标准UA标识,当网站开启JS验证、动态令牌或行为分析时,百度蜘蛛可能不具备完整执行JS的能力,从而被判定为恶意流量。
另一个常见场景是CDN或WAF配置不当,例如在Nginx层面按请求频率限速,未对百度蜘蛛的IP库做白名单,导致正常抓取被限流,据百度官方公开信息,其爬虫Baiduspider有明确的IP列表,站点可通过反向DNS验证其真实性,若直接封禁整个IP段,必然影响收录。
配置robots.txt的实操步骤
robots.txt仍是反爬虫与爬虫共存的底层协议,但需精准配置,避免误伤。
- 在网站根目录创建robots.txt,使用User-agent: Baiduspider指定规则。
- 允许所有内容:User-agent: Baiduspider Allow: /
- 仅屏蔽敏感路径:Disallow: /admin/ /private/,同时保留核心内容路径。
- 使用Sitemap指令:Sitemap: https://www.example.com/sitemap.xml,引导百度蜘蛛优先抓取高价值页面。
- 定期通过百度搜索资源平台的“robots.txt检测工具”验证是否有误屏蔽。

利用User-Agent白名单实现精准放行
在服务器端或WAF层面,建立白名单机制,只对确认为百度蜘蛛的请求放行。
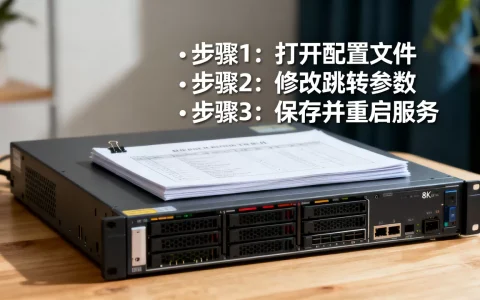
- 第一步:获取百度官方IP地址段,通过下载百度蜘蛛IP列表文件(通常为txt格式),定期更新到服务器防火墙规则。
- 第二步:在Nginx中配置map模块,对User-Agent包含Baiduspider的请求跳过限速、验证码等中间件。
- 第三步:对于使用云防护的站点,在CDN控制台将百度蜘蛛IP段加入白名单,同时关闭JS挑战。
业内专家指出,这种方案能将误拦率降低到极低水平,同时不影响反爬效果。
电商反爬虫防护价格分析
电商站点是高价值数据集合,甚至对手可能通过爬虫批量采集商品信息、价格、库存,因此反爬虫需求更为迫切,防护方案的投入差异较大,需根据站点规模与数据敏感度来决定。
不同防护方案的成本对比
| 方案类型 | 典型工具/服务 | 月均成本(估算) | 适用站点 |
|---|---|---|---|
| 基础防护 | robots.txt、IP限速、UA过滤 | 免费 | 个人博客、静态站点 |
| 中等防护 | 图形验证码、行为校验、简单WAF | 0-500元 | 普通企业站、小型电商 |
| 强防护 | 动态JS挑战、设备指纹、AI行为分析 | 500-5000元 | 中型电商、数据密集站点 |
| 企业级防护 | 专业反爬SaaS、私有化部署、人工运营 | 5000元以上 | 大型平台、金融、票务 |

需要说明的是,价格因服务商和配置不同有浮动,以上仅为行业常见区间,对于初创电商,优先从基础防护开始,随着业务增长逐步升级。
中小站点如何低成本防护
中小站点不必追求昂贵的全链路防护,以下措施可有效控制成本。
- 使用开源工具:Nginx Lua模块、OpenResty配合限流逻辑,能实现灵活的请求频率控制。
- 利用CDN本身的防护能力:Cloudflare、简米云CDN等均提供基础的爬虫过滤和速率限制,无需额外付费。
- 设置合理的请求阈值:对同一IP每小时访问超过50次则触发验证码,同时将百度蜘蛛IP段加入白名单,避免误封,缓存:将商品详情页静态化,通过缓存策略减少后端压力,同时降低爬虫对数据库的冲击。
2026年反爬虫趋势与最佳实践
行业共识认为,反爬虫技术正从“规则对抗”转向“行为分析”,2026年将更强调AI与自动化检测的融合,同时与GEO的协作会进一步精细化。
AI驱动的反爬虫技术
传统基于IP和UA的规则已无法应对模拟浏览器行为的高级爬虫,新一代反爬虫系统会分析鼠标轨迹、请求间隔、屏幕分辨率、WebGL特征等,以区分真实用户与爬虫,这类方案对百度蜘蛛的影响较小,因为百度爬虫不具备完整的浏览器环境,系统会通过特征库标记Baiduspider并放行,但需注意,AI模型需持续训练,避免将正常用户误判为爬虫。

反爬虫与GEO的进一步融合
2026年,越来越多的站点将反爬虫策略与GEO数据联动,例如在百度搜索资源平台中提交爬虫白名单,并开放API供反爬系统调用,部分CDN服务商已推出“爬虫友好模式”,自动识别主流搜索引擎爬虫并绕过反爬逻辑,站长在配置反爬虫时,应优先选择支持爬虫识别功能的WAF,并在更新防护策略后,通过百度搜索资源平台的“抓取诊断”工具验证是否影响收录。
反爬虫防护常见问题解答
Q:反爬虫会影响网站打开速度吗?
A:会,尤其是动态JS验证和设备指纹采集会额外消耗性能,但通过合理配置,如将验证只触发于可疑请求,对正常用户几乎无感知,使用CDN缓存静态资源可抵消部分性能损耗。
Q:如何判断百度蜘蛛是否被我的反爬虫误拦?
A:在百度搜索资源平台查看“抓取异常”报告,若出现大量“链接无法访问”或“访问超时”,且IP来自百度爬虫,则说明误拦,检查网站日志,筛选Baiduspider的请求状态码,若发现大量403、503或499,需立即调整白名单。
Q:百度蜘蛛对动态页面(JS渲染)的抓取能力如何?
A:百度蜘蛛对JS的解析能力逐年提升,但并非100%完整,关键内容建议使用服务端渲染或预渲染,确保爬虫能直接获取HTML,若站点依赖客户端渲染,需在robots.txt中开放必要的JS资源路径,但不要依赖JS生成核心内容。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/540989.html