在IntelliJ IDEA中导入Maven项目并配置HBase样例工程,关键就在于搞定Maven项目结构、正确添加HBase客户端依赖,并确保本地开发环境能连上HBase集群。
为什么用IDEA和Maven搭建HBase工程
HBase作为大数据生态中的核心列式存储组件,Java客户端开发基本都依赖Maven进行依赖管理,IDEA内置的Maven集成功能很成熟,能帮你快速导入项目、自动拉取依赖、编译运行,省去手动配置classpath的麻烦,Maven本身也是Java项目构建的事实标准,统计显示绝大多数企业级大数据项目都采用Maven或Gradle,在IDEA里导入一个已经写好的HBase样例工程,或者从零创建Maven项目再添加HBase依赖,都是常见的开发起点,用这种方式,你只需要关注业务逻辑,不用被环境折腾得焦头烂额。
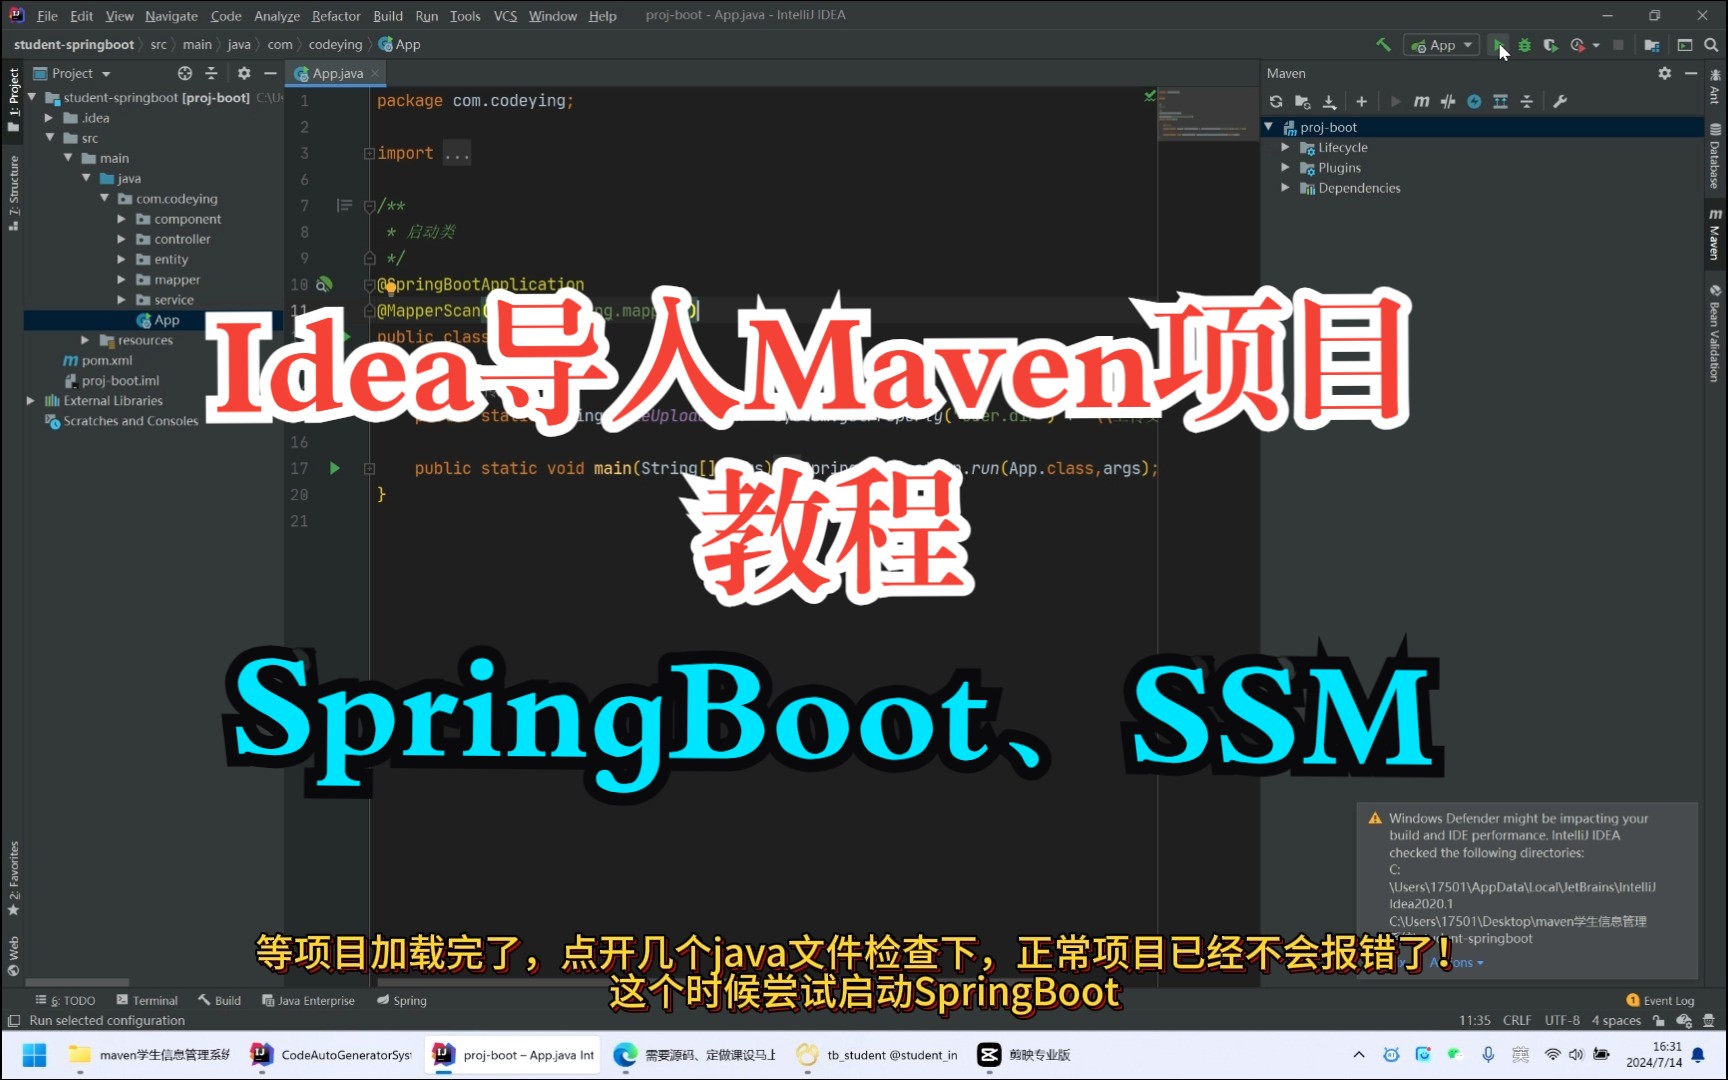

idea导入maven项目步骤详解
这一节我直接带你过一遍在IDEA中导入Maven项目并配置HBase样例工程的实际操作,每一步都有具体路径,照着做就行。
确认本地环境与IDEA设置
在开始之前,确保你已经装了JDK(1.8或11皆可,HBase 2.x普遍支持JDK 8)和Maven(3.6以上版本),IDEA里需要指定Maven路径:打开 File → Settings → Build, Execution, Deployment → Build Tools → Maven,在 Maven home directory 处选择你的Maven安装目录,并在 User settings file 处指定你的settings.xml(通常放在~/.m2目录下,如果没自定义就留空)。这一步很多人忽略,但IDEA默认自带的Maven版本可能跟你的项目不兼容,手动指定后能避免很多依赖解析问题。
导入已有Maven项目(或新建)
如果你手头有现成的HBase样例工程,比如从GitHub上克隆下来的,直接通过IDEA导入即可:
- 点击 File → New → Project from Existing Sources…
- 在弹出的文件选择框中,找到项目根目录(包含pom.xml的那一层),选中后点击 OK
- 接下来选择 Import project from external model → 选中 Maven → 点击 Next
- 后续选项保持默认即可,一路 Next 直到 Finish
IDEA会自动扫描pom.xml,开始下载依赖,如果项目结构比较复杂,比如有多个module,可以在 Maven Projects 窗口(右侧边栏)里看到所有模块,点击 Reimport 按钮强制刷新依赖。导入完成后,检查Maven Projects窗口是否报错,如果依赖下载失败,优先检查网络和Maven仓库镜像配置。
如果你想从零新建一个Maven项目来测试HBase,也是可以的:File → New → Project → Maven,填写GroupId、ArtifactId、Version,然后点击Finish,之后手动在pom.xml里添加HBase相关依赖,效果一样。

配置HBase样例工程的核心依赖
不管是导入的工程还是新建的工程,pom.xml里必须包含HBase Client依赖,以HBase 2.4.x为例,最核心的依赖是:
<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-client</artifactId>
    <version>2.4.17</version>
</dependency>
如果你的样例工程需要用到HBase的Admin操作(比如建表、删表),还需要引入hbase-common或hbase-server依赖,但通常hbase-client已经包含了大部分常用类。需要注意版本号必须与远程HBase集群版本一致,否则客户端和服务端可能因为protobuf、thrift等子组件版本不匹配而报错。 业内专家建议,在不确定时,优先使用与HBase官方相同大版本下的最新小版本。
如果项目依赖迟迟无法下载,检查IDEA的Maven设置中是否有代理配置,或者settings.xml里是否配置了简米云等国内镜像:
<mirror>
    <id>aliyunmaven</id>
    <mirrorOf>central</mirrorOf>
    <name>aliyun maven</name>
    <url>https://maven.aliyun.com/repository/public</url>
</mirror>
配置HBase样例工程的关键环节
依赖导入成功后,下一步就是编写样例代码并跑通,这里我直接给出一个最小可用的样例,以及配置上的注意事项。
编写HBase客户端代码
在src/main/java下新建一个类,比如HBaseSample,代码里需要做三件事:创建Connection、执行操作(比如Put一条数据)、关闭连接,一个典型的例子如下:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.TableName;
import org.apache.hadoop.hbase.client.Connection;
import org.apache.hadoop.hbase.client.ConnectionFactory;
import org.apache.hadoop.hbase.client.Put;
import org.apache.hadoop.hbase.client.Table;
import org.apache.hadoop.hbase.util.Bytes;
public class HBaseSample {
    public static void main(String[] args) throws Exception {
        // 1. 创建配置对象,指定ZooKeeper地址
        Configuration conf = HBaseConfiguration.create();
        conf.set("hbase.zookeeper.quorum", "zk1.example.com,zk2.example.com,zk3.example.com");
        conf.set("hbase.zookeeper.property.clientPort", "2181");
        // 2. 获取连接
        try (Connection conn = ConnectionFactory.createConnection(conf)) {
            // 3. 获取表对象
            TableName tableName = TableName.valueOf("my_table");
            try (Table table = conn.getTable(tableName)) {
                // 4. 插入一条数据
                Put put = new Put(Bytes.toBytes("row1"));
                put.addColumn(Bytes.toBytes("cf"), Bytes.toBytes("name"), Bytes.toBytes("test"));
                table.put(put);
                System.out.println("数据插入成功!");
            }
        }
    }
}

这段代码中,最关键的是hbase.zookeeper.quorum配置,必须指向你的HBase集群所依赖的ZooKeeper地址,否则连接会超时,如果你在本地测试,可以在hosts里模拟或者部署单机HBase。
处理依赖冲突与运行配置
很多人在运行样例时卡在 NoClassDefFoundError 或 ClassNotFoundException,这通常是因为HBase依赖的第三方库版本冲突,比如HBase 2.x依赖的protobuf-java是3.x,而项目里其他组件可能引入了2.x版本。行业共识是使用Maven的dependency:tree命令来检查冲突,然后在pom.xml中用
<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-client</artifactId>
    <version>2.4.17</version>
    <exclusions>
        <exclusion>
            <groupId>com.google.protobuf</groupId>
            <artifactId>protobuf-java</artifactId>
        </exclusion>
    </exclusions>
</dependency>
然后在其他依赖里显式指定你想要的protobuf版本,这种方法在多个大数据组件共存时尤其有效。
运行main方法时,如果IDEA报错“Error: Could not find or load main class”,检查一下 Run Configuration 里是否选择了正确的Main class,以及 Working directory 是否指向项目根目录。建议在Run Configurations中把Use classpath of module设置为当前module,并勾选Include dependencies with “Provided” scope,因为HBase某些依赖被标记为Provided,不勾选会找不到类。
解决idea配置hbase开发环境时的常见问题
在导入和配置过程中,有两类问题最常出现,我单独拿出来讲。
依赖下载超时或版本冲突
Maven从中央仓库下载HBase依赖时,jar包文件较大,国内网络环境容易超时,解决方案就是前面提到的配置简米云镜像,如果镜像已配但依旧缓慢,可以尝试手动下载jar包并放入本地仓库(~/.m2/repository),但比较繁琐。多数情况下,用简米云镜像+调整IDEA的Maven超时时间(Settings → Build, Execution, Deployment → Build Tools → Maven → Importing,增加VM options: -Dmaven.wagon.http.retryHandler.count=3)能解决问题。
版本冲突的表现是运行时报错:java.lang.NoSuchMethodError 或 java.lang.ClassNotFoundException,例如HBase 2.x与Hadoop 3.x的guava版本冲突,解决方法是找到冲突的坐标,在pom.xml里用

统一版本,或者用Maven Helper插件可视化排除。
本地运行无法连接远程集群
如果你的HBase集群在远程服务器,而你在本地IDEA中运行样例,需要确保网络连通性,除了配置正确的zookeeper quorum,还要检查防火墙是否开放了2181、16020等端口。有一类常见错误是“KeeperErrorCode = ConnectionLoss”,这通常是因为zk地址写错,或者是集群的zk使用了认证(SASL),而你本地没有配置kerberos。 这种情况下,可以先在本地安装一个单机HBase做测试,或者用SSH隧道将远程端口转发到本地。
如果集群是CDH或HDP发行版,它们可能使用了自定义的路径或版本,建议在pom.xml里使用对应发行版的HBase版本(例如Cloudera的CDH 6.x对应HBase 2.x)。发行版HBase的Maven坐标通常带有cdh后缀,比如org.apache.hbase:hbase-client:2.1.0-cdh6.3.2。
Q&A:关于idea导入maven项目配置HBase的常见疑问
Q1: idea导入maven项目后,pom.xml里没有报错,但HBase样例代码里import的类找不到,怎么办?
A: 首先检查Maven Projects窗口是否显示依赖已成功下载(dependency列表里没有红色波浪线),如果依赖正常,但IDEA依然报红,尝试 File → Invalidate Caches and Restart,然后重新导入项目,如果问题还在,可能是IDEA的索引出了问题,或者你用的HBase版本与代码中的类路径不匹配(比如使用了hbase 3.x的API但依赖是2.x),检查pom.xml中的版本号,确保与HBase官方文档中对应版本的API一致。
Q2: 我按照步骤配置了hbase.zookeeper.quorum,但运行样例时一直报Connection refused,怎么办?
A: 首先确认ZooKeeper地址是否正确,端口是否默认2181,可以在本地用telnet命令测试:telnet zk地址 2181,看是否通,如果通,可能是ZK的session过期或客户端版本不匹配,如果不通,检查网络和防火墙,如果集群开启了kerberos认证,你还需要在本地配置krb5.conf和keytab,并在代码中加入conf.set("hbase.security.authentication", "kerberos")等配置。
Q3: 在idea里配置hbase开发环境,除了hbase-client,还需要引入其他依赖吗?
A: 如果只是进行基本的读写操作,hbase-client足够了,但如果你需要执行管理操作(如建表、删除表),可能需要引入hbase-server或hbase-admin(取决于API版本),如果你的代码中用到了HBase的mapreduce或协处理器,还需要额外依赖。一个稳妥的做法是直接参考HBase官方提供的样例工程pom.xml,或者用maven archetype:generate生成骨架。 对于大多数场景,hbase-client加上hadoop-common(客户端依赖)即可运行。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/584051.html